
大模型原理与训练 / 系统课时
算清 KV Cache 容量边界
算清 KV Cache 容量边界
长上下文服务最容易先撞上的不是模型权重,而是随序列长度和并发持续增长的 KV Cache。本篇用一条可复算的公式算出单请求占用,再把剩余显存映射到并发上限,帮助你在压测前先判断容量边界。
学习目标
- 根据层数、KV 头数、head dimension、序列长度和数据类型计算单请求 KV Cache。
- 区分 MHA、GQA、MQA 对 KV Cache 大小的影响。
- 把单请求占用映射到可用显存预算和理论并发,并识别实际服务中的额外损耗。
先把单请求公式写对
自回归解码需要在每一层保存历史 token 的 Key 和 Value,所以最基本的估算式是:
其中 2 表示 K 与 V 两份缓存,L 是 Transformer 层数,H_kv 是 KV 头数,D 是每个头的维度,T 是当前缓存的 token 数,B 是每个元素的字节数。FP16/BF16 通常取 2 字节,8 位 KV 格式通常按 1 字节起算,但还应计入缩放元数据和实现开销。
这里最容易算错的是 H_kv。传统 MHA 中,KV 头数通常等于注意力头数;GQA 会让多个 Query 头共享一组 KV 头;MQA 则可能只有一个 KV 头。算 GQA/MQA 时继续代入 Query 头数,会把缓存高估数倍。
算一个可验证的容量例子
假设模型有 32 层、8 个 KV 头、head dimension 为 128,单请求最长 8192 token,KV Cache 使用 BF16。服务为 KV Cache 留出 40 GiB 显存,并额外保留 10% 安全余量。
from math import floor

layers = 32
kv_heads = 8
head_dim = 128
tokens = 8192
bytes_per_element = 2

kv_budget_gib = 40
reserve_ratio = 0.10

bytes_per_request = (
    2 * layers * kv_heads * head_dim * tokens * bytes_per_element
)
gib_per_request = bytes_per_request / (1024 ** 3)

usable_gib = kv_budget_gib * (1 - reserve_ratio)
max_concurrency = floor(usable_gib / gib_per_request)

print(f'KV per request: {gib_per_request:.2f} GiB')
print(f'Usable KV budget: {usable_gib:.2f} GiB')
print(f'Theoretical max concurrency: {max_concurrency}')
预期输出
KV per request: 1.00 GiB
Usable KV budget: 36.00 GiB
Theoretical max concurrency: 36
这 36 路是理论上限,因为程序只计算了 KV 主体。真实推理进程还需要模型权重、CUDA context、临时 workspace、激活峰值、调度元数据,以及分页 KV 的块粒度损耗。因此容量规划时应先从总显存中扣掉这些不可用于 KV 的部分,再对 KV 池本身保留余量。
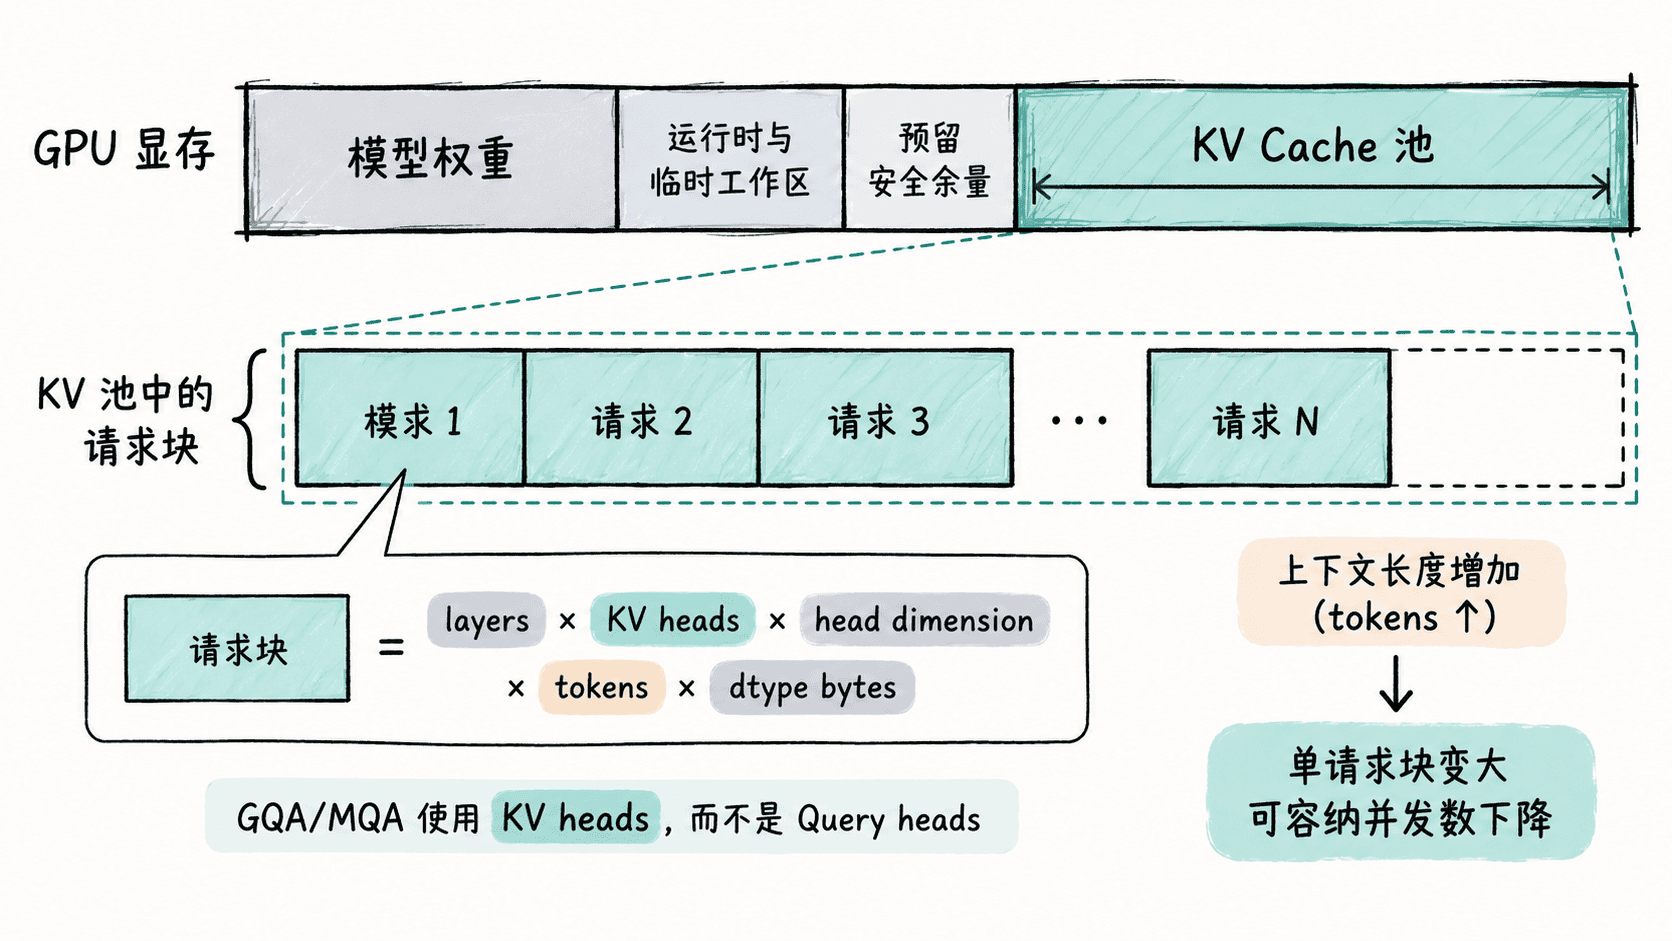
从单请求占用映射到并发
如果请求长度相同,可以用 floor(可用 KV 字节数 / 单请求 KV 字节数) 得到静态并发上限;如果长度不同,更准确的约束是把每个请求当前的 KV 占用求和,而不是统一按最大上下文计算。采用 paged attention 的引擎会按固定 block 分配,因此实际占用还会出现向上取整。
长上下文为什么危险,可以直接从公式看出:其他参数不变时,KV Cache 与 T 线性增长。上面的模型从 8192 token 提升到 32768 token,单请求就会从 1 GiB 增长到约 4 GiB,36 GiB 的 KV 预算理论上只剩 9 路同长度请求。若模型层数更多,或没有使用 GQA/MQA,下降会更快。
把估算变成上线前的容量检查
容量表至少要覆盖“短输入高并发”“中等上下文常态流量”和“最大上下文低并发”三类场景,并分别记录实际分配的 KV block、GPU 已用显存和请求吞吐。理论公式负责给出上界,压测负责校正碎片、预留和调度损耗。
只要先把“单请求占多少”算对,再明确“真正可给 KV 的显存还有多少”,长上下文服务的并发上限就不再是靠压测碰运气,而是一个可以提前估算、再用实测修正的容量问题。