
大模型原理与训练 / 系统课时
排查 OOM 与吞吐突降
排查 OOM 与吞吐突降
推理服务一旦出现 OOM、CUDA 错误、吞吐骤降或时延尖峰,最危险的做法是直接“调小一点参数”后继续上线。本节建立一条可复现的排查链:先固定请求与并发,再确认显存预算、KV Cache、碎片和通信状态,最后用最小实验验证修复是否稳定。
学习目标
- 按固定顺序区分容量不足、显存碎片、CUDA 异常与通信问题。
- 根据上下文长度、并发和批次上限判断 KV Cache 是否挤占显存。
- 用可重复的请求矩阵验证修复,而不是只观察一次成功请求。
先确定故障边界
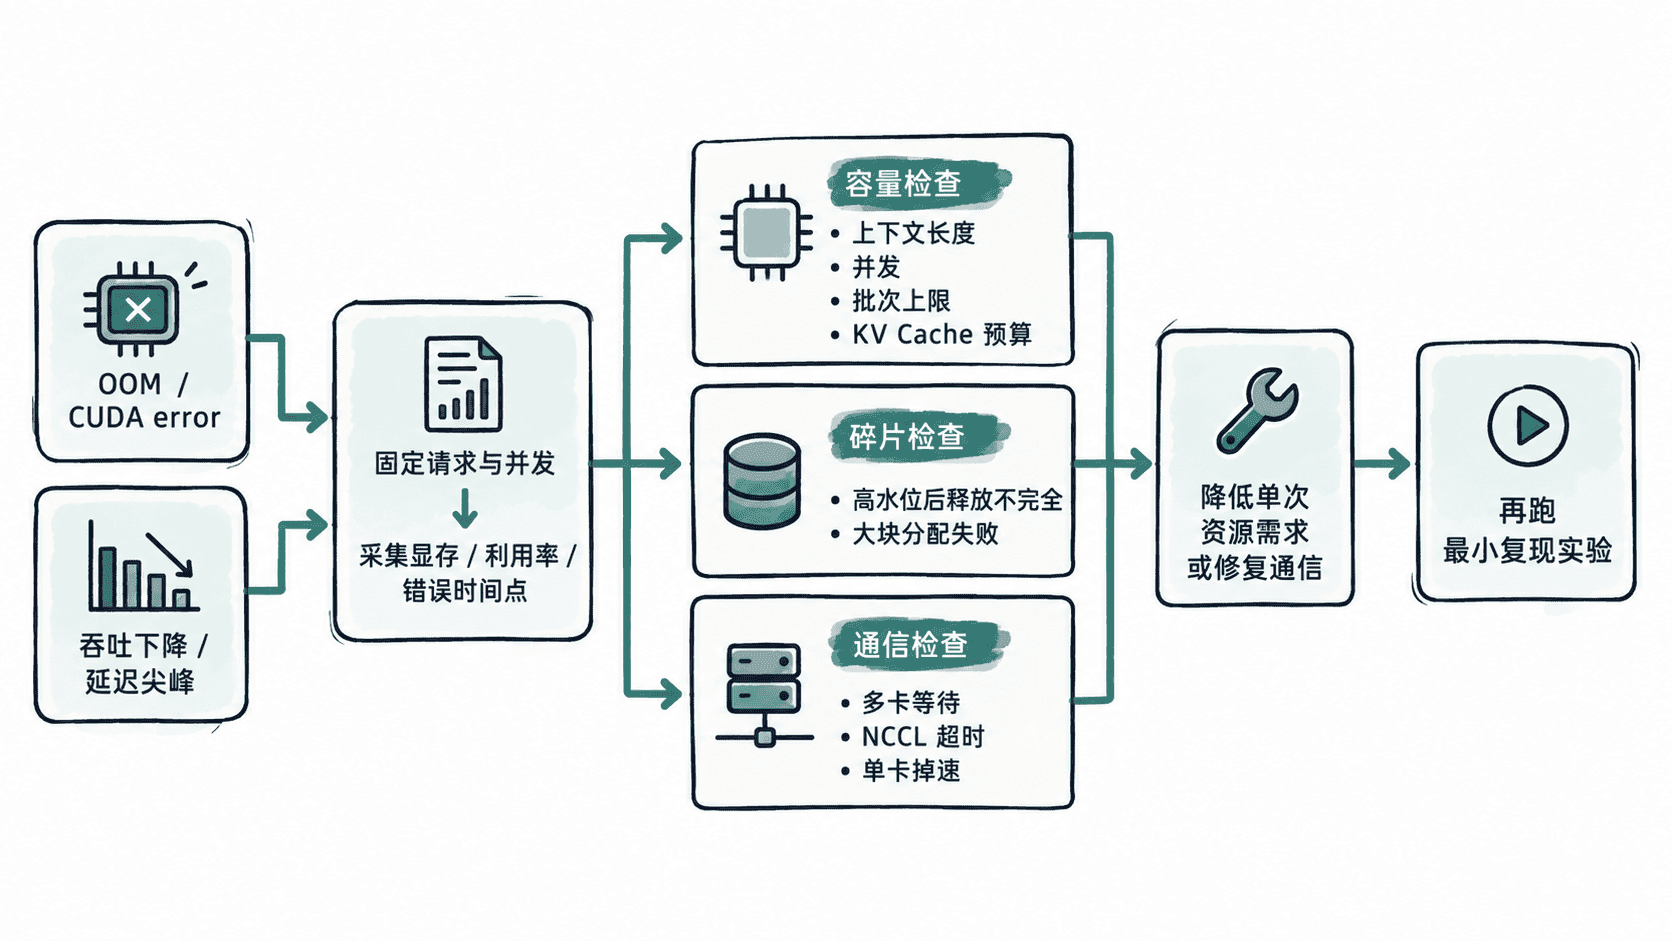
先把“什么时候开始坏”变成可比较的输入条件。至少记录模型版本、张量并行规模、上下文长度、输入与输出 token 上限、并发数、批次上限,以及故障前后的 GPU 显存占用和利用率。若只在长上下文或高并发下失败,优先怀疑容量与 KV Cache;若低负载也随机报错,再看 CUDA、驱动与硬件状态。
吞吐突降与时延尖峰也要区分。吞吐下降但 GPU 利用率持续很高,常见于批处理退化、长序列拖慢整批或通信等待;GPU 利用率同步下降,则要继续检查 CPU 供给、请求队列、跨卡通信和异常重试。
按证据链定位根因
容量问题先算“静态权重 + KV Cache + 临时张量 + 运行时余量”是否已经逼近显存上限。上下文越长、同时活跃的序列越多,KV Cache 越大;因此 max_model_len、最大并发序列数和批次 token 上限应联动调整,而不是只改其中一个。
若显存账面还有余量却在大块分配时 OOM,重点看碎片。典型特征是高峰后已释放一部分显存,但下一次相近请求仍无法申请连续大块。此时应先降低峰值批次、减少形状剧烈变化的请求混跑,并重新启动进程验证是否为长期运行后的碎片积累,而不是把更高的显存利用率阈值当成修复。
CUDA 错误要保留第一条原始报错,而不是只看后续连锁异常。非法内存访问、设备断言或驱动错误可能让当前进程进入不可继续信任的状态;修复后应重启进程再测。多卡场景若吞吐突然下降,还要比较各卡利用率和等待时间:单卡异常、链路抖动或 NCCL 超时重试都可能让所有 worker 一起变慢。
用最小复现实验验证修复
下面的脚本针对一个已运行的 OpenAI 兼容接口,自动读取模型 ID,并用可控的提示词长度和并发数发送请求。把 <PORT> 替换成实际端口;修复前后使用完全相同的两组参数,才能判断问题是否真的消失。
cat >/tmp/llm_probe.py <<'PY'
import json
import os
from concurrent.futures import ThreadPoolExecutor
from urllib.error import HTTPError, URLError
from urllib.request import Request, urlopen

server = os.environ["SERVER"].rstrip("/")
repeat = int(os.environ["PROMPT_REPEAT"])
concurrency = int(os.environ["CONCURRENCY"])

with urlopen(server + "/v1/models", timeout=10) as resp:
    model = json.load(resp)["data"][0]["id"]

payload = json.dumps({
    "model": model,
    "messages": [{"role": "user", "content": "hello " * repeat}],
    "max_tokens": 32,
    "temperature": 0
}).encode()

def call(_):
    req = Request(
        server + "/v1/chat/completions",
        data=payload,
        headers={"Content-Type": "application/json"},
        method="POST",
    )
    try:
        with urlopen(req, timeout=120) as resp:
            resp.read()
            return str(resp.status)
    except HTTPError as exc:
        return str(exc.code)
    except URLError:
        return "connection-error"

with ThreadPoolExecutor(max_workers=concurrency) as pool:
    codes = list(pool.map(call, range(concurrency)))

print(f"model={model}")
print(f"concurrency={concurrency} prompt_repeat={repeat}")
print("status_codes=" + ",".join(codes))
PY

SERVER="http://127.0.0.1:<PORT>" PROMPT_REPEAT=256 CONCURRENCY=1 python /tmp/llm_probe.py
SERVER="http://127.0.0.1:<PORT>" PROMPT_REPEAT=1536 CONCURRENCY=8 python /tmp/llm_probe.py修复后的预期输出如下,<MODEL> 和实际端口会因环境而不同:
model=<MODEL>
concurrency=1 prompt_repeat=256
status_codes=200
model=<MODEL>
concurrency=8 prompt_repeat=1536
status_codes=200,200,200,200,200,200,200,200
若基线请求稳定而压力组仍失败,就继续沿容量链路缩小范围:先固定并发、逐步增加上下文,再固定上下文、逐步增加并发。若两组都随机失败,则优先排查 CUDA 进程状态、驱动或通信,而不是继续缩小批次。
判断修复是否真的生效
一次返回 200 只能证明“这一次没失败”。最终验收应同时满足:相同请求矩阵连续运行不再 OOM;吞吐和延迟恢复到故障前的稳定区间;显存高水位不持续抬升;多卡利用率不长期失衡;服务重启后结果仍能复现。只有这些证据一致,才说明修复的是根因,而不是暂时避开了触发条件。