
大模型原理与训练 / 系统课时
用灰度发布验证新模型版本
用灰度发布验证新模型版本
新模型或新推理引擎即使离线评测通过,也可能在真实请求下出现错误率、TTFT、TPOT 或 GPU 成本回退。本节把稳定版本和灰度版本拆成独立实例池,用小流量逐级放量,并让质量与性能指标成为自动晋级或回滚的门槛。
学习目标
- 用独立 stable/canary 实例池限制新版本的故障半径。
- 同时比较质量、错误率、TTFT、TPOT 与单位 GPU 成本,而不是只看健康检查。
- 用渐进流量和自动分析条件控制放量,在指标退化时恢复稳定版本承接流量。
把新版本隔离成独立实例池
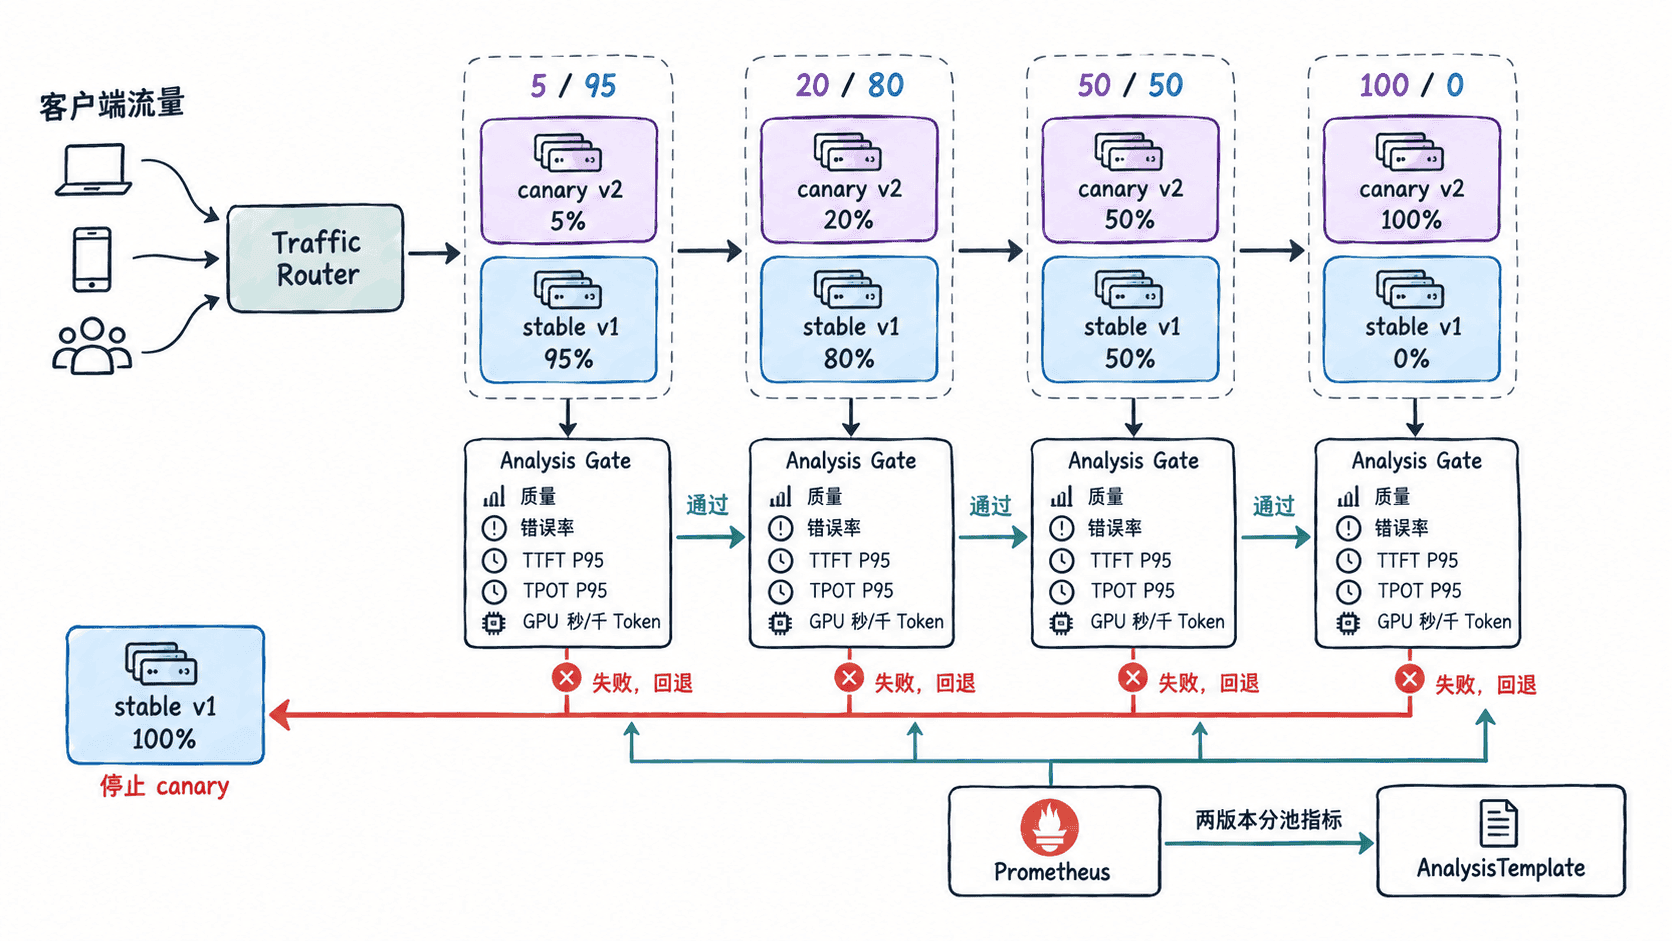
灰度发布的核心不是“同时跑两个镜像”,而是让两个版本的容量、路由和观测可以独立区分。稳定池继续承接绝大多数生产流量,灰度池只接收明确比例的请求;Prometheus 指标也必须能按 pool=stable 与 pool=canary 切开,否则两边数据混在一起,就无法判断退化来自新版本还是整体流量变化。
在 Kubernetes 中可用 Argo Rollouts 管理 stable 与 canary ReplicaSet,再由 Istio、Gateway API 或其他受支持的流量路由器执行权重分流。发布过程中,流量权重和 Pod 数量应分开理解:5% 流量不等于只能启动 5% 的 Pod。对于大模型服务,低流量阶段仍可给灰度池保留至少 1~2 个预热完成的 GPU Pod,避免因为单 Pod 冷启动或排队把灰度指标人为放大。
先定义能自动判定的门槛
只设置“Pod Ready”远远不够。模型版本的门禁至少覆盖五类结果:质量不能明显低于稳定版,5xx 或推理异常率不能上升,TTFT 与 TPOT 不能显著变慢,单位输出 Token 的 GPU 消耗不能失控。自动化门槛最好比较 canary 与 stable 的相对变化,这样能减少整体流量形态变化带来的误判。
质量指标通常来自抽样请求的在线判分、规则校验或异步评测流水线。若质量结果需要几十分钟甚至更久才能稳定产出,就不要伪装成秒级自动指标,应把它作为人工晋级门槛;自动分析只负责错误率、时延和成本等能及时观测的信号。
配置渐进放量和自动回滚
下面是片段示例:它假设命名空间 inference 已安装 Argo Rollouts,存在 llm-stable、llm-canary 两个 Service,以及名为 llm-routing、路由名为 primary 的 Istio VirtualService。Prometheus 还需提前把应用与 GPU 指标归一化为 pool=stable|canary 标签。示例把 5%、20%、50% 三个阶段都接上同一套分析门禁。
apiVersion: argoproj.io/v1alpha1
kind: AnalysisTemplate
metadata:
  name: llm-canary-gates
  namespace: inference
spec:
  metrics:
    - name: quality-ratio
      interval: 1m
      count: 5
      failureLimit: 2
      successCondition: result[0] >= 0.99
      provider:
        prometheus:
          address: http://prometheus.monitoring.svc:9090
          query: |
            (
              sum(rate(llm_quality_pass_total{pool="canary"}[5m]))
              / clamp_min(sum(rate(llm_quality_checked_total{pool="canary"}[5m])), 0.001)
            )
            /
            clamp_min(
              sum(rate(llm_quality_pass_total{pool="stable"}[5m]))
              / clamp_min(sum(rate(llm_quality_checked_total{pool="stable"}[5m])), 0.001),
              0.001
            )
    - name: error-rate-delta
      interval: 1m
      count: 5
      failureLimit: 2
      successCondition: result[0] <= 0.005
      provider:
        prometheus:
          address: http://prometheus.monitoring.svc:9090
          query: |
            (
              sum(rate(llm_request_errors_total{pool="canary"}[5m]))
              / clamp_min(sum(rate(llm_requests_total{pool="canary"}[5m])), 0.001)
            )
            -
            (
              sum(rate(llm_request_errors_total{pool="stable"}[5m]))
              / clamp_min(sum(rate(llm_requests_total{pool="stable"}[5m])), 0.001)
            )
    - name: ttft-ratio
      interval: 1m
      count: 5
      failureLimit: 2
      successCondition: result[0] <= 1.10
      provider:
        prometheus:
          address: http://prometheus.monitoring.svc:9090
          query: |
            histogram_quantile(0.95, sum by (le) (rate(llm_ttft_seconds_bucket{pool="canary"}[5m])))
            /
            clamp_min(histogram_quantile(0.95, sum by (le) (rate(llm_ttft_seconds_bucket{pool="stable"}[5m]))), 0.001)
    - name: tpot-ratio
      interval: 1m
      count: 5
      failureLimit: 2
      successCondition: result[0] <= 1.10
      provider:
        prometheus:
          address: http://prometheus.monitoring.svc:9090
          query: |
            histogram_quantile(0.95, sum by (le) (rate(llm_tpot_seconds_bucket{pool="canary"}[5m])))
            /
            clamp_min(histogram_quantile(0.95, sum by (le) (rate(llm_tpot_seconds_bucket{pool="stable"}[5m]))), 0.001)
    - name: gpu-cost-ratio
      interval: 1m
      count: 5
      failureLimit: 2
      successCondition: result[0] <= 1.10
      provider:
        prometheus:
          address: http://prometheus.monitoring.svc:9090
          query: |
            (
              sum(rate(llm_gpu_seconds_total{pool="canary"}[5m]))
              / clamp_min(sum(rate(llm_output_tokens_total{pool="canary"}[5m])), 1)
            )
            /
            clamp_min(
              sum(rate(llm_gpu_seconds_total{pool="stable"}[5m]))
              / clamp_min(sum(rate(llm_output_tokens_total{pool="stable"}[5m])), 1),
              0.000001
            )
---
apiVersion: argoproj.io/v1alpha1
kind: Rollout
metadata:
  name: llm-serving
  namespace: inference
spec:
  replicas: 8
  selector:
    matchLabels:
      app: llm-serving
  template:
    metadata:
      labels:
        app: llm-serving
    spec:
      containers:
        - name: server
          image: registry.example.com/llm-serving:model-v2
          ports:
            - name: http
              containerPort: 8000
  strategy:
    canary:
      stableService: llm-stable
      canaryService: llm-canary
      trafficRouting:
        istio:
          virtualService:
            name: llm-routing
            routes:
              - primary
      steps:
        - setWeight: 5
        - pause:
            duration: 5m
        - analysis:
            templates:
              - templateName: llm-canary-gates
        - setWeight: 20
        - pause:
            duration: 5m
        - analysis:
            templates:
              - templateName: llm-canary-gates
        - setWeight: 50
        - pause:
            duration: 5m
        - analysis:
            templates:
              - templateName: llm-canary-gates
        - setWeight: 100
registry.example.com/llm-serving:model-v2 是部署占位,实际使用时必须替换成已推送且集群可拉取的新模型或新引擎镜像。三个 pause 用来先积累一段真实样本,再启动 5 次、每次间隔 1 分钟的分析;任一指标累计达到失败上限,AnalysisRun 会失败,Rollout 不再继续放量并回到稳定版本承接流量。
首次创建这两个资源时执行:
kubectl create -f llm-canary.yaml预期输出:
analysistemplate.argoproj.io/llm-canary-gates created
rollout.argoproj.io/llm-serving created
发布开始后应在 Argo Rollouts 的 watch 视图中观察当前权重、分析阶段和 stable/canary ReplicaSet。生产验证时还应在 Grafana 或同类面板上同时画出两池曲线,避免只依赖控制器的最终状态。
处理自动回滚与人工止损
自动回滚条件应优先绑定不可接受的退化,而不是细小噪声。例如错误率相对 stable 增加超过 0.5 个百分点、TTFT 或 TPOT 高出 10%、单位 Token GPU 成本高出 10%,都可以作为明确门槛;具体数字仍要按业务 SLO 和压测基线调整。质量门槛则要先确认样本量足够,否则 5% 流量阶段可能因样本稀疏产生假失败。
如果监控已经确认新版本有严重故障,不必等待分析次数耗尽。可以执行:
kubectl argo rollouts abort llm-serving -n inference预期结果:当前发布停止继续推进,稳定 ReplicaSet 重新承接生产流量;CLI 的具体状态文本会随插件版本变化,因此应以 Rollout 状态和实际路由权重为准。
手工 abort 会停止当前发布并让稳定 ReplicaSet 恢复承接流量,但 Git 或其他期望状态仍应回退到稳定镜像版本,否则后续同步可能再次尝试发布新版本。灰度成功的验收标准也不应只是“100% 已切换”,而是切换后再持续观察一个完整业务窗口,确认质量、错误率、TTFT、TPOT 和 GPU 成本都没有出现延迟退化。