
大模型原理与训练 / 系统课时
用分块预填充平滑长提示
用分块预填充平滑长提示
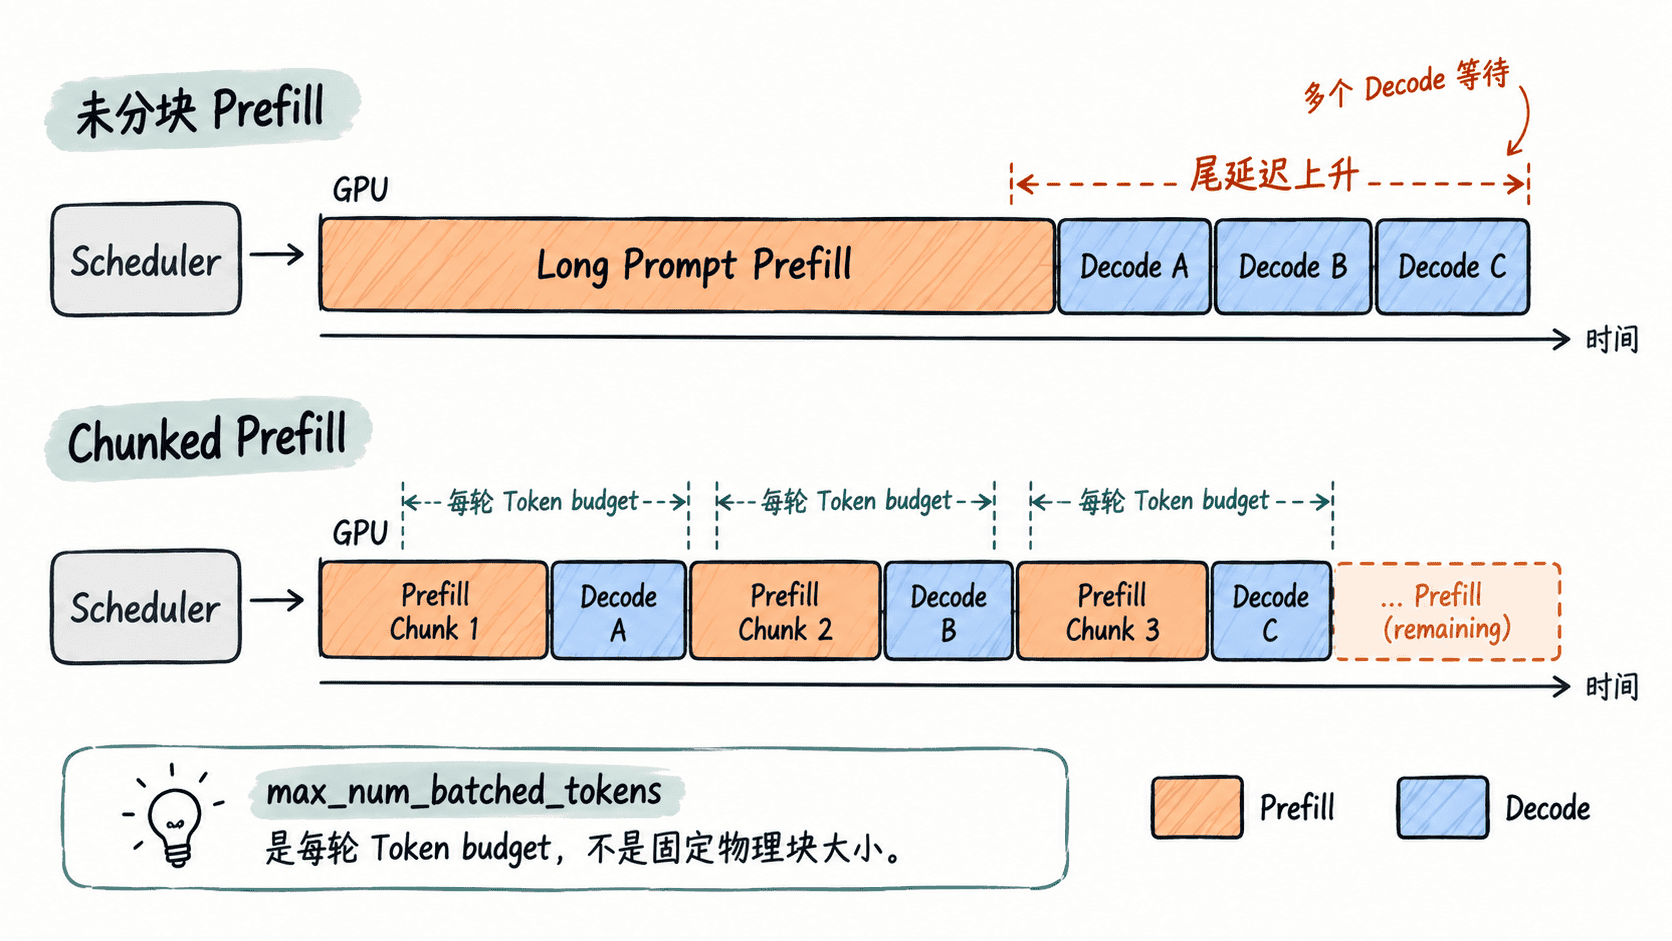
长 Prompt 的 Prefill 会一次吞掉大量算力,容易让已经进入 Decode 的请求等待,造成交互卡顿和尾延迟抬升。分块预填充把长 Prefill 拆进多个调度轮次,与 Decode 交错执行。本节用 vLLM 设置 Token 预算,并通过固定负载比较 TTFT、P99 延迟和吞吐。
学习目标
- 解释长 Prefill 为什么会阻塞 Decode,以及分块后调度顺序发生什么变化。
- 用
--max-num-batched-tokens控制每轮可调度 Token 预算,而不是误把它理解成固定块长。 - 在相同负载下比较不同预算的 TTFT、P99 E2E/ITL 与吞吐,选出符合目标 SLO 的配置。
长 Prefill 为什么会拖慢 Decode
Prefill 通常一次处理大量 Prompt Token,计算密度高;Decode 每个请求每轮只产生少量新 Token,更依赖低延迟调度。若一个超长 Prompt 在单轮里占用过多计算,其他正在生成的请求就可能等它完成,最终表现为 ITL 抖动和 P99 延迟恶化。
分块预填充会先安排待执行的 Decode,再把本轮剩余 Token 预算分给 Prefill。长 Prompt 放不下时只处理一部分,下一轮继续,因此 Prefill 与 Decode 可以在时间线上交错,而不是由一个长请求连续霸占多个计算阶段。
开启分块并设置每轮预算
下面把每轮最大调度 Token 数设为 4096。对于比剩余预算更长的 Prefill,调度器会把它拆开;实际每一块能拿到多少 Token,还取决于该轮已经安排了多少 Decode,因此 max_num_batched_tokens 是调度预算,不是“每块固定 4096 Token”。
# 显式开启分块 Prefill,并固定每轮 Token 预算。
MODEL=Qwen/Qwen2.5-0.5B-Instruct
vllm serve "$MODEL" --host 127.0.0.1 --port 8000 --enable-chunked-prefill --max-num-batched-tokens 4096
预期结果:
服务成功启动并监听 127.0.0.1:8000;长 Prompt 可以按当前轮次剩余 Token 预算拆分 Prefill。较小预算会让长 Prefill 被切得更细,为 Decode 留出更多调度机会;较大预算减少 Prefill 轮次,通常更有利于长 Prompt 尽快完成首 Token 前的计算。两者没有脱离负载的统一最优值。
用同一负载比较配置
先固定模型、输入长度、输出长度、请求速率和并发,只改变服务端的 --max-num-batched-tokens。例如依次用 2048、4096、8192 重启服务,每次都运行下面同一条基准命令。
# 固定长输入、短输出和请求速率,只让服务端 Token 预算变化。
# 输出 P99 TTFT、ITL 与 E2EL,同时观察首 Token 和尾延迟。
MODEL=Qwen/Qwen2.5-0.5B-Instruct
vllm bench serve --backend openai-chat --model "$MODEL" --endpoint /v1/chat/completions --dataset-name random --random-input-len 8192 --random-output-len 128 --num-prompts 100 --request-rate 8 --max-concurrency 16 --host 127.0.0.1 --port 8000 --percentile-metrics ttft,itl,e2el --metric-percentiles 99
预期输出中的数值取决于硬件和模型,至少记录下面几项:
Successful requests:                     100
Request throughput (req/s):              <VALUE>
Output token throughput (tok/s):         <VALUE>
Mean TTFT (ms):                          <TIME>
P99 TTFT (ms):                           <TIME>
P99 ITL (ms):                            <TIME>
P99 E2EL (ms):                           <TIME>
为了让 A/B 有意义,每轮都应使用相同参数和稳定环境。若同时开启 Prefix Cache,重复运行同一随机种子可能复用已缓存前缀,从而污染对分块策略的判断;此时应重启服务、清空缓存或改变基准种子。
从指标选择 Token 预算
不要只优化平均 TTFT。交互式服务更关心 P99 ITL 和 P99 E2EL,因为它们能暴露长 Prefill 是否仍在挤压正在 Decode 的请求;批处理服务则可以容忍更高尾延迟,以换取更高的总 Token 吞吐。
| 观察结果 | 更可能的动作 |
|---|---|
| P99 ITL 很高,Decode 明显抖动 | 适当减小 max_num_batched_tokens,让长 Prefill 更细地穿插 |
| 长 Prompt 的 TTFT 过高,但 ITL 仍有余量 | 适当增大预算,减少 Prefill 被切分的轮次 |
| 吞吐下降且 GPU 经常吃不满 | 增大预算或并发,再复测尾延迟 |
| TTFT、ITL、吞吐都恶化 | 检查并发上限、KV Cache 压力和请求长度分布,问题未必来自分块本身 |
最终配置应由真实请求长度分布和 SLO 决定。一个可用的选择标准是:先满足 P99 TTFT、P99 ITL 或 P99 E2EL 的硬约束,再在满足约束的候选值中选择吞吐最高者;这样得到的是面向目标负载的预算,而不是脱离场景的“最佳块大小”。