
计算机视觉 / 系统课时
排查部署结果偏差
排查部署结果偏差
同一份 YOLOv8 权重在不同推理后端出现框数量、类别或坐标差异时,应沿输入、预处理、模型输出和后处理逐层对齐。本课给出可重复的定位顺序,帮助你确认偏差究竟来自模型还是部署逻辑。
学习目标
- 建立不同推理后端之间可比较的基准输入与输出。
- 检查输入尺寸、归一化、类别映射、阈值和 NMS 配置。
- 使用诊断脚本区分预处理差异与后处理差异。
建立可比基线与定位顺序
不要直接比较两套服务的最终截图,因为图片解码、缩放和绘制都可能引入额外变量。应固定同一张原始图片、同一模型文件、同一精度模式,并分别保存预处理张量、原始模型输出和最终检测结果。
第一次对照建议关闭动态批次,固定 batch=1,同时记录输入张量的形状、数据类型、最小值、最大值和通道顺序。只有这些条件一致,后续比较置信度和坐标才有意义。
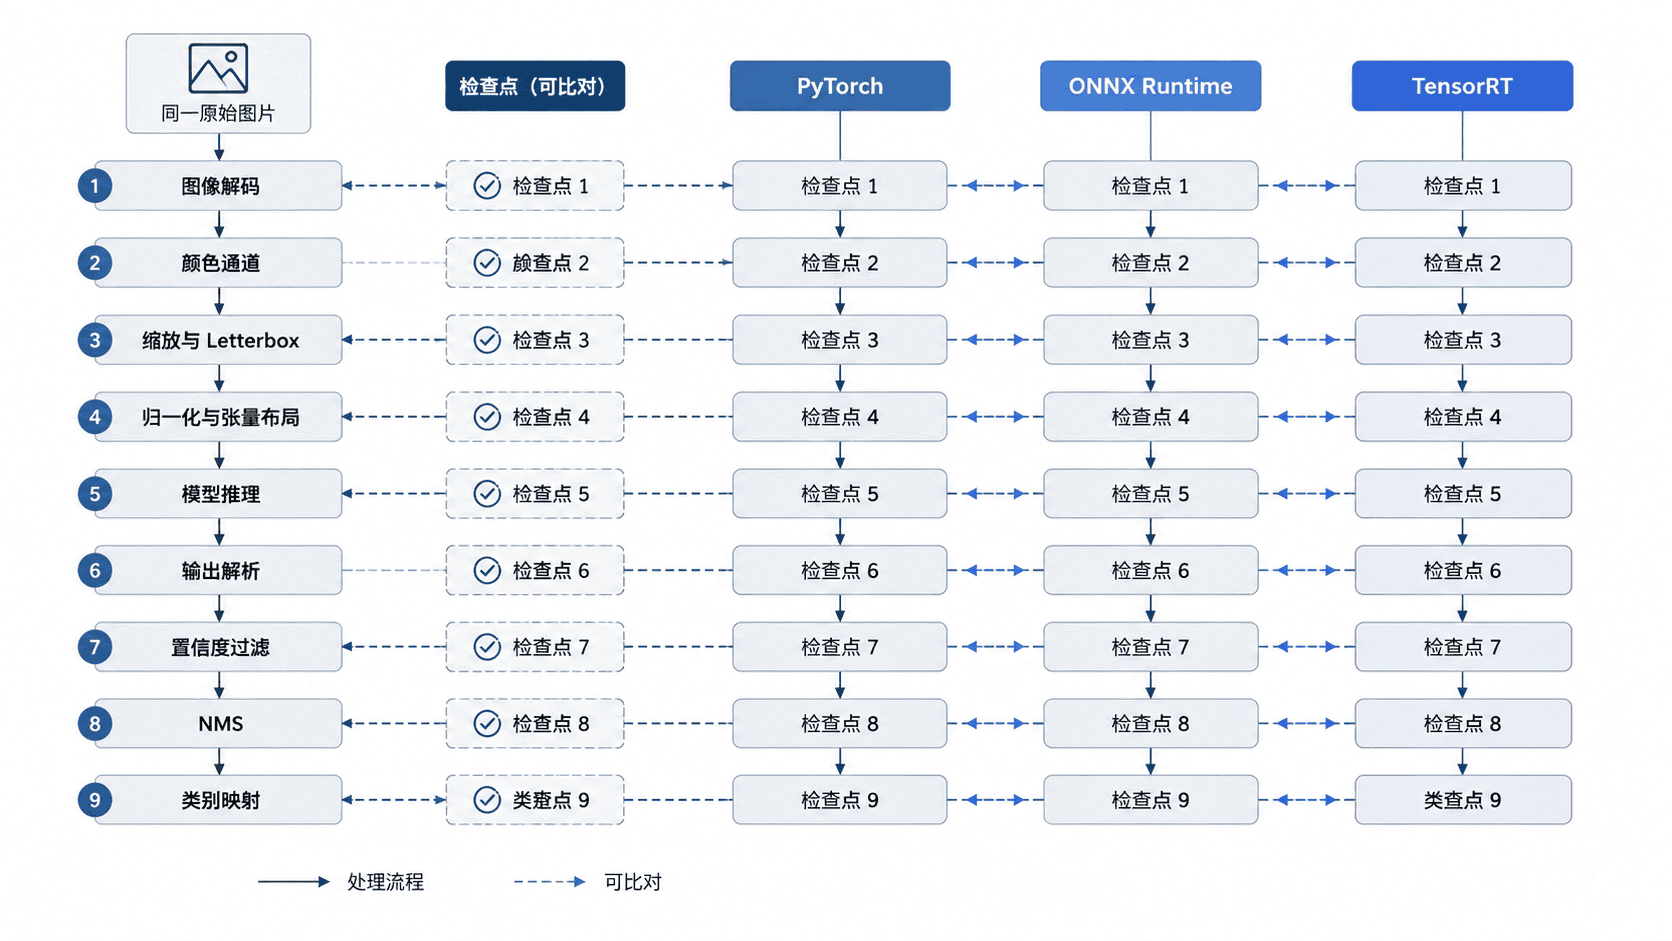
定位时从最靠近输入的一层开始。若预处理张量已经不同,就不要继续讨论 NMS;若原始输出接近而最终框不同,问题通常在输出维度解释、阈值、坐标还原或 NMS 参数。
每次只调整一个变量并重新保存中间结果。若同时修改输入尺寸、阈值和类别表,即使结果变好,也无法确认真正原因。
核对预处理条件
最常见的差异来自直接拉伸和 Letterbox 混用。YOLOv8 通常保持宽高比缩放,再用固定像素填充;如果部署端直接缩放到正方形,目标形状会被拉伸,预测框和置信度都可能改变。
还要核对颜色通道、数值范围、张量布局和数据类型。OpenCV 默认读取 BGR,而模型常使用 RGB;像素通常除以 255.0;布局通常由 HWC 转为 CHW;输入可能是 float32、float16 或量化后的 uint8。
坐标还原必须使用与预处理一致的缩放比例和填充值。若只按输入宽高换算,却忽略 Letterbox 的上下或左右边距,检测框会整体偏移。
核对输出解释与后处理
不同导出版本的输出形状可能不同,不能只凭数组长度猜测含义。应确认每一维对应框坐标、类别分数还是检测数量,并核对坐标格式是 xywh 还是 xyxy。
阈值附近的小数差异会直接改变框数量。例如一个后端输出 0.49,另一个输出 0.51,在阈值 0.50 下就会相差一个框。比较时应先保留较低阈值的候选,再分析分数变化。
NMS 还要统一 IoU 阈值、是否按类别执行、最大检测数量和类别过滤条件。类别名称错位通常不是模型问题,而是部署端标签列表顺序与训练时 names 顺序不一致。
运行诊断脚本
下面的完整脚本用固定模拟数据复现两类典型偏差:Letterbox 与直接缩放导致输入张量不同,以及阈值和类别映射导致最终结果不同。运行环境需要 Python 3.9 及以上版本和 NumPy。
import numpy as np

def resize_nearest(image: np.ndarray, out_h: int, out_w: int) -> np.ndarray:
    # 用确定性的最近邻插值,便于重复比较两个预处理分支
    y = (np.arange(out_h) * image.shape[0] / out_h).astype(int)
    x = (np.arange(out_w) * image.shape[1] / out_w).astype(int)
    return image[y[:, None], x[None, :]]

def letterbox(image: np.ndarray, size: int = 640, pad_value: int = 114):
    # 保持宽高比缩放,并记录坐标还原所需的比例和边距
    h, w = image.shape[:2]
    scale = min(size / w, size / h)
    new_w, new_h = round(w * scale), round(h * scale)
    resized = resize_nearest(image, new_h, new_w)
    canvas = np.full((size, size, 3), pad_value, dtype=np.uint8)
    top = (size - new_h) // 2
    left = (size - new_w) // 2
    canvas[top:top + new_h, left:left + new_w] = resized
    return canvas, scale, (left, top)

def to_tensor(image: np.ndarray) -> np.ndarray:
    # 统一转换为模型常用的 CHW float32 张量
    return image.astype(np.float32).transpose(2, 0, 1) / 255.0

def summarize(name: str, detections: np.ndarray, labels: list[str], threshold: float):
    kept = detections[detections[:, 4] >= threshold]
    names = [labels[int(row[5])] for row in kept]
    print(f"{name}: count={len(kept)}, labels={names}")

# 构造固定输入,分别执行 Letterbox 和直接拉伸
image = np.arange(480 * 640 * 3, dtype=np.uint8).reshape(480, 640, 3)
letterboxed, scale, pad = letterbox(image)
direct_resized = resize_nearest(image, 640, 640)

tensor_a = to_tensor(letterboxed)
tensor_b = to_tensor(direct_resized)

print(f"input={image.shape}, tensor={tensor_a.shape}")
print(f"letterbox scale={scale:.2f}, pad={pad}")
print(f"preprocess mean_abs_diff={np.mean(np.abs(tensor_a - tensor_b)):.6f}")
print(f"preprocess max_abs_diff={np.max(np.abs(tensor_a - tensor_b)):.6f}")

# 两个后端仅在阈值附近存在轻微分数差异
backend_a = np.array([
    [10, 20, 100, 120, 0.62, 0],
    [30, 40, 160, 190, 0.49, 1],
], dtype=np.float32)
backend_b = np.array([
    [10, 20, 100, 120, 0.61, 0],
    [30, 40, 160, 190, 0.51, 1],
], dtype=np.float32)

summarize("backend_a@0.50", backend_a, ["person", "car"], 0.50)
summarize("backend_b@0.50", backend_b, ["person", "car"], 0.50)
summarize("backend_b_swapped_map", backend_b, ["car", "person"], 0.50)
预期输出
input=(480, 640, 3), tensor=(3, 640, 640)
letterbox scale=1.00, pad=(0, 80)
preprocess mean_abs_diff=0.251677
preprocess max_abs_diff=0.552941
backend_a@0.50: count=1, labels=['person']
backend_b@0.50: count=2, labels=['person', 'car']
backend_b_swapped_map: count=2, labels=['car', 'person']
脚本证明预处理差异应在进入模型前被发现,而后处理差异应通过统一阈值和标签表验证。修复后至少用正常样本、小目标样本和边界场景复测,并确认输入张量一致、原始输出误差可控、最终框的类别和主要坐标稳定。
使用 FP16 或 TensorRT 优化时,浮点数不必逐位相同,但应记录允许误差,并确认误差不会让置信度频繁跨过业务阈值。