
计算机视觉 / 系统课时
排查训练异常
排查训练异常
本课把“训练效果差”拆成可验证的问题:先看损失是否正常下降,再看训练集与验证集是否分化,最后回到标签和类别配置核对数据。完成后,你能根据曲线、指标和可视化证据判断不收敛、过拟合与标注错误。
学习目标
- 从损失曲线和评估指标识别训练异常类型
- 使用训练产物检查标签分布、样本可视化和混淆矩阵
- 按证据选择数据、参数或训练策略修复方案
先确认训练产物完整
YOLOv8 默认会在运行目录中保存 results.csv、results.png、批次可视化、标签统计图和混淆矩阵。若训练提前中断,先确认日志是否写完;若目录被覆盖或项目名重复,应先定位本次运行对应的实际目录。
下面的脚本读取 results.csv,输出首尾损失与主要验证指标,用于快速判断趋势。将 csv_path 改为本次训练目录。
from pathlib import Path

import pandas as pd

def find_column(columns: list[str], keyword: str) -> str:
    for column in columns:
        if keyword in column:
            return column
    raise KeyError(f"Missing column containing: {keyword}")

def main() -> None:
    csv_path = Path("runs/detect/train/results.csv")
    data = pd.read_csv(csv_path)
    data.columns = [column.strip() for column in data.columns]

    train_box = find_column(data.columns.tolist(), "train/box_loss")
    val_box = find_column(data.columns.tolist(), "val/box_loss")
    map50 = find_column(data.columns.tolist(), "metrics/mAP50(B)")
    map5095 = find_column(data.columns.tolist(), "metrics/mAP50-95(B)")

    first = data.iloc[0]
    last = data.iloc[-1]

    print(f"Epochs: {len(data)}")
    print(f"Train box loss: {first[train_box]:.4f} -> {last[train_box]:.4f}")
    print(f"Val box loss: {first[val_box]:.4f} -> {last[val_box]:.4f}")
    print(f"Final mAP50: {last[map50]:.4f}")
    print(f"Final mAP50-95: {last[map5095]:.4f}")

if __name__ == "__main__":
    main()
预期输出中的数值取决于数据集和训练轮数,重点是比较首尾变化,而不是套用固定阈值。
Epochs: <EPOCH_COUNT>
Train box loss: <START_VALUE> -> <END_VALUE>
Val box loss: <START_VALUE> -> <END_VALUE>
Final mAP50: <VALUE>
Final mAP50-95: <VALUE>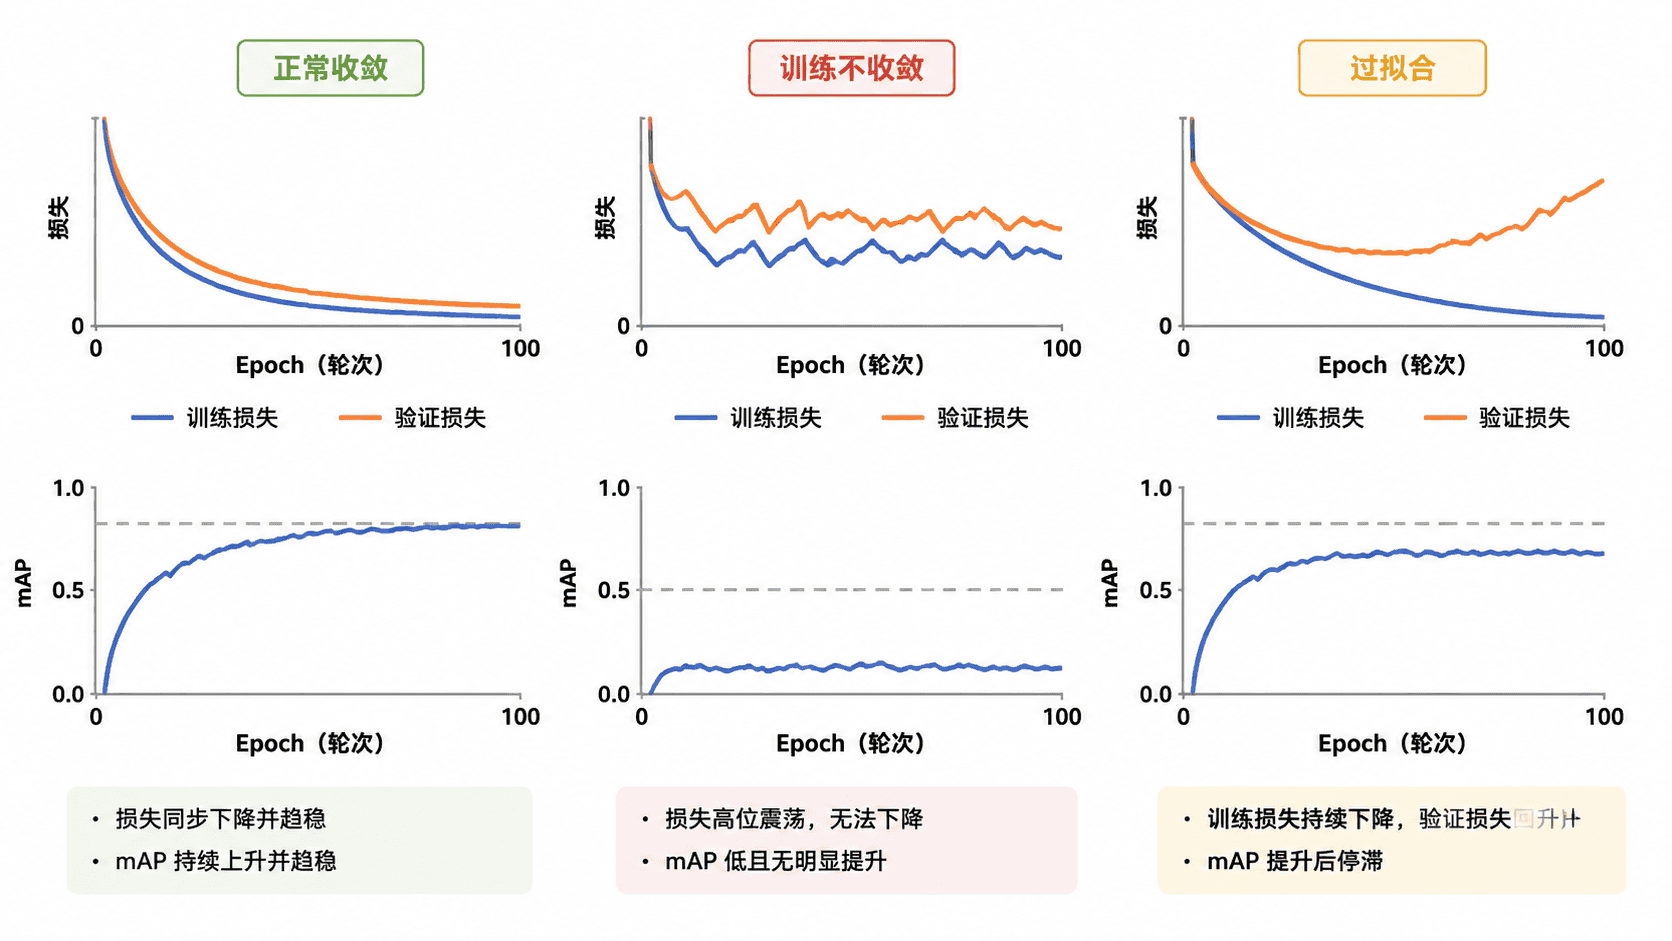
判断训练不收敛
训练不收敛通常表现为多轮之后训练损失仍高位震荡,验证指标接近初始水平,预测框数量异常或几乎没有有效框。先排除学习率过高、数据路径错误、类别编号越界和标签格式错误,再考虑增加训练轮数。
若所有损失都出现 nan,应优先检查损坏图片、非法坐标、空标签处理和混合精度稳定性。若损失缓慢下降但指标始终很低,应抽查训练批次可视化,确认框的位置、类别名称与真实目标一致。此时盲目增加 epoch 往往只会延长错误训练。
判断过拟合
过拟合的典型证据是训练损失持续下降,而验证损失停止下降甚至回升;同时验证集 mAP 在较早阶段达到峰值,随后长期停滞或下降。单看训练损失很容易误判,因此必须同时查看验证曲线和最佳权重所在轮次。
修复顺序通常是先增加有效数据和困难样本,再检查训练集与验证集是否存在明显分布差异。随后可使用更强的数据增强、减小模型规模、提前停止训练,或降低训练轮数。若验证集过小,曲线抖动可能只是样本不足,不能直接认定为过拟合。
检查标签与类别配置
标注错误往往同时影响损失、指标和可视化。重点检查 data.yaml 中类别数量与名称顺序、标签类别编号是否从 0 开始、归一化坐标是否落在合理范围,以及训练集和验证集路径是否指向预期目录。
path: datasets/helmet
train: images/train
val: images/val

names:
  0: person
  1: helmet
该配置表示标签文件中的第一列只能使用 0 或 1。验证时打开训练目录生成的 train_batch0.jpg、labels.jpg 和 confusion_matrix_normalized.png:批次图用于检查框和类别,标签图用于发现类别失衡与异常尺寸,混淆矩阵用于识别经常互相误判的类别。
如果大量目标框越界、集中在固定角落或类别名称明显错位,应先修复数据并重新训练。旧训练结果不能证明新标签已生效,修复后必须创建新的运行目录,避免混用缓存和历史权重。
建立从证据到修复的闭环
每次只改一个主要变量,并记录训练配置、数据版本和最佳指标。先用较小模型和较少 epoch 验证修复方向,再进行完整训练。若同时更换数据、模型、学习率和增强策略,即使指标提升,也无法判断真正有效的因素。
一个完整闭环应满足:异常现象有截图或数值证据,根因能被数据检查或对照实验支持,修复后同一指标得到改善,而且新的可视化不再出现原问题。