
计算机视觉 / 系统课时
容器化部署服务
容器化部署服务
本课把已经可用的 YOLOv8 推理接口封装成 Docker 镜像,并通过环境变量、端口映射和数据卷管理模型权重。完成后,你可以在 CPU 或 NVIDIA GPU 主机上以统一命令启动服务,并用健康检查确认容器部署成功。
学习目标
- 编写可复用的模型服务镜像并固定运行依赖
- 使用数据卷挂载权重,通过环境变量选择运行设备
- 完成镜像构建、容器启动和接口健康检查
设计容器边界
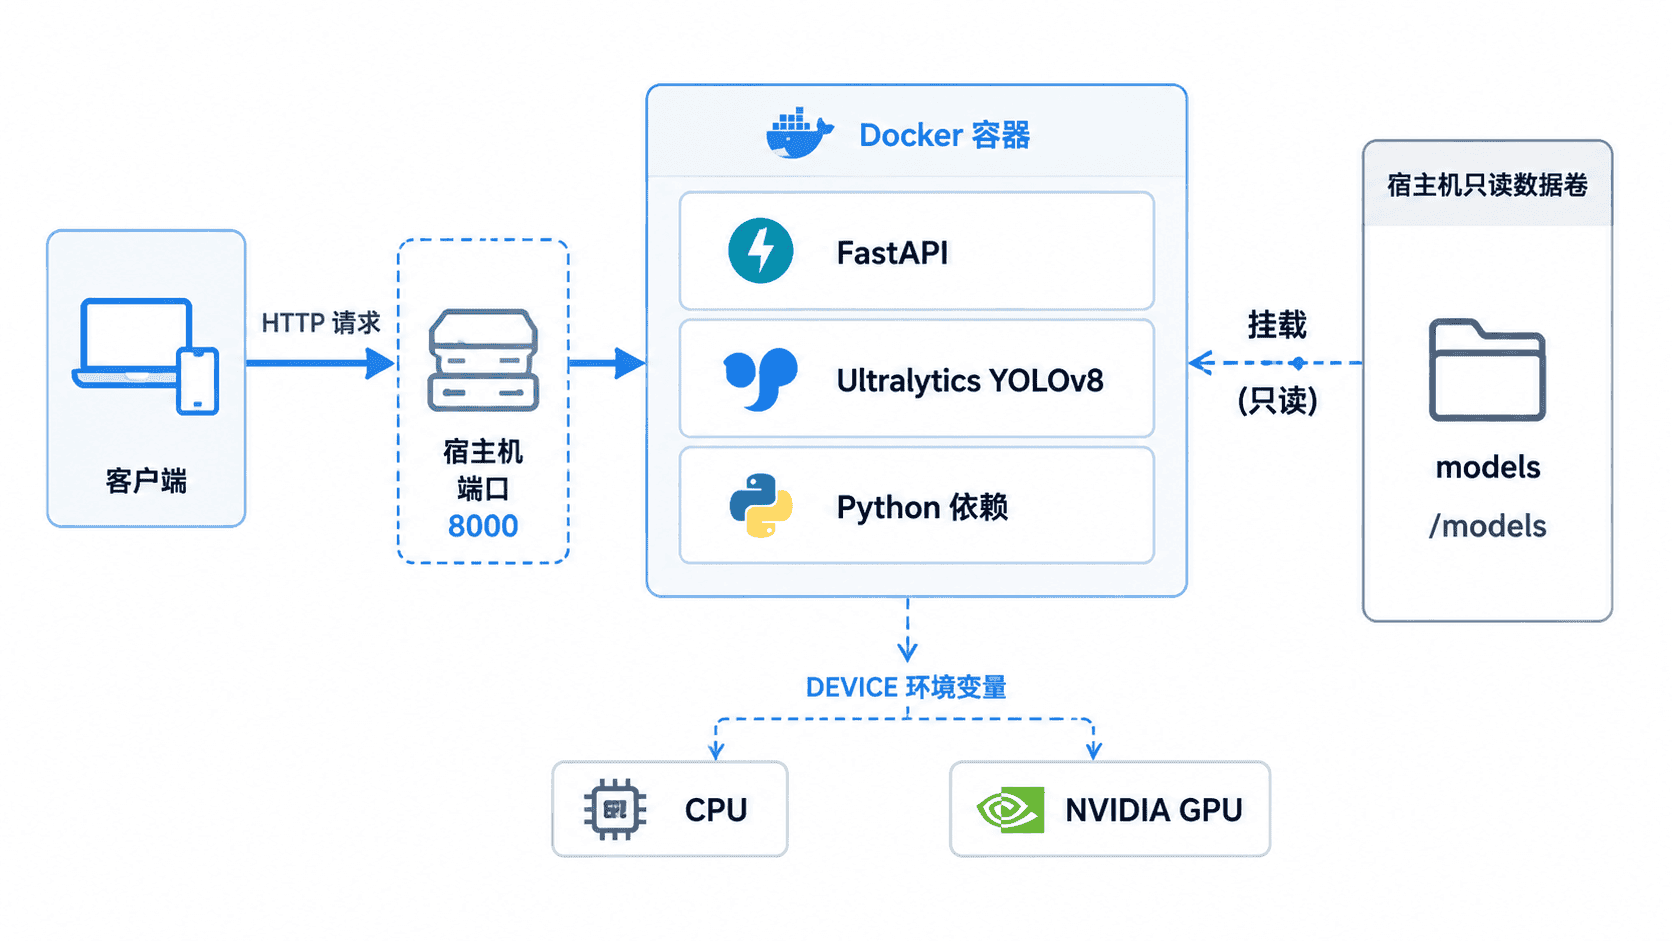
容器只保存服务代码和 Python 依赖,模型权重放在宿主机,通过只读数据卷挂载到 /models。这样更新权重时无需重新构建镜像,也能避免把较大的权重文件提交到镜像仓库。
服务监听容器内的 8000 端口,宿主机可映射到其他端口。MODEL_PATH 指定权重位置,DEVICE 使用 cpu 或 CUDA 设备编号,例如 0。实际路径和端口可按部署环境调整。
编写最小推理服务
目录中保留服务代码、依赖清单和 Dockerfile,权重文件不进入构建上下文。
yolo-service/
├── app.py
├── requirements.txt
└── Dockerfile
requirements.txt 固定主要依赖版本,减少不同构建时间产生的兼容性差异。
ultralytics==8.3.0
fastapi==0.115.0
uvicorn[standard]==0.30.6
python-multipart==0.0.9
pillow==10.4.0
app.py 在容器启动时加载一次模型,避免每个请求重复读取权重。健康检查只返回模型是否已完成初始化,便于 Docker 或网关判断服务状态。
import io
import os

from fastapi import FastAPI, File, HTTPException, UploadFile
from PIL import Image
from ultralytics import YOLO

MODEL_PATH = os.getenv("MODEL_PATH", "/models/best.pt")
DEVICE = os.getenv("DEVICE", "cpu")

app = FastAPI(title="YOLOv8 Inference Service")

# 模型在进程启动阶段加载一次,避免请求级重复初始化。
model = YOLO(MODEL_PATH)

@app.get("/health")
def health() -> dict[str, str]:
    return {"status": "ok", "model": MODEL_PATH, "device": DEVICE}

@app.post("/predict")
async def predict(file: UploadFile = File(...)) -> dict:
    # 在解码前拒绝明显不符合要求的上传类型。
    if not file.content_type or not file.content_type.startswith("image/"):
        raise HTTPException(status_code=415, detail="Only image files are supported")

    image_bytes = await file.read()
    image = Image.open(io.BytesIO(image_bytes)).convert("RGB")
    result = model.predict(source=image, device=DEVICE, verbose=False)[0]

    # 只返回与客户端契约相关的字段,避免暴露框架内部对象。
    detections = []
    if result.boxes is not None:
        for box in result.boxes:
            class_id = int(box.cls.item())
            detections.append(
                {
                    "classId": class_id,
                    "className": result.names[class_id],
                    "confidence": round(float(box.conf.item()), 4),
                    "xyxy": [round(float(v), 2) for v in box.xyxy[0].tolist()],
                }
            )

    return {"count": len(detections), "detections": detections}
预期结果
应用启动后提供 GET /health 和 POST /predict,模型在进程启动时只加载一次。这段代码依赖挂载后的权重文件。启动失败时,优先检查 MODEL_PATH 是否存在、权重是否可读,以及模型版本是否与 Ultralytics 依赖兼容。
构建服务镜像
基础镜像使用 Python 3.11,并安装 OpenCV 常见的系统运行库。HEALTHCHECK 从容器内部访问接口,连续失败时容器状态会变为 unhealthy。
FROM python:3.11-slim

ENV PYTHONDONTWRITEBYTECODE=1 \
    PYTHONUNBUFFERED=1 \
    MODEL_PATH=/models/best.pt \
    DEVICE=cpu

WORKDIR /app

RUN apt-get update \
    && apt-get install -y --no-install-recommends libgl1 libglib2.0-0 curl \
    && rm -rf /var/lib/apt/lists/*

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY app.py .

EXPOSE 8000

HEALTHCHECK --interval=30s --timeout=5s --retries=3 \
    CMD curl -fsS http://127.0.0.1:8000/health || exit 1

CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"]
在项目目录执行构建命令:
docker build -t yolo-service:1.0 .预期输出
Successfully built <IMAGE_ID>
Successfully tagged yolo-service:1.0
不同 Docker 版本的构建日志格式可能不同,但最终应生成名为 yolo-service:1.0 的镜像。
启动并验证容器
CPU 环境下,把宿主机 models 目录只读挂载到容器,并将宿主机 8080 映射到容器 8000。
docker run -d \
  --name yolo-service \
  -p 8080:8000 \
  -v "$(pwd)/models:/models:ro" \
  -e MODEL_PATH=/models/best.pt \
  -e DEVICE=cpu \
  yolo-service:1.0
预期输出
<CONTAINER_ID>随后访问健康检查:
curl -s http://127.0.0.1:8080/health预期输出
{"status":"ok","model":"/models/best.pt","device":"cpu"}需要 GPU 时,宿主机必须先安装 NVIDIA 驱动、Docker 和 NVIDIA Container Toolkit,再将启动参数改为 --gpus all -e DEVICE=0。镜像中的 PyTorch 还必须是支持对应 CUDA 版本的构建;否则即使容器能看到显卡,模型也无法在 GPU 上执行。
典型失败与验收
容器立即退出时,先执行 docker logs yolo-service。若提示找不到权重,检查宿主机 models/best.pt;若健康状态为 unhealthy,确认服务是否监听 0.0.0.0:8000;若 GPU 不可用,分别验证 nvidia-smi 和容器内的 CUDA 可见性。
最终验收应满足三点:容器保持运行、健康检查返回 status=ok、权重更新后只需重启容器而不必重建镜像。生产环境还应增加请求大小限制、并发控制、日志采集和反向代理超时配置。