
计算机视觉 / 系统课时
排查环境与显存问题
排查环境与显存问题
本课建立一套从“环境是否正确”到“模型能否稳定运行”的排查顺序,覆盖依赖冲突、CUDA 不可用、显存溢出和权重加载失败。完成后,你能用最少的试错快速定位问题层级,并验证修复是否真正生效。
学习目标
- 检查 Python、PyTorch、Ultralytics 与 CUDA 的实际运行状态
- 按固定顺序定位依赖、设备、显存和模型文件问题
- 使用最小推理任务验证环境修复结果
先执行统一诊断
不要一看到报错就反复重装。先运行一个最小诊断脚本,确认当前解释器、核心依赖、CUDA 状态、显卡名称、可用显存和模型加载能力。
import sys

import torch
import ultralytics
from ultralytics import YOLO

def main() -> None:
    print(f"Python: {sys.version.split()[0]}")
    print(f"PyTorch: {torch.__version__}")
    print(f"Ultralytics: {ultralytics.__version__}")
    print(f"CUDA available: {torch.cuda.is_available()}")

    if torch.cuda.is_available():
        device_index = 0
        free_bytes, total_bytes = torch.cuda.mem_get_info(device_index)
        print(f"GPU: {torch.cuda.get_device_name(device_index)}")
        print(f"Free VRAM: {free_bytes / 1024**3:.2f} GB")
        print(f"Total VRAM: {total_bytes / 1024**3:.2f} GB")

    # 使用官方小模型验证权重下载、反序列化和网络结构创建
    model = YOLO("yolov8n.pt")
    print(f"Model loaded: {model.model.__class__.__name__}")

if __name__ == "__main__":
    main()
预期输出如下,版本号、显卡名称和显存数值会因本机环境不同而变化。
Python: <VERSION>
PyTorch: <VERSION>
Ultralytics: <VERSION>
CUDA available: True
GPU: <GPU_NAME>
Free VRAM: <FREE_GB> GB
Total VRAM: <TOTAL_GB> GB
Model loaded: DetectionModel
如果脚本在导入阶段失败,优先处理依赖;如果 CUDA available 为 False,先处理设备链路;如果模型加载成功但训练时报错,再进入显存和数据层排查。
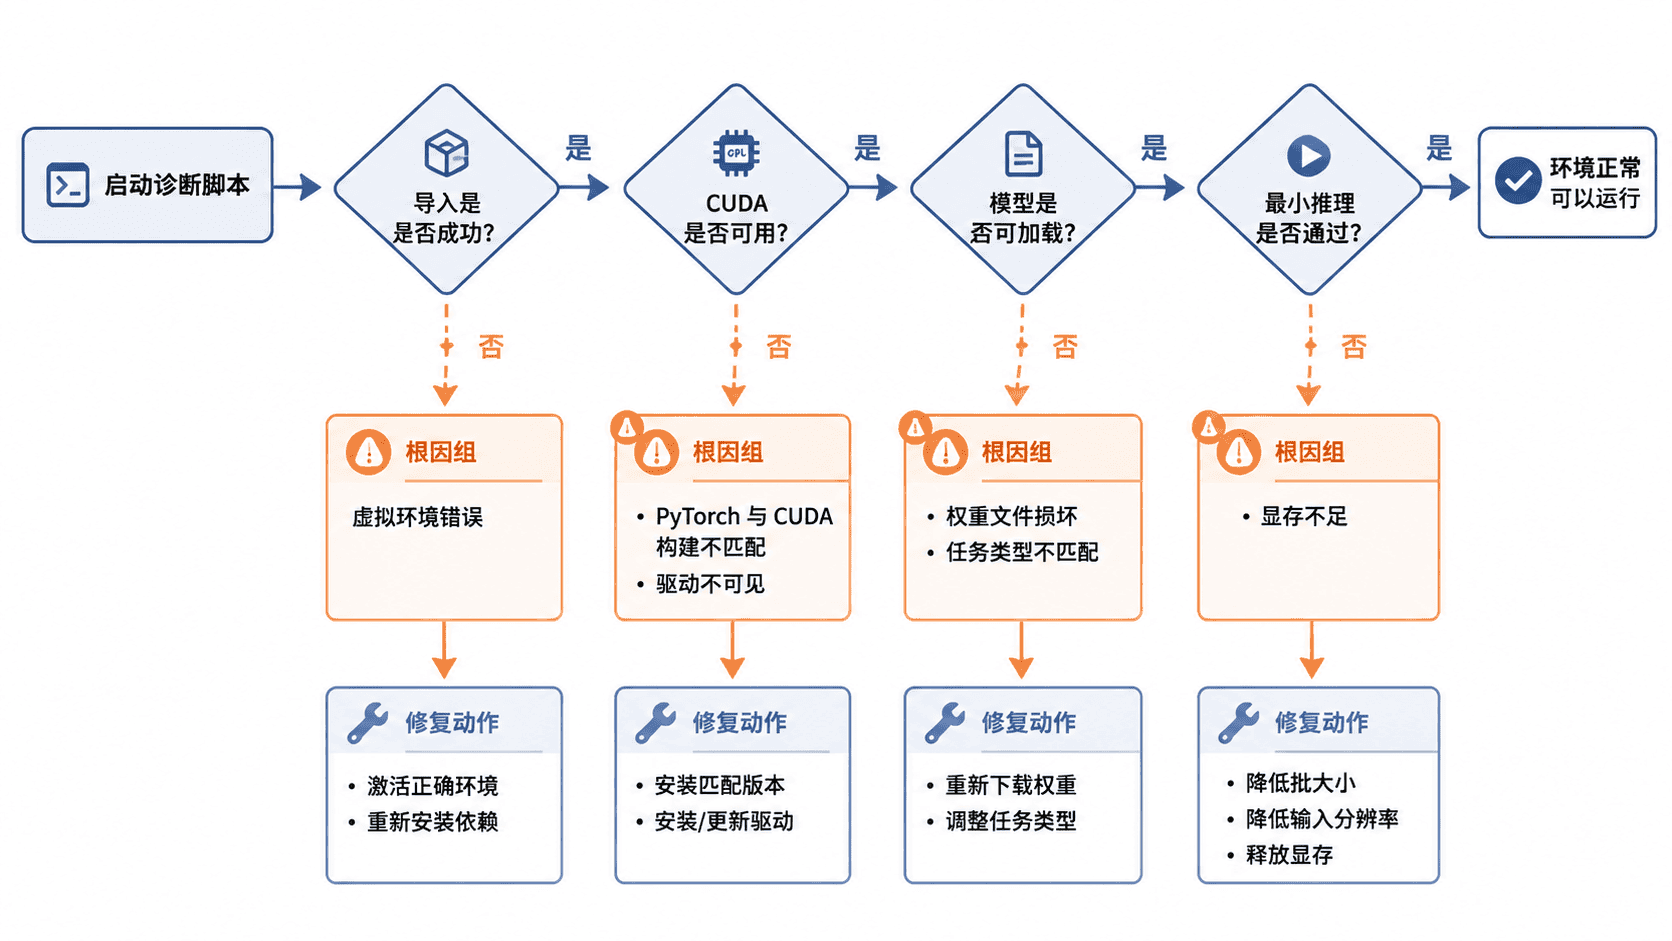
处理依赖冲突与 CUDA 不可用
依赖冲突常见于同时使用系统 Python、Conda 和虚拟环境,或在一个环境中多次混装 pip 与 conda 包。先确认命令实际指向哪个解释器,再查看已安装版本。
python -c "import sys; print(sys.executable)"
python -m pip show torch torchvision ultralytics
python -m pip check
预期结果是解释器路径指向当前项目环境,且 pip check 不报告依赖冲突。
<PATH_TO_ACTIVE_PYTHON>
Name: torch
Version: <VERSION>
...
No broken requirements found.
当 torch.cuda.is_available() 为 False 时,按“驱动可见性 → PyTorch 构建类型 → 容器或远程环境是否透传 GPU”的顺序检查。nvidia-smi 能看到显卡但 PyTorch 仍不可用,通常说明安装了 CPU 版 PyTorch,或当前 PyTorch 对应的 CUDA 运行时与驱动不兼容。重新安装前应以 PyTorch 官方安装命令为准,不要只凭本机 CUDA Toolkit 版本猜测。
处理显存溢出
显存溢出通常不是单一参数导致,而是模型规模、输入尺寸、批次大小、数据增强和其他进程共同作用。最有效的调整顺序是:先减小 batch,再减小 imgsz,然后换更小模型,最后才考虑关闭部分增强或使用梯度累积。
yolo detect train data=coco8.yaml model=yolov8n.pt epochs=1 imgsz=640 batch=2 device=0 workers=2预期结果是训练能够完成一个 epoch,并在终端显示显存占用、损失和验证指标。
Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances  Size
1/1      <GPU_MEM> <BOX_LOSS> <CLS_LOSS> <DFL_LOSS> <COUNT>   640
1 epochs completed
若仍出现 CUDA out of memory,先用 nvidia-smi 结束无关进程,再将 batch 调为 1。不要把“清理缓存”当作根治手段;torch.cuda.empty_cache() 只能释放未被张量引用的缓存,不能降低当前计算图真正需要的显存。
处理模型加载失败
模型加载失败要先区分“文件不可读”和“模型语义不匹配”。文件不存在、下载中断或权限不足,通常会在打开文件时失败;将分类模型用于检测任务、将自定义结构与旧权重混用,则可能在构建网络或加载参数时失败。
检查本地权重时,应确认路径、文件大小和读取权限。若文件来自网络传输,可重新下载官方权重,或重新导出自训练模型。不要通过关闭安全检查来加载来源不明的权重,因为模型文件本质上属于可执行反序列化输入。
用最小任务完成验收
修复后不要直接恢复长时间训练。先完成一次小模型、小数据集、单 epoch 的训练或单张图片推理,再逐步恢复原来的模型、图像尺寸和批次。验收标准包括:解释器路径正确、依赖无冲突、CUDA 状态符合预期、模型能加载、最小任务不中断、显存峰值留有余量。