
计算机视觉 / 系统课时
选择合适任务类型
选择合适任务类型
同一视觉需求可以被建模成分类、检测、分割、姿态或旋转框,但它们解决的问题、标注成本和部署负担并不相同。本课将用一套可复用的判断顺序,帮助你在项目开始前选出“输出足够、成本不过度”的任务类型。
学习目标
- 区分五类任务能够直接输出的信息
- 根据业务验收标准判断最低可用任务类型
- 综合标注、训练和部署成本做出取舍
先从业务输出倒推
选择任务时不要先问“哪个模型更高级”,而要先定义系统最终必须返回什么。只需要判断整张图属于哪一类,使用分类;需要知道目标在哪里,使用检测;需要精确到像素边界,使用分割;需要关键点和骨架关系,使用姿态;需要目标方向和紧凑包围区域,使用旋转框。
一个可靠原则是选择能满足验收要求的最简单任务。更复杂的输出不会自动带来更高业务价值,却一定会增加数据、训练、后处理和端侧适配成本。
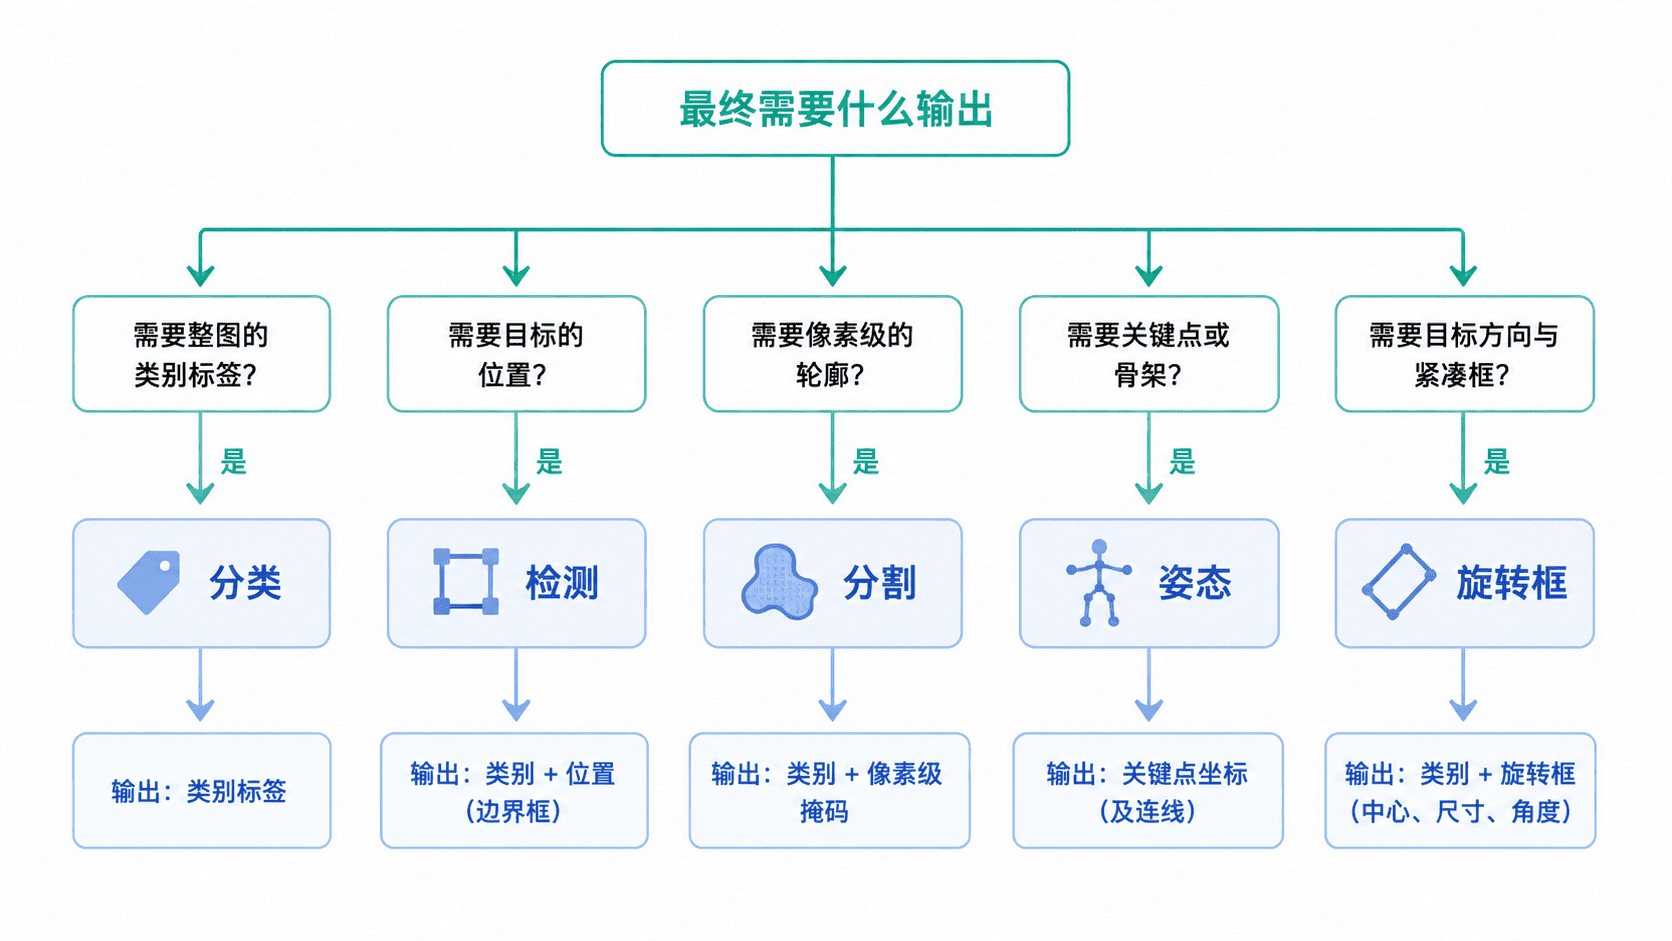
五类任务的能力与成本
| 任务类型 | 直接输出 | 标注成本 | 部署开销 | 典型用途 |
|---|---|---|---|---|
| 分类 | 整图类别与概率 | 低 | 低 | 缺陷有无、品类识别 |
| 检测 | 类别、置信度、水平框 | 中 | 中 | 计数、定位、告警 |
| 分割 | 类别与像素级区域 | 高 | 高 | 面积测量、抠图、边界分析 |
| 姿态 | 关键点及其置信度 | 高 | 中到高 | 人体动作、关节或零件位姿 |
| 旋转框 | 类别、置信度、方向框 | 中到高 | 中到高 | 遥感、文字、倾斜细长目标 |
表中的成本是相对关系,不是固定结论。实例数量、类别数、目标尺寸、遮挡程度和硬件平台都会改变实际工作量,但任务输出越细,通常越依赖精确标注和专用后处理。
用三个问题做最终决策
第一,验收指标看什么。若指标只要求“图片是否合格”,分类已经足够;若要求标出每个缺陷的位置,则至少需要检测。不要用分类模型去承担定位责任,也不要为了展示效果把只需计数的项目升级成分割。
第二,错误代价在哪里。漏掉一个目标会造成安全风险时,应优先保证召回率和可解释定位;边界误差会影响面积、切割或抓取时,分割或姿态才有必要。目标方向会影响裁剪、字符识别或机械抓取时,再考虑旋转框。
第三,部署环境能否承受。移动端、边缘盒子和高并发服务更关心延迟、显存、算子兼容与后处理复杂度。复杂任务可以通过更小模型、降低输入尺寸或异步处理缓解,但不能忽略输出张量和后处理本身的成本。
常见选择误区
“分割一定比检测准”是常见误解。分割提供的是更细输出,不代表类别判断必然更好;如果标签边界粗糙,额外复杂度反而会放大噪声。
“先做复杂任务以后更灵活”也不一定成立。复杂标注会拖慢数据闭环,使项目迟迟无法建立基线。更稳妥的做法是先用最低可用任务验证数据和业务价值,再根据失败样本升级任务类型。
还有一种误区是忽略下游系统。模型能够输出旋转框或关键点,不代表现有推理引擎、接口协议、数据库字段和前端组件已经支持这些结构,任务确定前应完成一次端到端兼容性检查。
一个可执行的选型结论
当需求仍不清晰时,可以先写一句验收描述:“系统必须在 <TIME> 内,对每张图返回 <OUTPUT>,并达到 <METRIC>。”其中 <TIME>、<OUTPUT> 和 <METRIC> 要替换为项目真实值。
如果 <OUTPUT> 只包含整图标签,选分类;包含多个目标位置,选检测;包含精确轮廓,选分割;包含关键点关系,选姿态;包含方向框,选旋转框。这个结论应写入数据规范和接口设计,避免标注完成后才发现输出不够用。