
计算机视觉 / 系统课时
分析混淆矩阵
分析混淆矩阵
混淆矩阵把每个真实类别与模型预测结果放在同一张图中。本课将帮助你识别类别互相误判、背景误检和目标漏检,并把异常单元格追溯到验证集样本,形成可执行的数据修复方案。
学习目标
- 正确读取对角线、非对角线和背景区域
- 区分类别混淆、误检与漏检
- 根据异常单元格定位样本并验证改进效果
先确认矩阵的阅读方向
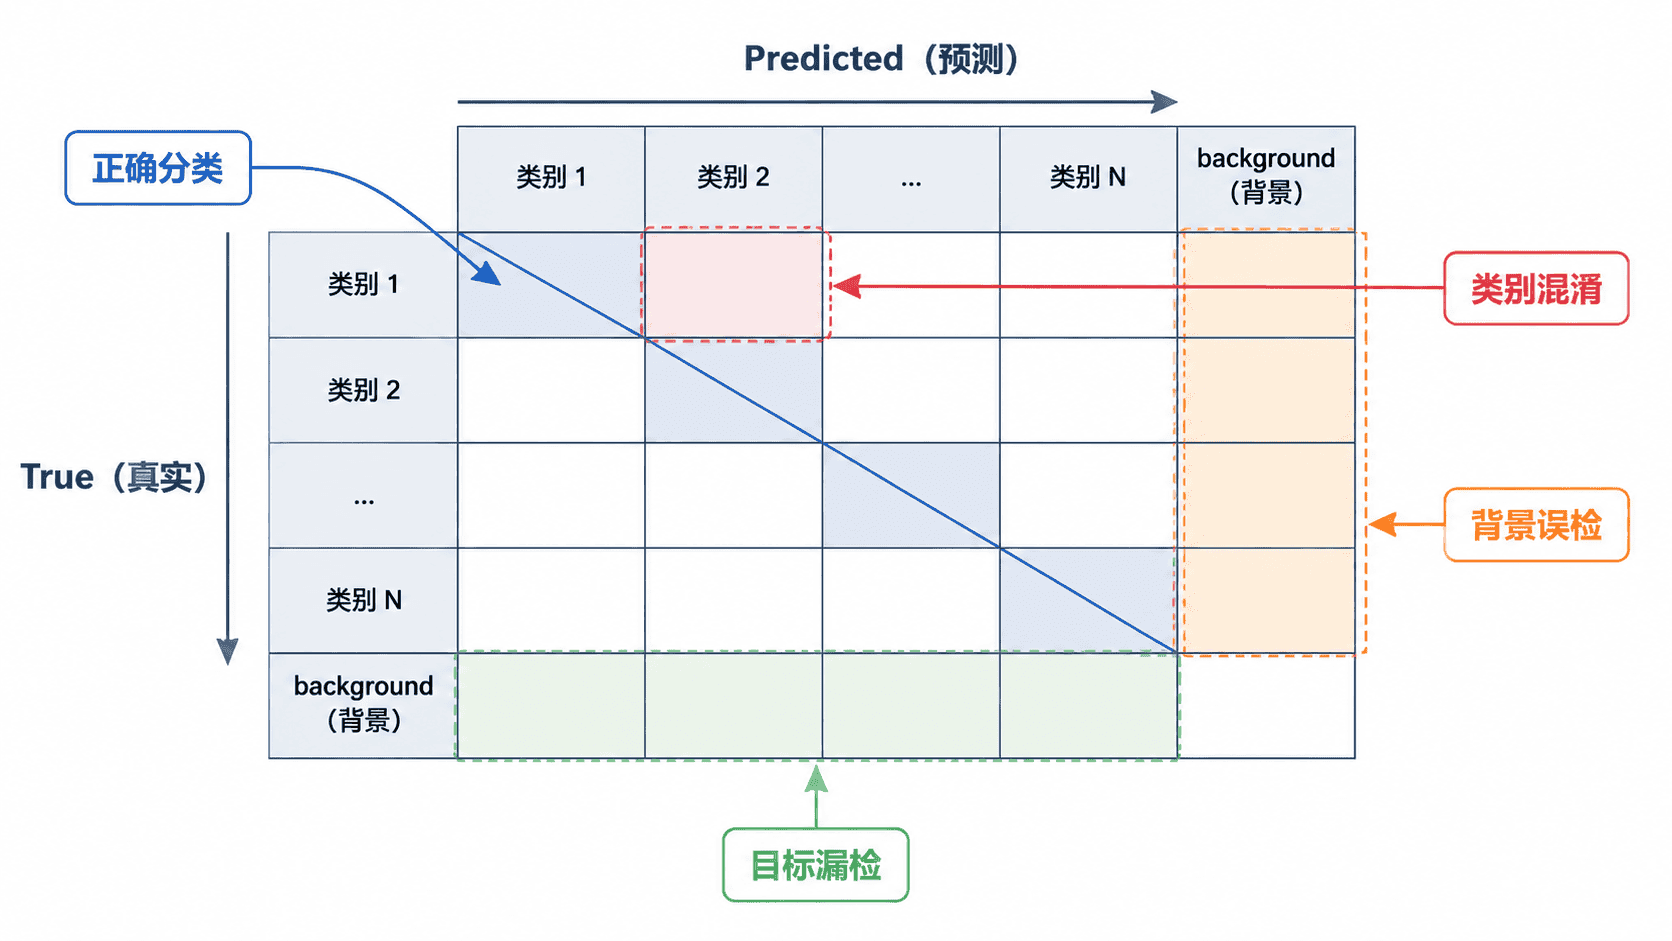
不要凭习惯猜横轴和纵轴,先查看图上的 True 与 Predicted 标签。不同工具可能交换坐标轴,但判断方法不变:真实类别与预测类别相同的位置构成对角线,对角线越集中,分类结果通常越稳定。
非对角线单元格表示类别被错认。例如真实类别 helmet 大量落入预测类别 head,说明模型经常把安全帽与头部混淆。数值较大不一定代表模型很差,还要结合该类样本总量和归一化矩阵判断比例。
生成混淆矩阵
在项目根目录执行验证命令。示例假设已安装 Ultralytics,模型权重位于 runs/detect/train/weights/best.pt,数据配置文件为 data.yaml。
yolo detect val model=runs/detect/train/weights/best.pt data=data.yaml imgsz=640 plots=True project=runs/detect name=val_confusion预期结果:
验证完成,结果目录:runs/detect/val_confusion
关键文件:confusion_matrix.png
关键文件:confusion_matrix_normalized.png
实际输出还会包含 Precision、Recall 和 mAP 等指标,数值取决于模型与数据集。若目录已存在,工具可能自动追加序号,应以终端显示的保存路径为准。
区分三类异常
类别混淆集中在非对角线。优先检查数值最大的几个单元格,确认类别定义是否重叠、目标外观是否接近,以及训练集中是否存在一类明显多于另一类的情况。
背景误检表示模型在没有目标的位置预测出了目标。常见根因包括负样本不足、背景纹理与目标相似、标注漏框,以及推理置信度设置过低。修复重点通常是补充困难负样本、清理漏标,并重新评估阈值。
目标漏检表示真实目标被判为背景。小目标、遮挡、模糊、极端角度和训练样本不足都可能导致漏检。此时应查看对应类别的原图与标注,而不是只通过降低置信度掩盖问题。
追溯对应样本
先记录异常单元格涉及的真实类别和预测类别,再查看验证目录中的 val_batch*_labels.jpg 与 val_batch*_pred.jpg。前者用于核对真实标注,后者用于观察模型预测,两者对照可以快速发现漏框、错标、类别边界不一致和困难背景。
若批次图不足以定位全部问题,可重新对验证集执行预测,并按“真实类别、预测类别、置信度”保存错误样本清单。排查时优先看高置信度误检和重复出现的场景,因为它们通常比偶发低置信度错误更有修复价值。
修复后如何验证
保持验证集、图像尺寸和评估参数不变,重新训练或微调后再次生成矩阵。比较归一化矩阵时,重点观察目标单元格是否回到对角线、背景误检和漏检比例是否下降,同时确认其他类别没有明显退化。
混淆矩阵只反映某个评估设置下的分类结果,不能单独代表模型整体质量。最终还要结合 PR 曲线、每类 AP、实际业务阈值和真实场景样本共同判断。