
计算机视觉 / 系统课时
构建项目数据集
构建项目数据集
本课把原始图片整理成可直接用于 YOLOv8 训练的数据集。你将完成目录规范、类别配置、训练验证集划分和标注检查,并使用脚本发现缺失标签、非法类别和越界坐标等常见问题。
学习目标
- 按 YOLOv8 规范组织图片、标签和类别配置
- 合理划分训练集、验证集与独立测试集
- 使用脚本检查标签完整性、坐标范围和类别分布
统一目录与类别
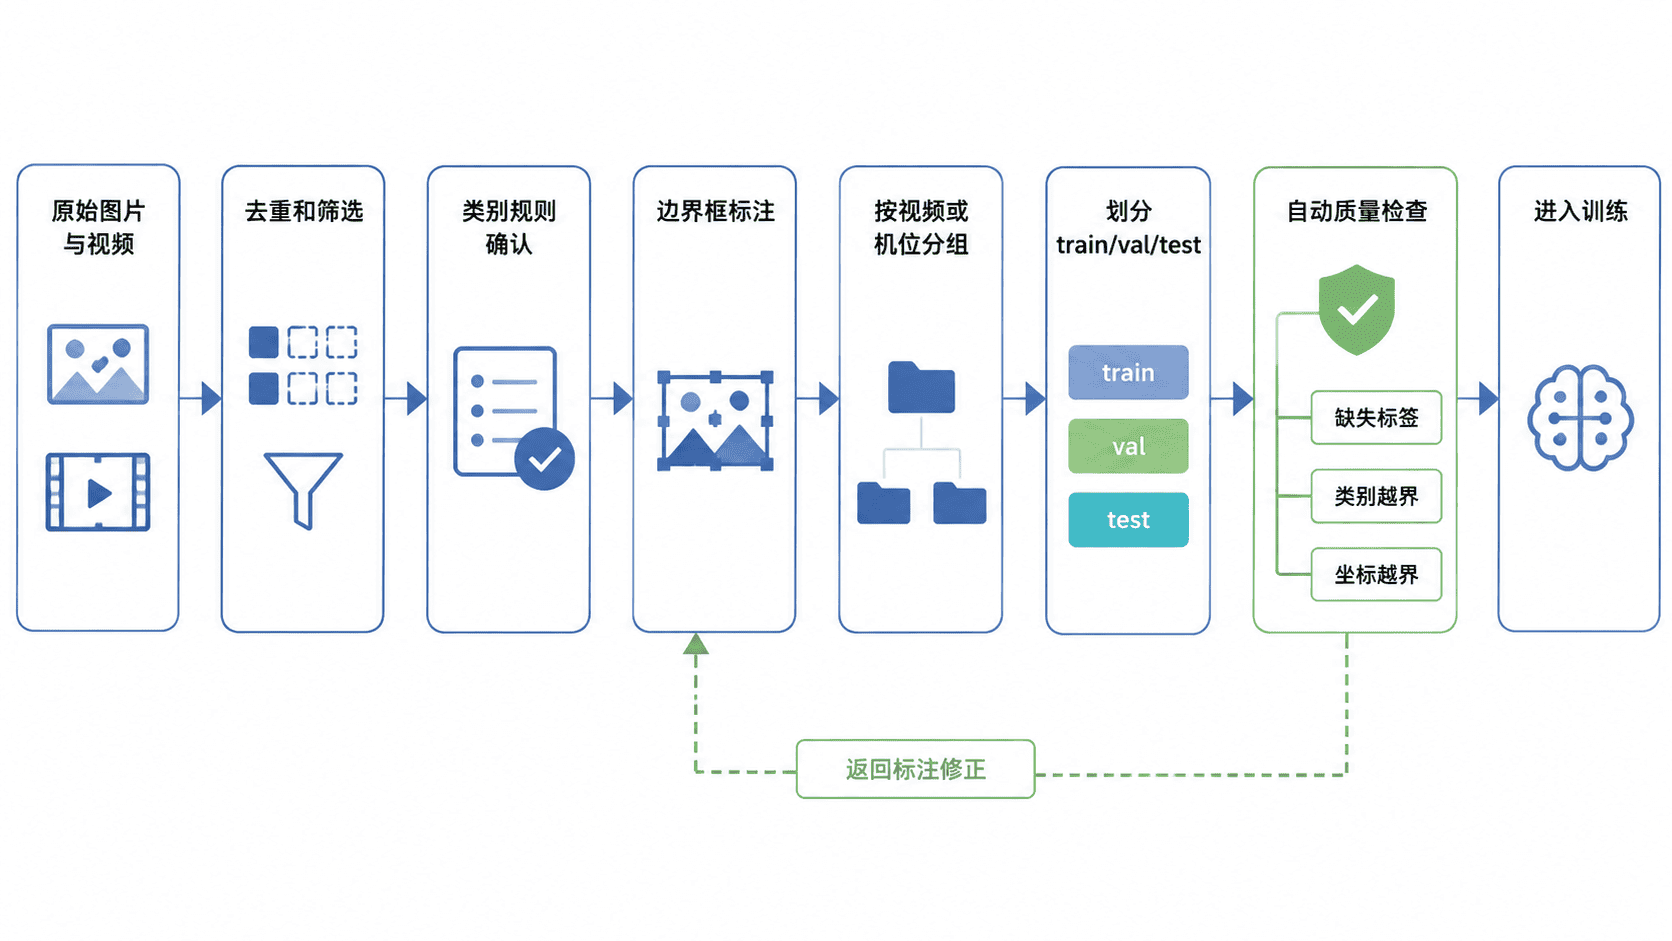
推荐把图片和标签按 train、val、test 分开,图片文件与标签文件必须同名。例如 images/train/a001.jpg 对应 labels/train/a001.txt。标签中的每一行使用 class_id x_center y_center width height,后四项必须归一化到 0 到 1。
项目目录可按下面的结构创建。该结构是片段示例,依赖你已经准备好的图片和标签文件。
helmet_dataset/
├── images/
│   ├── train/
│   ├── val/
│   └── test/
├── labels/
│   ├── train/
│   ├── val/
│   └── test/
└── data.yaml
data.yaml 中的类别顺序决定标签里的 class_id。一旦开始标注,不要随意调整顺序,否则原有标签会被错误解释。
path: helmet_dataset
train: images/train
val: images/val
test: images/test
names:
  0: person
  1: helmet
  2: no_helmet
生效行为:YOLOv8 会以 path 为根目录解析三个数据子集,并按照 names 映射类别编号。验证时可执行训练命令或数据检查脚本,确认路径存在且类别编号未越界。
采集并划分数据
数据应优先覆盖真实部署环境,而不是单纯追求数量。固定摄像头项目要包含不同时间、光照、遮挡、目标大小和人员密度;若现场存在多个机位,应保证各机位都进入训练集和验证集。
划分时要避免相邻视频帧被随机分到不同集合。连续帧高度相似,若同时出现在训练集和验证集,会让验证指标虚高。更稳妥的方法是按视频片段、日期或摄像头分组后再划分。
常用比例可以从训练集 70%、验证集 20%、测试集 10% 起步。数据量较小时,先保证验证集覆盖所有类别和关键场景,再调整比例。
检查标注质量
边界框应紧贴可见目标,不能把大量背景包含进去,也不能只框目标的一部分。严重遮挡目标是否标注、极小目标是否保留、多个相邻目标如何拆分,都应在标注规范中提前写清楚。
除了抽查图片,还应检查类别分布。某个关键类别样本过少时,模型容易偏向高频类别。可以优先补采少数类别,或重新审查类别是否定义得过细,而不是简单复制图片制造数量。
运行自动检查脚本
下面的完整脚本检查指定数据集中的标签文件。它会统计图片数、缺失标签数、非法标签行、类别越界次数和各类别目标数。示例只依赖 Python 标准库。
from collections import Counter
from pathlib import Path

IMAGE_SUFFIXES = {".jpg", ".jpeg", ".png", ".bmp"}

def check_split(root: Path, split: str, class_count: int) -> None:
    image_dir = root / "images" / split
    label_dir = root / "labels" / split

    # 只统计常见图片格式,并递归支持子目录。
    images = [
        path
        for path in image_dir.rglob("*")
        if path.is_file() and path.suffix.lower() in IMAGE_SUFFIXES
    ]

    missing_labels = 0
    invalid_rows = 0
    class_counts: Counter[int] = Counter()

    for image_path in images:
        relative = image_path.relative_to(image_dir).with_suffix(".txt")
        label_path = label_dir / relative

        # 图片与标签必须保持相同的相对路径和文件名。
        if not label_path.exists():
            missing_labels += 1
            continue

        for line_number, line in enumerate(
            label_path.read_text(encoding="utf-8").splitlines(), start=1
        ):
            parts = line.split()
            if len(parts) != 5:
                invalid_rows += 1
                print(f"非法列数: {label_path}:{line_number}")
                continue

            try:
                class_id = int(parts[0])
                x_center, y_center, width, height = map(float, parts[1:])
            except ValueError:
                invalid_rows += 1
                print(f"非法数值: {label_path}:{line_number}")
                continue

            # 中心点允许位于边界,宽高必须为正;同时检查框是否超出画面。
            basic_valid = (
                0 <= class_id < class_count
                and 0 <= x_center <= 1
                and 0 <= y_center <= 1
                and 0 < width <= 1
                and 0 < height <= 1
            )
            box_inside = (
                x_center - width / 2 >= 0
                and x_center + width / 2 <= 1
                and y_center - height / 2 >= 0
                and y_center + height / 2 <= 1
            )
            if not basic_valid or not box_inside:
                invalid_rows += 1
                print(f"越界标签: {label_path}:{line_number}")
                continue

            class_counts[class_id] += 1

    print(f"数据集: {split}")
    print(f"图片数: {len(images)}")
    print(f"缺失标签: {missing_labels}")
    print(f"非法标签行: {invalid_rows}")
    print(f"类别统计: {dict(sorted(class_counts.items()))}")

def main() -> None:
    dataset_root = Path("helmet_dataset")
    check_split(dataset_root, split="train", class_count=3)

if __name__ == "__main__":
    main()
在示例目录包含 120 张训练图片、标签齐全且格式合法时,预期输出如下。实际图片数和类别统计会随数据集变化。
数据集: train
图片数: 120
缺失标签: 0
非法标签行: 0
类别统计: {0: 198, 1: 173, 2: 46}
若出现“越界标签”,应先检查 class_id 是否超过 data.yaml 中的最大编号,再检查坐标是否错误地使用了像素值。脚本要求中心点位于 0 到 1 之间、宽高大于 0 且不超过 1,并检查边界框四条边没有超出画面。
完成训练前验收
开始训练前,至少人工抽查每个数据子集中的若干图片,并确认类别名称、编号和标注规则一致。验证集与测试集不应包含训练集的重复图片或近似连续帧。
最后记录数据集版本、来源范围、类别数量、图片数量和修订日期。数据发生变化时新建版本,不直接覆盖旧数据,这样才能解释不同训练结果之间的差异。