
计算机视觉 / 系统课时
阅读评估曲线
阅读评估曲线
评估曲线把模型在不同阈值和不同训练阶段的表现展开。本课将带你读取 PR 曲线、置信度曲线与训练曲线,并据此判断阈值是否合理、训练是否收敛以及模型是否出现过拟合。
学习目标
- 读懂 PR、Precision、Recall 与 F1 置信度曲线
- 根据业务代价选择初始置信度阈值
- 从训练与验证曲线判断收敛、欠拟合和过拟合
先分清三组曲线
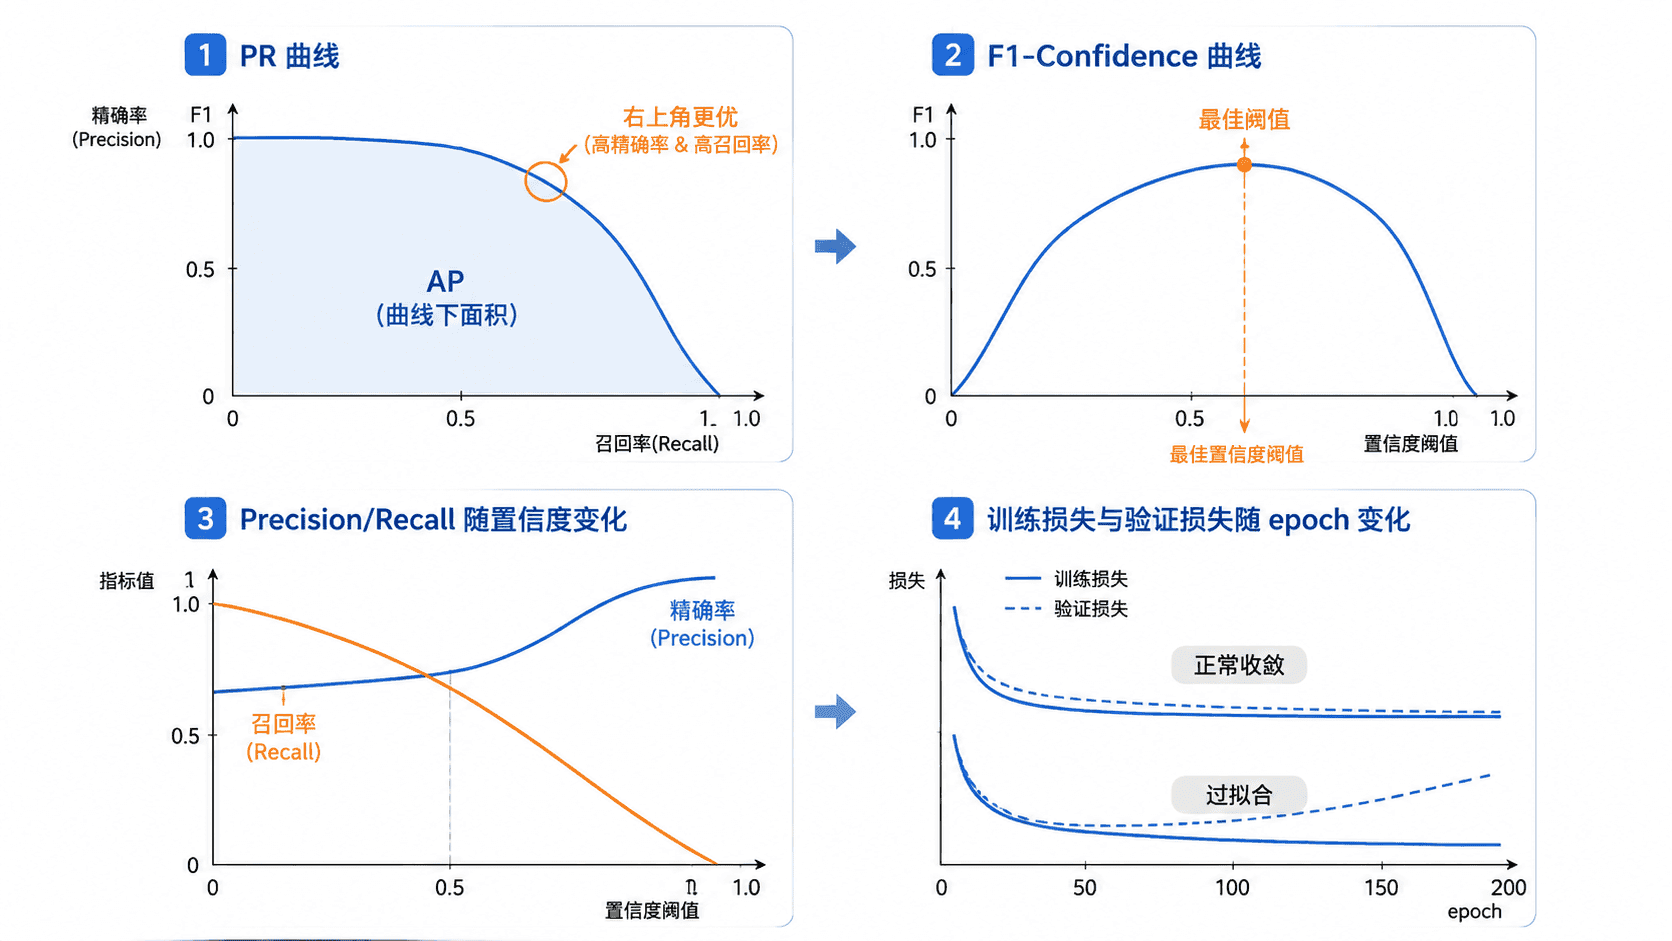
PR 曲线描述 Recall 提升时 Precision 如何变化,曲线越靠近右上角,说明模型在保持较高召回率时仍能减少误检。每个类别通常有独立曲线,整体曲线不能替代对弱势类别的检查。
P_curve.png、R_curve.png 和 F1_curve.png 描述置信度阈值变化对指标的影响。它们回答的是“阈值设成多少更合适”,而不是“模型是否已经训练好”。
训练曲线通常位于 results.png。它同时展示训练损失、验证损失、Precision、Recall 与 mAP 随 epoch 的变化,用于判断优化过程是否稳定以及继续训练是否仍有收益。
生成验证曲线
使用固定验证集生成评估图,避免不同数据划分造成曲线不可比。示例沿用训练得到的最佳权重。
yolo detect val model=runs/detect/train/weights/best.pt data=data.yaml imgsz=640 plots=True project=runs/detect name=val_curves预期结果:
验证完成,结果目录:runs/detect/val_curves
关键文件:PR_curve.png
关键文件:P_curve.png
关键文件:R_curve.png
关键文件:F1_curve.png
实际保存目录可能自动追加序号。训练阶段的损失与指标曲线通常保存在训练目录的 results.png,原始数值可在 results.csv 中查看。
用 PR 曲线判断类别质量
先看每个类别的曲线是否靠近右上角,再比较曲线下面积。若某一类曲线明显低于其他类别,说明它在召回更多目标时会迅速增加误检,应回查该类数据量、标注一致性、相似类别和困难背景。
PR 曲线中部突然下坠,常见于少量高置信度正确样本之后混入大量错误预测。曲线整体偏低,则更可能是特征不足、类别定义模糊或训练数据覆盖不够。
不要只看 mAP 平均值。一个高频类别可能抬高整体结果,而关键小类仍然很弱。业务验收应明确哪些类别必须单独达到目标。
用置信度曲线选择阈值
随着置信度阈值升高,Precision 通常上升,Recall 通常下降。F1_curve.png 的峰值可作为初始阈值,因为它在 Precision 与 Recall 之间取得了相对平衡,但它不是所有业务的最终答案。
漏检代价高的场景应优先保证 Recall,可从较低阈值开始,再通过后处理减少误检。自动放行、自动计费等误检代价高的场景应优先保证 Precision,并对低置信度结果转人工处理。
选定阈值后,要在真实业务样本上重新统计误检率和漏检率。若不同类别风险差异明显,可以采用分类别阈值,而不是强制所有类别共享一个数值。
用训练曲线判断收敛
正常收敛时,训练损失和验证损失整体下降并逐渐趋稳,Precision、Recall 与 mAP 上升后进入平台期。此时继续增加 epoch 的收益通常有限,应优先检查数据和模型规模。
过拟合常表现为训练损失继续下降,但验证损失回升,或验证指标停滞甚至下降。可尝试增加数据多样性、加强合理的数据增强、减少训练轮数,或选择更小的模型。
欠拟合时,训练损失和验证损失都较高,指标长期处于低位。常见原因包括训练不足、学习率不合适、输入尺寸过小、模型容量不足,或者标签本身无法支持任务目标。
曲线突然剧烈波动时,应先检查异常标注、损坏图片、批次大小和学习率,而不是直接增加训练轮数。若只有单个 epoch 异常,可结合日志确认是否发生中断或数据加载问题。
按固定顺序做判断
先用 PR 曲线找到弱势类别,再用置信度曲线确定业务阈值,最后用训练曲线判断问题来自数据、训练过程还是模型容量。这个顺序能避免把数据问题误判成阈值问题,也能避免因单次指标波动过早调整模型。
比较两次实验时必须保持验证集、图像尺寸、IoU 设置和权重选择规则一致。否则曲线差异可能来自评估条件变化,而不是模型真正改进。