
计算机视觉 / 系统课时
导出 ONNX 模型
导出 ONNX 模型
本课把训练得到的 best.pt 转换为可跨框架加载的 ONNX 文件,并用 ONNX 检查器与 ONNX Runtime 核对模型结构。完成后,你将获得一个输入尺寸明确、可选动态维度且能被部署程序识别的 best.onnx。
学习目标
- 使用 Ultralytics Python API 导出 YOLOv8 检测模型
- 正确设置输入尺寸、动态维度、Opset 与图简化参数
- 验证 ONNX 文件是否合法,并读取真实输入输出信息
导出前检查
先确认训练权重存在,并在独立虚拟环境中安装导出与验证依赖。示例默认权重位于 runs/detect/train/weights/best.pt;实际路径不同,修改脚本中的 WEIGHTS 即可。
python -m pip install -U ultralytics onnx onnxruntime onnxslim预期结果
命令以退出码 0 结束,ultralytics、onnx、onnxruntime 和 onnxslim 安装成功。
具体版本号与下载日志会因环境而不同。
导出前还应确认模型任务是目标检测。如果权重来自分类、分割或姿态估计任务,输出张量结构与本课后续验证结果不同,不能直接套用检测模型的解码规则。
配置导出参数
imgsz=640 指定导出时使用的基准输入边长,检测模型输入通常按 NCHW 排列,即批次、通道、高度和宽度。dynamic=True 会让导出图支持动态维度;在 Ultralytics 的常规 ONNX 导出中,它通常不仅放开批次,还会放开图像高度和宽度。
如果部署引擎只允许固定的 1×3×640×640 输入,应将 dynamic 改为 False。如果需要动态批次并保持固定高宽,则要确认目标推理引擎是否支持单独约束动态轴,不能仅凭文件成功导出就判断部署一定兼容。
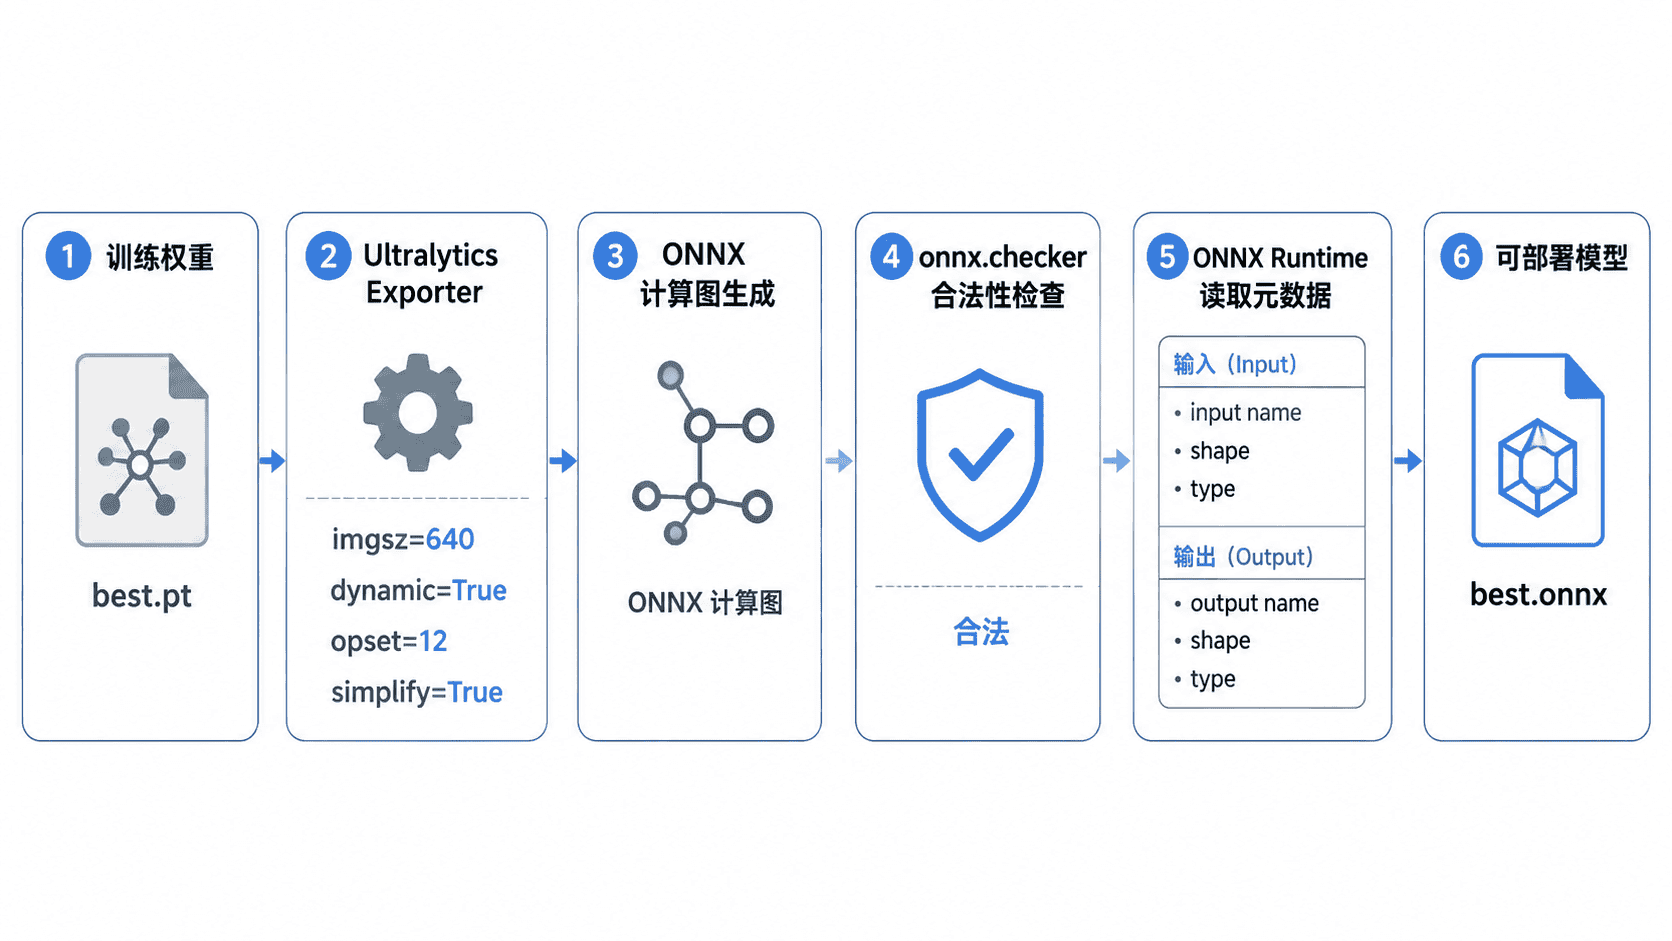
下面的程序完成导出、ONNX 结构检查和输入输出读取。将其保存为 export_onnx.py 后执行 python export_onnx.py。
from pathlib import Path

import onnx
import onnxruntime as ort
from ultralytics import YOLO

WEIGHTS = Path("runs/detect/train/weights/best.pt")
IMAGE_SIZE = 640

def main() -> None:
    if not WEIGHTS.is_file():
        raise FileNotFoundError(f"未找到训练权重: {WEIGHTS}")

    model = YOLO(str(WEIGHTS))

    # dynamic=True 便于部署端使用可变批次或尺寸;固定输入部署时改为 False。
    exported = model.export(
        format="onnx",
        imgsz=IMAGE_SIZE,
        batch=1,
        dynamic=True,
        simplify=True,
        opset=12,
        nms=False,
    )
    onnx_path = Path(exported)

    # checker 负责发现图结构、节点属性和张量定义中的明显错误。
    graph = onnx.load(str(onnx_path))
    onnx.checker.check_model(graph)

    session = ort.InferenceSession(
        str(onnx_path),
        providers=["CPUExecutionProvider"],
    )

    print(f"导出文件: {onnx_path}")
    print("ONNX 检查: 通过")
    for item in session.get_inputs():
        print(f"输入: {item.name}, shape={item.shape}, type={item.type}")
    for item in session.get_outputs():
        print(f"输出: {item.name}, shape={item.shape}, type={item.type}")

if __name__ == "__main__":
    main()
预期输出
导出文件: runs/detect/train/weights/best.onnx
ONNX 检查: 通过
输入: images, shape=['batch', 3, 'height', 'width'], type=tensor(float)
输出: output0, shape=['batch', <4+类别数>, <候选框数>], type=tensor(float)
输入名、输出名和动态轴符号可能随 Ultralytics、ONNX 版本及模型任务变化,应以程序打印结果为准。检测模型的输出通道通常由 4 个边界框值和类别分数组成,因此自定义类别数会直接改变第二个输出维度。
判断导出是否可用
onnx.checker.check_model 通过,只能说明 ONNX 图结构合法;它不能证明预处理、输出解码和原 PyTorch 模型完全一致。最低限度还要确认三件事:输入数据类型是 tensor(float)、通道数为 3、输出维度与当前类别数匹配。
部署前应使用同一张测试图分别运行 .pt 与 .onnx 模型,比较主要目标的类别、置信度和边界框。少量浮点误差通常可以接受;若目标数量或坐标明显不同,应优先检查颜色顺序、归一化、Letterbox 填充和输出转置。
simplify=True会尝试简化计算图,便于部分推理引擎优化。若导出阶段在简化步骤失败,可先改为False完成基础导出,再单独定位依赖或算子兼容问题。
常见失败处理
找不到权重时,不要把路径改成目录;YOLO() 必须接收具体的 .pt 文件。出现不支持算子或 Opset 错误时,先记录目标推理引擎支持的 Opset 范围,再调整 opset,不要盲目使用最大版本。
动态模型能被 ONNX Runtime 加载,但不代表 TensorRT、OpenCV DNN 或移动端引擎都能接受任意尺寸。部署目标固定时,优先导出固定输入模型,能减少运行时形状推导和内存规划的不确定性。