
计算机视觉 / 系统课时
目标检测任务概览
目标检测任务概览
本课解决“模型看见一张图片后究竟要输出什么”的问题。你将区分图像分类、目标检测与语义分割,并读懂目标检测结果中的边界框、类别和置信度,为后续使用 YOLOv8 做训练与推理建立统一认识。
学习目标
- 区分图像分类、目标检测和语义分割的任务目标
- 理解边界框、类别标签与置信度的含义
- 能够判断一组检测结果是否满足实际业务需求
三类视觉任务有什么不同
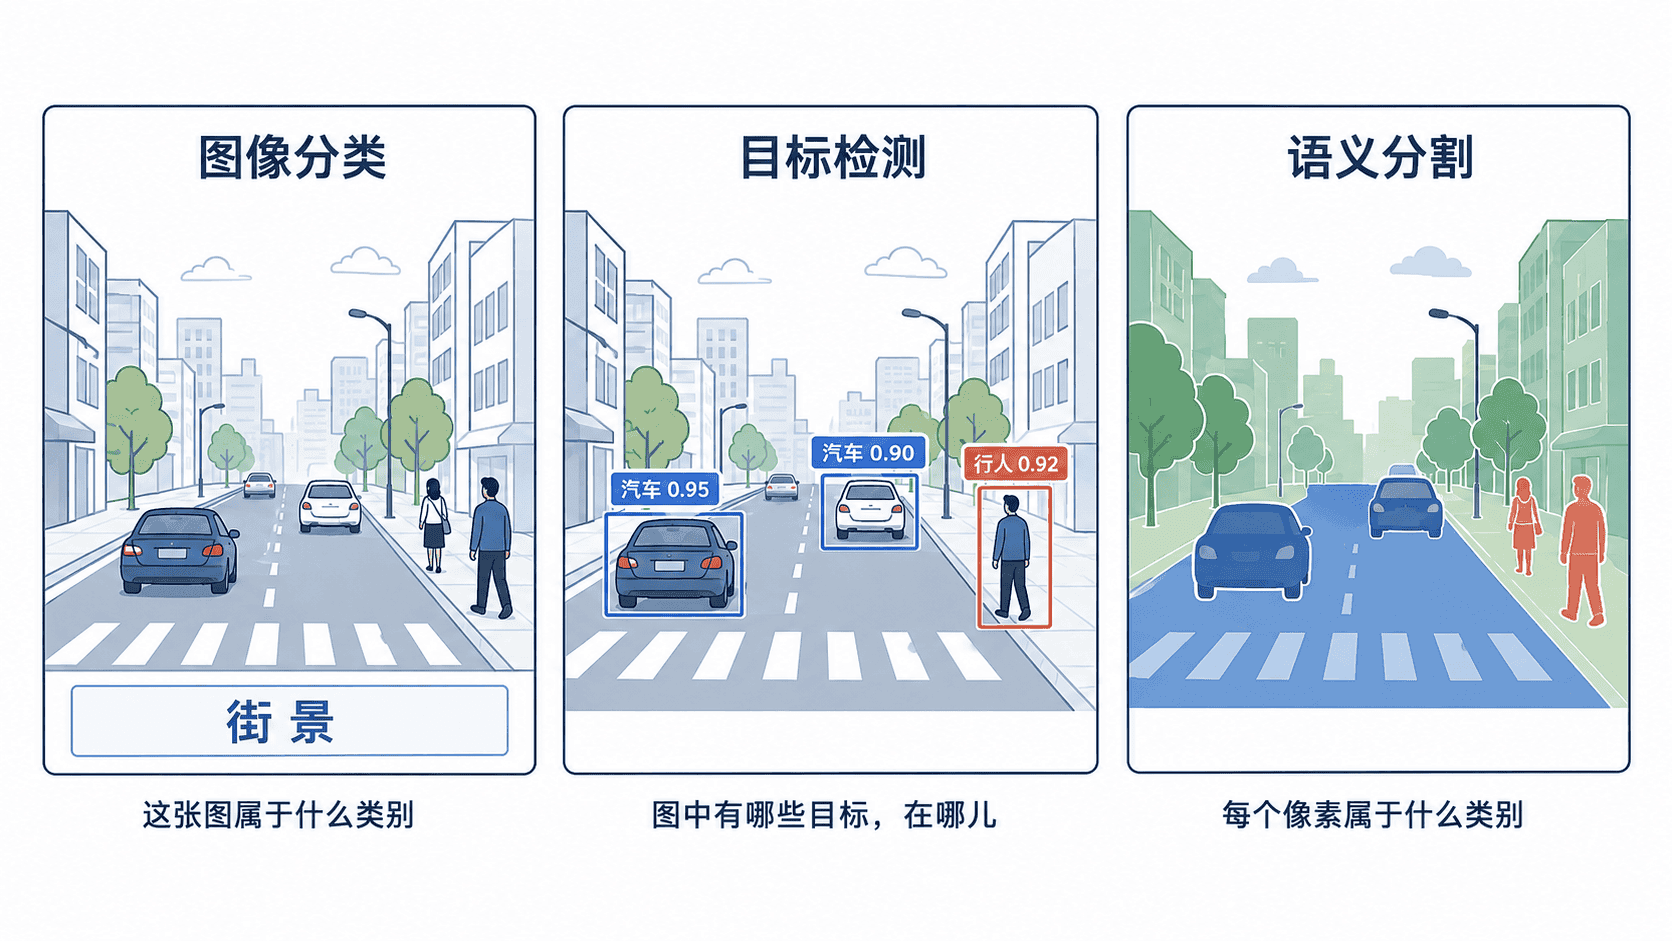
图像分类回答“整张图是什么”。输入一张图片,模型通常只输出一个或多个类别,例如“猫”或“汽车”,但不会指出目标位于哪里。它适合商品分类、场景识别等只关心整体类别的任务。
目标检测回答“图中有什么,以及它们在哪里”。模型会为每个目标输出类别、位置和置信度,因此同一张图中可以同时检测多个人、车辆或其他对象。YOLOv8 最常见的用途就属于这一类。
语义分割回答“每个像素属于什么类别”。它输出与原图对应的像素级掩码,能描述物体轮廓,但通常不直接区分同类目标的不同实例。需要区分每个独立对象时,应使用实例分割。
目标检测结果由什么组成
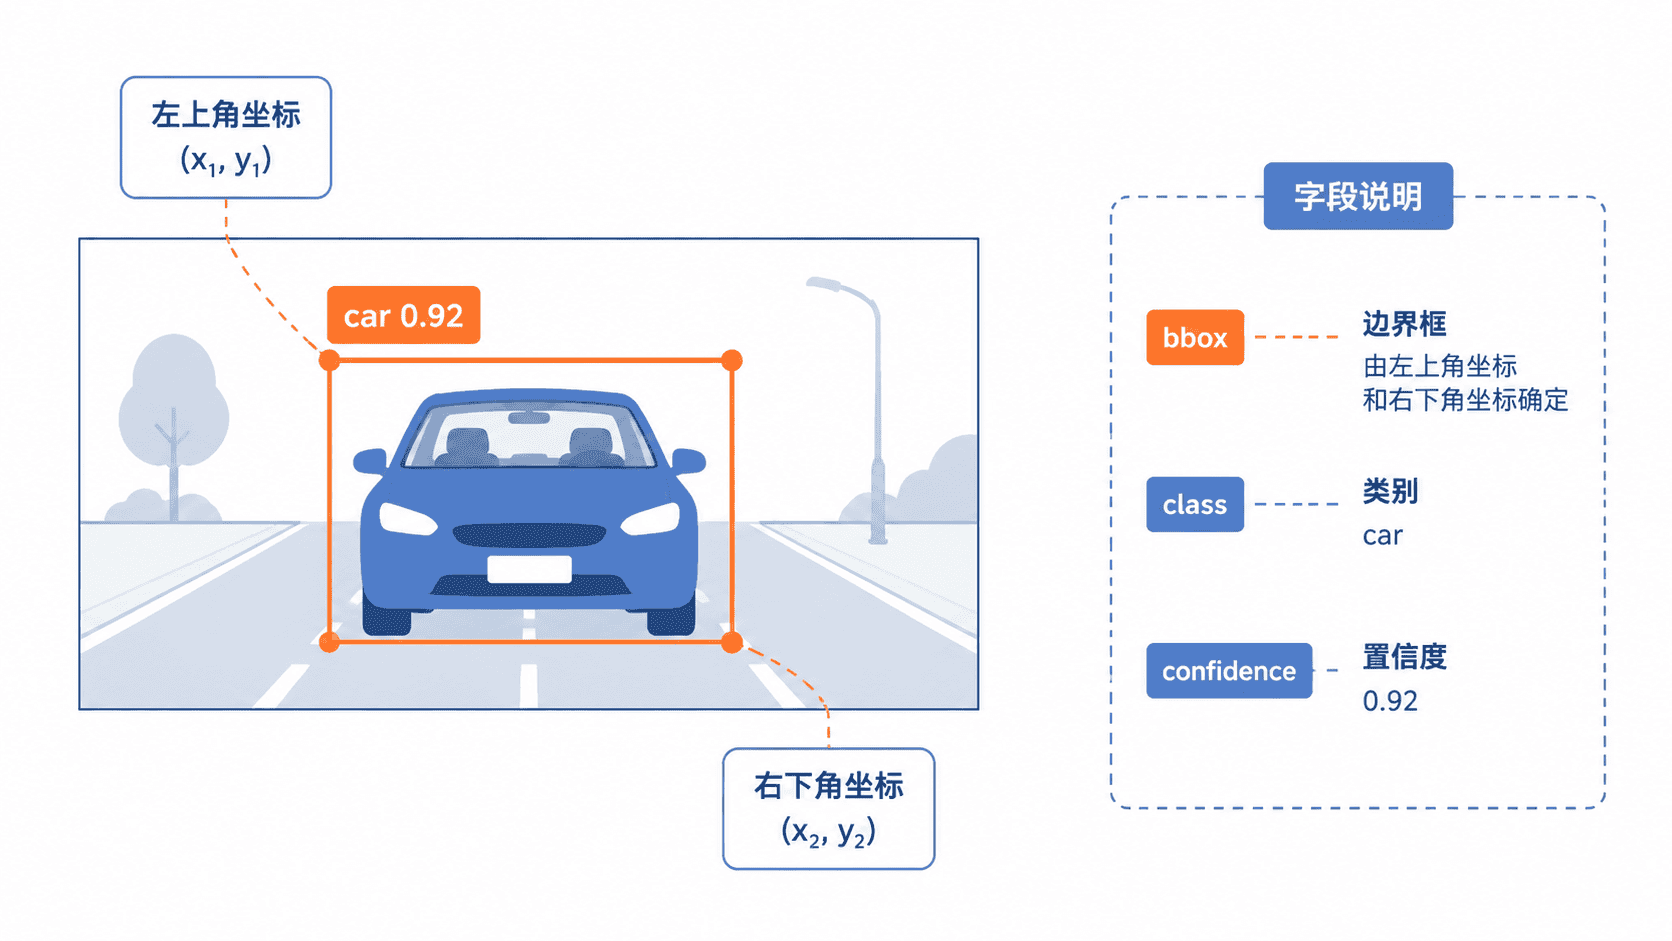
一个检测结果通常包含边界框、类别和置信度。边界框描述目标在图像中的位置,常见表达方式是左上角与右下角坐标,或中心点坐标加宽高。坐标必须结合原图尺寸理解,否则无法还原到正确位置。
类别表示模型认为框内是什么对象,例如 person、car。类别来自训练数据中预先定义的标签集合,模型不能稳定识别训练类别之外的新名称。
置信度表示模型对该检测结果的确信程度,数值通常位于 0 到 1 之间。置信度越高,结果通常越可信,但它不是绝对概率,也不能单独代表模型质量。
如何判断检测结果是否可用
判断结果不能只看“有没有框”。首先检查漏检,即真实存在的目标是否没有被框出;再检查误检,即背景或无关对象是否被错误识别;最后检查定位偏差,即边界框是否明显偏离目标轮廓。
置信度阈值会影响结果数量。阈值较低时,模型保留更多候选框,召回率可能提高,但误检也会增多;阈值较高时,结果更谨慎,却可能漏掉模糊、小尺寸或被遮挡的目标。
实际项目还要结合业务代价选择侧重点。例如安全告警通常更怕漏检,而自动计费更怕误检。不存在适合所有场景的固定阈值,必须用代表真实环境的数据验证。
常见易混淆点
边界框重叠不一定是错误。多个目标彼此遮挡时,合理的框本来就可能重叠;只有同一目标被重复输出多个高度相似的框时,才需要检查后处理是否有效。
“检测到类别”也不等于“理解了对象状态”。检测模型可以识别“人”,但不会自动知道这个人是否摔倒、是否佩戴安全帽,除非训练目标和标签明确包含这些状态。