
计算机视觉 / 系统课时
交付推理应用
交付推理应用
本课把训练得到的 best.pt 接入一个可直接运行的图像或视频推理程序,并补齐依赖、配置、启动方式、输出目录和验收样例。完成后,其他人无需了解训练过程,也能按文档启动并验证应用。
学习目标
- 组织可交付的模型、配置、代码和测试样例
- 使用统一入口完成图像或视频推理
- 通过明确输出和验收项确认交付可用
规划最小交付目录
推理应用至少需要模型权重、运行代码、依赖清单、配置文件和测试样例。不要把训练目录整体复制给使用方,也不要在代码中写死个人电脑路径。
yolov8-inference/
├── app.py
├── config.yaml
├── requirements.txt
├── weights/
│   └── best.pt
├── samples/
│   └── test.jpg
└── outputs/
其中 samples/test.jpg 应选择一张已知预期的真实样例,便于交付双方快速确认环境、模型和输出链路是否正常。
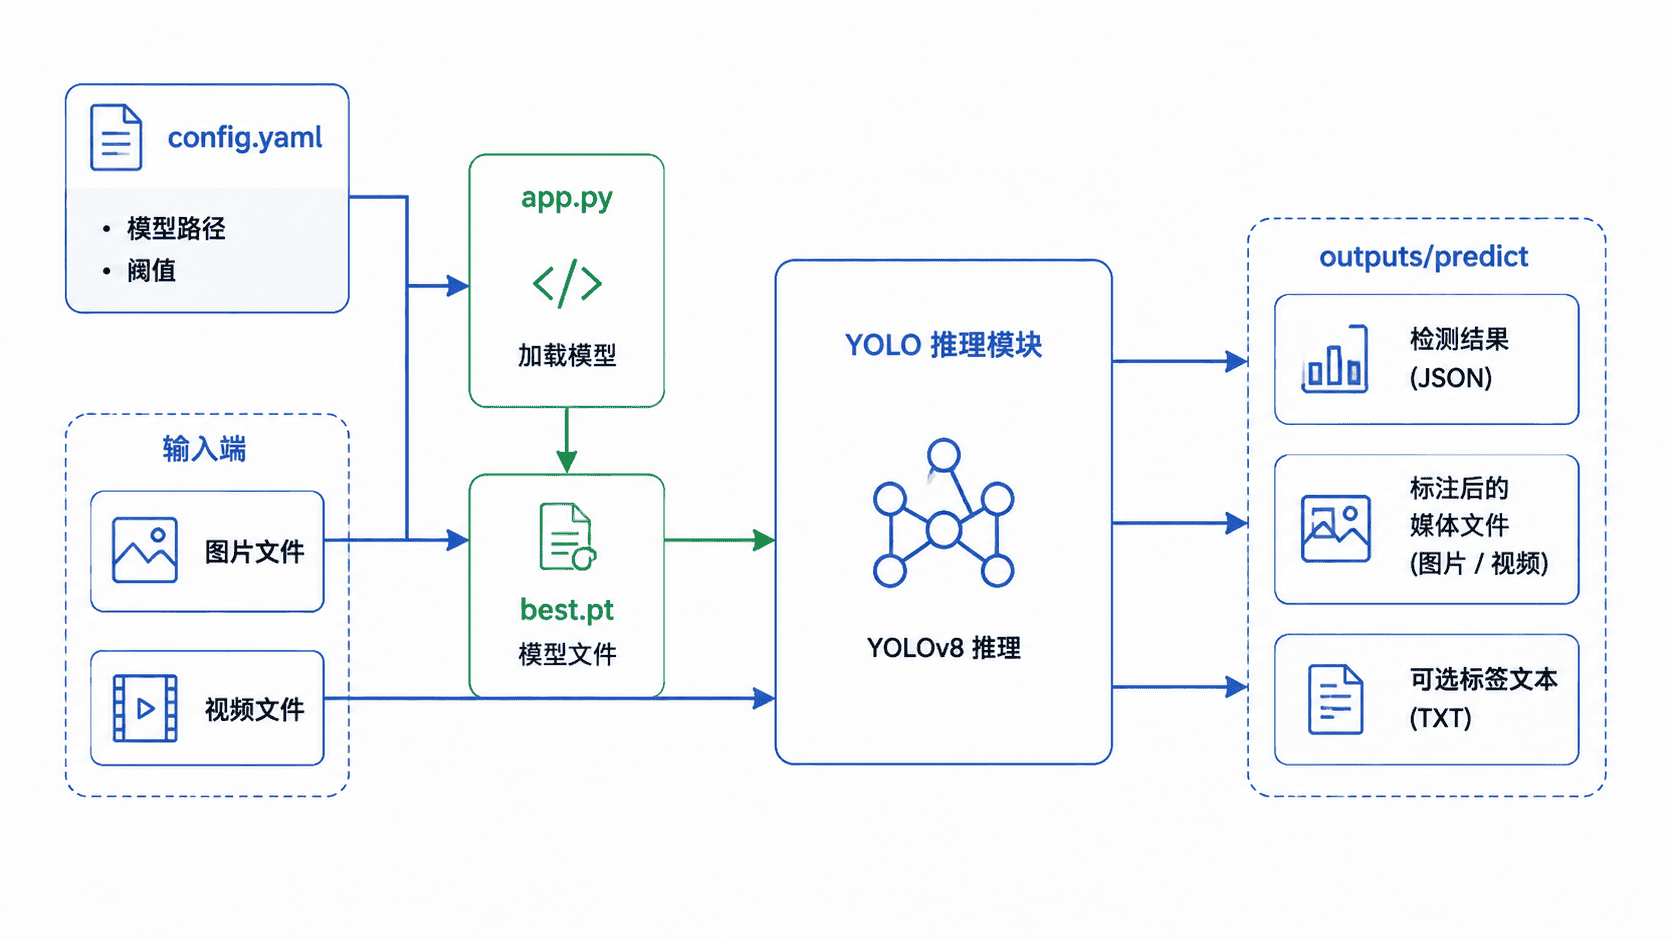
固定依赖与运行配置
将依赖版本写入 requirements.txt,避免接收方安装到不兼容的大版本。
ultralytics>=8.2,<9
PyYAML>=6.0,<7
config.yaml 只保存运行参数,不保存业务机密。source 可以改为图片或视频路径,confidence 越高,保留的检测框越少。
model: weights/best.pt
source: samples/test.jpg
confidence: 0.35
device: cpu
output_dir: outputs
save_txt: true
配置生效行为:程序会加载 weights/best.pt,对 samples/test.jpg 执行推理,并把可视化结果保存到 outputs/predict。使用 GPU 时可将 device 改为 0,前提是当前 PyTorch 环境能够识别 CUDA。
实现统一推理入口
下面的程序同时支持图片和视频文件。它使用流式结果避免一次性把整段视频全部加载到内存,并在结束后输出处理帧数、检测框数量和结果目录。
from __future__ import annotations

import argparse
from pathlib import Path
from typing import Any

import yaml
from ultralytics import YOLO

def load_config(config_path: Path) -> dict[str, Any]:
    with config_path.open("r", encoding="utf-8") as file:
        config = yaml.safe_load(file) or {}

    required = {"model", "source", "confidence", "device", "output_dir"}
    missing = sorted(required - config.keys())
    if missing:
        raise ValueError(f"missing config fields: {', '.join(missing)}")
    return config

def main() -> None:
    parser = argparse.ArgumentParser(description="YOLOv8 image or video inference")
    parser.add_argument("--config", default="config.yaml", help="YAML config path")
    args = parser.parse_args()

    config = load_config(Path(args.config))
    model_path = Path(str(config["model"]))
    source_path = Path(str(config["source"]))

    if not model_path.is_file():
        raise FileNotFoundError(f"model not found: {model_path}")
    if not source_path.is_file():
        raise FileNotFoundError(f"source not found: {source_path}")

    output_dir = Path(str(config["output_dir"]))
    run_name = "predict"
    model = YOLO(str(model_path))

    # stream=True 适合视频输入,图片输入同样可以逐项处理。
    results = model.predict(
        source=str(source_path),
        conf=float(config["confidence"]),
        device=str(config["device"]),
        save=True,
        save_txt=bool(config.get("save_txt", False)),
        project=str(output_dir),
        name=run_name,
        exist_ok=True,
        stream=True,
        verbose=False,
    )

    processed = 0
    detections = 0
    for result in results:
        processed += 1
        detections += len(result.boxes) if result.boxes is not None else 0

    print(
        f"processed={processed} detections={detections} "
        f"output={output_dir / run_name}"
    )

if __name__ == "__main__":
    main()
代码中的动态检测数量取决于模型和样例内容。程序先检查模型与输入文件是否存在,能避免路径错误被误判为模型推理失败。
安装、启动与预期结果
在项目根目录创建虚拟环境并安装依赖,然后使用配置文件启动应用。以下命令以 macOS 或 Linux 为例。
python -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python app.py --config config.yaml
预期输出:
processed=1 detections=<COUNT> output=outputs/predict<COUNT> 是样例图片中的实际检测框数量。若 source 改为视频,processed 将变为视频处理的帧数;输出目录中会生成标注后的图片或视频,启用 save_txt 时还会生成对应标签文件。
使用测试样例完成验收
交付测试不要只检查“程序没有报错”,还要检查模型输出是否符合预期。建议固定一张包含目标的正样例,再准备一张无目标或困难背景样例,分别验证检出能力和误检控制。
验收时按顺序检查:启动命令可在干净环境执行;控制台输出的结果目录存在;生成媒体能够正常打开;正样例关键目标被检测;负样例没有明显误检。路径、Python 版本或 GPU 型号等动态信息应写入交付说明,不要硬编码到程序。
常见失败可按现象快速定位:提示 model not found 时检查权重路径;提示 source not found 时检查测试文件;CUDA 相关错误先把 device 改为 cpu 验证程序链路;能运行但没有检测框时,再检查置信度、类别和样例是否匹配。