
计算机视觉 / 系统课时
调整推理阈值
调整推理阈值
推理结果过多、误检明显或目标经常漏掉时,通常需要先检查置信度阈值和 IoU 阈值。本课将用可重复的对比实验理解两个参数的作用,并给出面向不同业务目标的调参顺序。
学习目标
- 区分置信度阈值与 IoU 阈值的控制对象
- 通过固定图片实验观察阈值变化带来的结果差异
- 根据误检、漏检和目标重叠程度选择合理起点
两个阈值分别控制什么
conf 是最低置信度门槛。数值越高,低分检测框越容易被过滤,结果通常更少、误检可能下降,但漏检风险会上升。
iou 是非极大值抑制时判断重叠框的阈值。数值越低,重叠框更容易互相抑制;数值越高,更多相互重叠的框可能被保留。它不是“越高越严格”的精度开关。
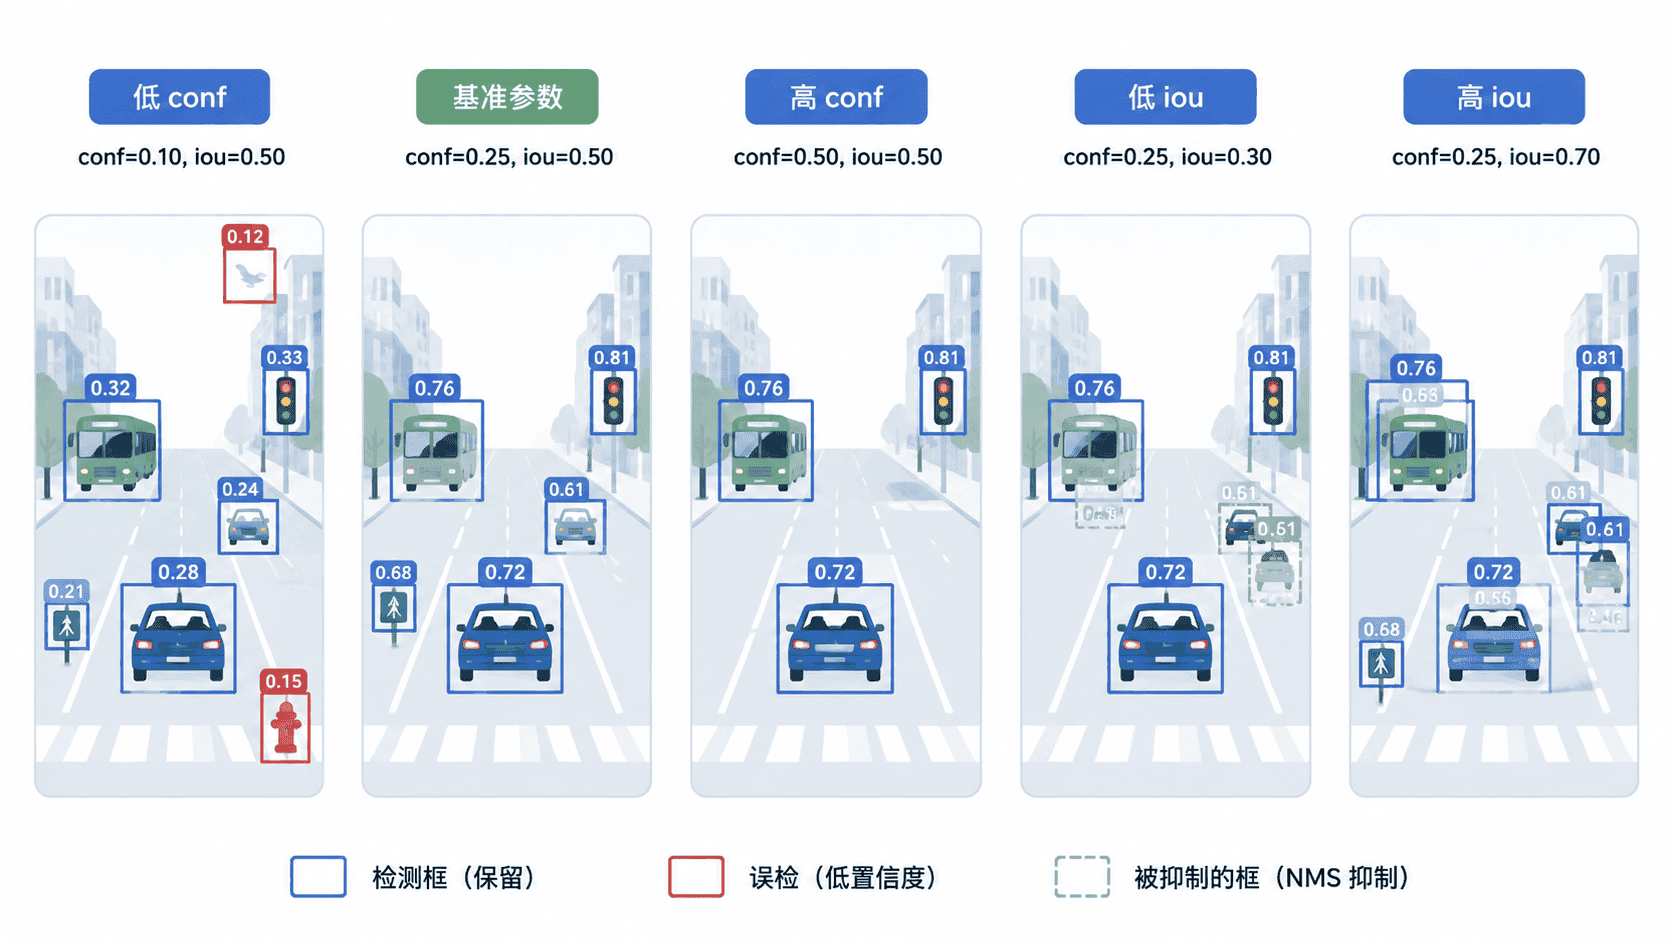
调参时应一次只改变一个参数。否则结果数量变化后,很难判断是置信度过滤还是重叠框抑制造成的。
完整对比实验
下面的程序对同一模型和同一张图片运行五组参数,并输出检测框数量。它先固定 iou 比较三档 conf,再固定 conf 比较三档 iou。
from __future__ import annotations

import argparse

from ultralytics import YOLO

def count_detections(model: YOLO, source: str, conf: float, iou: float) -> int:
    results = model.predict(
        source=source,
        conf=conf,
        iou=iou,
        verbose=False,
    )
    boxes = results[0].boxes
    return 0 if boxes is None else len(boxes)

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--model", default="yolov8n.pt")
    parser.add_argument("--source", required=True)
    args = parser.parse_args()

    model = YOLO(args.model)
    settings = [
        ("低置信度", 0.15, 0.45),
        ("基准", 0.25, 0.45),
        ("高置信度", 0.50, 0.45),
        ("强重叠抑制", 0.25, 0.30),
        ("弱重叠抑制", 0.25, 0.70),
    ]

    for label, conf, iou in settings:
        count = count_detections(model, args.source, conf, iou)
        print(
            f"{label}: conf={conf:.2f}, "
            f"iou={iou:.2f}, detections={count}"
        )

if __name__ == "__main__":
    main()
将代码保存为 compare_thresholds.py,把 <PATH> 替换为实际图片路径后执行:
python compare_thresholds.py --model yolov8n.pt --source <PATH>/crowded.jpg预期输出
低置信度: conf=0.15, iou=0.45, detections=<COUNT_A>
基准: conf=0.25, iou=0.45, detections=<COUNT_B>
高置信度: conf=0.50, iou=0.45, detections=<COUNT_C>
强重叠抑制: conf=0.25, iou=0.30, detections=<COUNT_D>
弱重叠抑制: conf=0.25, iou=0.70, detections=<COUNT_E>
实际数量由图片和权重决定。通常会看到 <COUNT_A> >= <COUNT_B> >= <COUNT_C>,并且 <COUNT_D> <= <COUNT_B> <= <COUNT_E>;没有足够重叠框时也可能出现数量相同。
按业务目标选择起点
下面的范围只用于建立首轮实验起点,最终参数必须在有标注的验证集上确定。
| 业务情况 | conf 起点 |
iou 起点 |
优先观察 |
|---|---|---|---|
| 漏检代价高 | 0.15~0.25 | 0.45~0.70 | 召回率与低分真目标 |
| 误检代价高 | 0.40~0.60 | 0.30~0.50 | 精确率与错误告警 |
| 目标密集且互相遮挡 | 0.20~0.35 | 0.60~0.75 | 相邻目标是否被误删 |
先调整 conf,让候选框数量进入可接受范围;再调整 iou,处理同一目标的重复框或密集目标互相抑制的问题。两步之间应固定模型、图片尺寸和测试数据。
用指标而不是肉眼定阈值
单张图片只能帮助理解参数,不能代表真实业务。正式选择阈值时,应在验证集上记录精确率、召回率和 F1 值,其中 F1 = 2PR / (P + R),再结合业务成本选择平衡点。
全局 conf 对所有类别生效。如果某些类别需要更严格的告警门槛,可以先用较低全局阈值保留候选框,再在解析结果阶段按 class_id 应用不同的业务阈值。
常见误区
提高 conf 不等于模型本身更准确,它只是隐藏了更多低分框。若真目标本来得分偏低,继续提高阈值只会扩大漏检。
提高 iou 通常会保留更多重叠框,而不是加强去重。出现同一目标多个框时,应尝试降低 iou;目标密集时被合并或误删,则可尝试提高 iou。