
计算机视觉 / 系统课时
管理对比实验
管理对比实验
模型优化不能只记录“这次效果更好”,还要保存数据版本、训练参数、随机种子和评估指标。本课将建立可追溯的实验档案,并用单变量对比判断某项调整是否真正有效。
学习目标
- 记录能够复现实验结果的关键信息
- 使用单变量原则设计基线实验和候选实验
- 综合指标变化判断优化是否值得保留
为什么实验必须可追溯
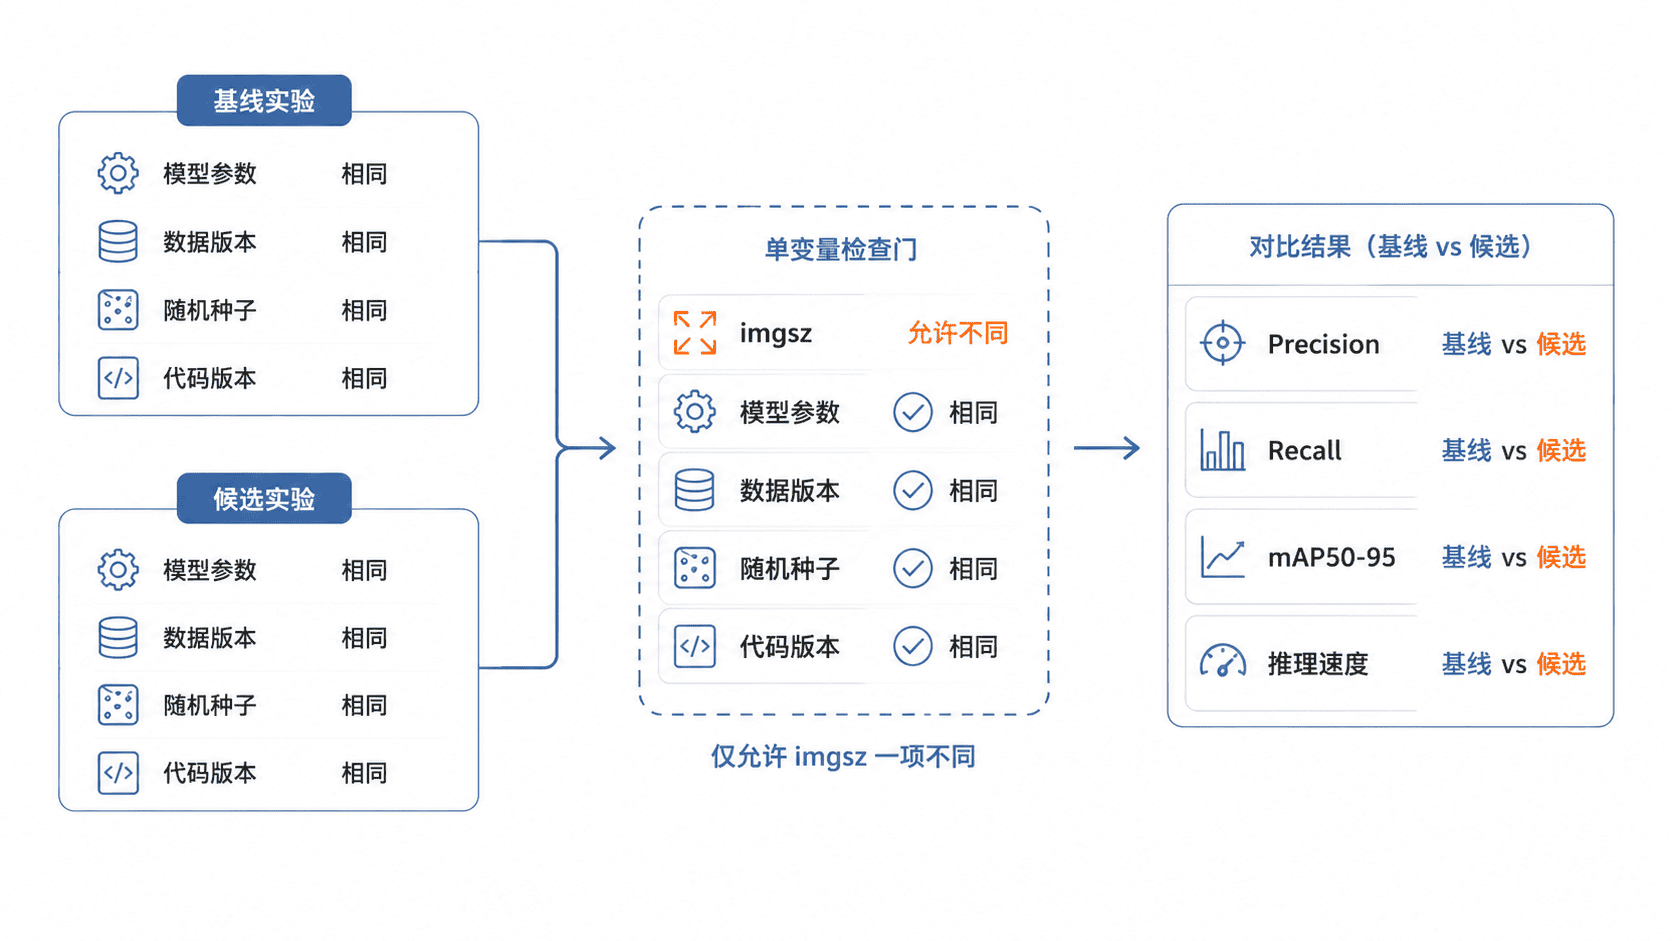
训练结果同时受到数据、模型、参数、代码和随机性的影响。如果一次实验更换了数据集,又调整了图像尺寸和增强参数,即使 mAP 上升,也无法确定是哪项变化产生了效果。
一条完整实验记录至少应包含实验编号、代码版本、数据版本、随机种子、模型与训练参数、验证集指标。模型权重和日志也应使用实验编号归档,避免不同运行结果相互覆盖。
建立最小实验档案
实验编号应保持唯一并具有可读性,例如 exp-001-baseline 和 exp-002-imgsz768。不要只依赖运行目录的创建时间,因为目录复制、迁移或重命名后,时间信息可能失去意义。
下面的完整脚本保存两次实验记录,检查数据版本和随机种子是否一致,并验证候选实验只修改了一个训练参数。
import json
from copy import deepcopy
from pathlib import Path

baseline = {
    'id': 'exp-001',
    'code_version': 'git-abc1234',
    'data_version': 'dataset-v3',
    'seed': 42,
    'params': {'model': 'yolov8n.pt', 'imgsz': 640, 'epochs': 80},
    'metrics': {'map50_95': 0.412, 'precision': 0.781, 'recall': 0.703},
}

candidate = deepcopy(baseline)
candidate['id'] = 'exp-002'
candidate['params']['imgsz'] = 768
candidate['metrics'] = {
    'map50_95': 0.431,
    'precision': 0.776,
    'recall': 0.729,
}

output_dir = Path('experiments')
output_dir.mkdir(exist_ok=True)

# 每次训练单独保存档案,避免后续无法还原实验条件
for experiment in (baseline, candidate):
    path = output_dir / (experiment['id'] + '.json')
    path.write_text(
        json.dumps(experiment, ensure_ascii=False, indent=2),
        encoding='utf-8',
    )

changed = [
    key for key in baseline['params']
    if baseline['params'][key] != candidate['params'][key]
]

# 数据、代码和随机种子必须保持一致,且只允许一个参数发生变化
assert baseline['code_version'] == candidate['code_version']
assert baseline['data_version'] == candidate['data_version']
assert baseline['seed'] == candidate['seed']
assert len(changed) == 1, f'必须只改变一个参数,实际变化:{changed}'

param = changed[0]
before = baseline['params'][param]
after = candidate['params'][param]
print('已保存: experiments/exp-001.json, experiments/exp-002.json')
print(f'唯一变化参数: {param} ({before} -> {after})')

for name in ('map50_95', 'precision', 'recall'):
    old = baseline['metrics'][name]
    new = candidate['metrics'][name]
    print(f'{name}: {old:.3f} -> {new:.3f} ({new - old:+.3f})')
预期输出:
已保存: experiments/exp-001.json, experiments/exp-002.json
唯一变化参数: imgsz (640 -> 768)
map50_95: 0.412 -> 0.431 (+0.019)
precision: 0.781 -> 0.776 (-0.005)
recall: 0.703 -> 0.729 (+0.026)
真实项目中,应在验证完成后把实际指标写入档案。还可以继续记录训练耗时、显存峰值、推理延迟和权重路径,但不要删除最基本的复现字段。
按单变量原则组织实验
先选定一组可稳定复现的参数作为基线,再复制基线并只修改一个待验证变量。数据划分、随机种子、训练轮数和评估脚本应保持一致,否则指标差异会混入其他因素。一次标准对比可以按以下顺序执行:
- 完成基线训练并冻结实验记录。
- 复制基线配置,只修改一个参数。
- 使用同一验证集计算全部指标。
- 保存指标差值、资源开销和结论。
单次结果波动较大时,应使用多个随机种子重复实验,再比较均值和波动范围。单变量原则约束的是每组对比中的主动变化,不代表只能训练一次。
判断优化是否值得保留
候选实验的 map50_95 提升了 0.019,但 Precision 略有下降。这说明更大的输入尺寸可能改善了目标召回和定位,却引入了一些额外误检,不能只依据一个指标直接宣布优化成功。
判断时还应结合业务目标:漏检代价较高时,可以接受小幅 Precision 下降来换取 Recall 提升;设备算力有限时,还要确认更大的图像尺寸是否导致延迟或显存超出预算。
| 检查项 | 需要回答的问题 |
|---|---|
| 检测质量 | 关键类别的 AP、Precision、Recall 是否改善 |
| 稳定性 | 多次运行的结果是否保持相同趋势 |
| 资源开销 | 训练时间、显存和推理延迟是否可接受 |
| 可复现性 | 数据、代码、参数和随机种子是否完整记录 |
常见实验管理错误
- 同时修改模型、数据增强和图像尺寸,导致无法归因。
- 只保存最佳权重,没有保存参数、数据版本和评估结果。
- 使用不同验证集比较指标,使数值失去可比性。
- 只报告提升最大的实验,不保留失败实验和判断依据。
失败实验同样具有价值。记录哪些调整无效,可以避免团队成员重复消耗训练资源,也能帮助后续分析不同参数之间的关系。