
计算机视觉 / 系统课时
监控线上模型
监控线上模型
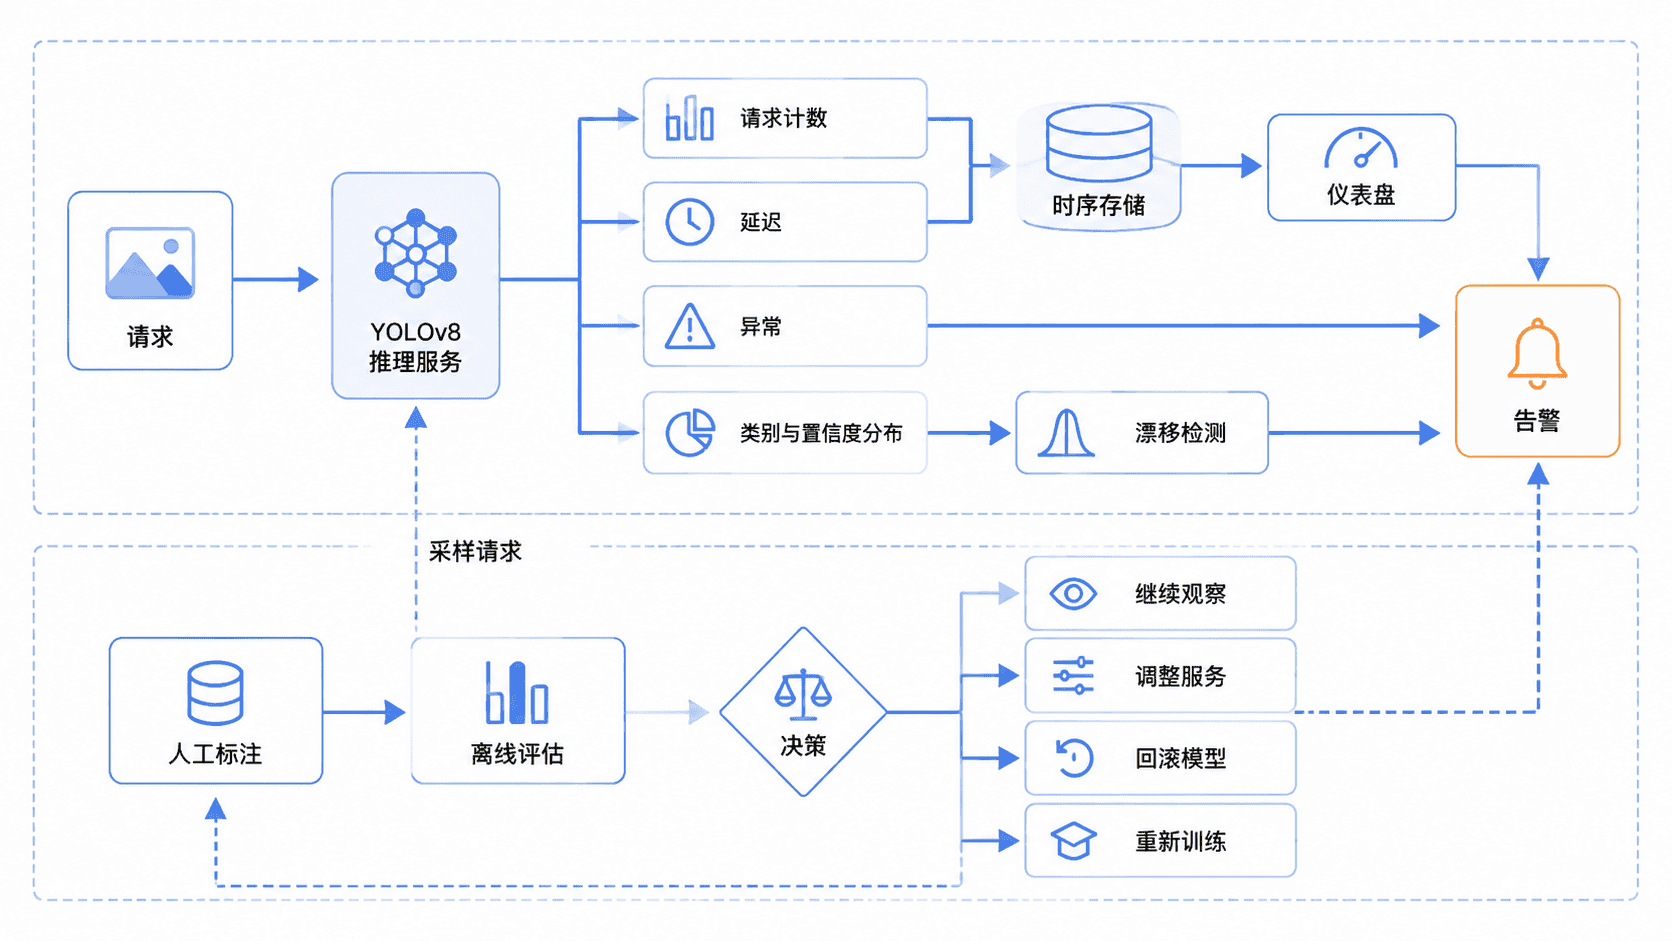
模型成功部署不代表任务结束,线上输入、流量和运行环境会持续变化。本课将建立最小监控闭环,把请求量、延迟、异常、预测分布和漂移指标放在同一条链路中,并给出可执行的告警判断示例。
学习目标
- 区分服务可用性、预测行为和真实业务效果三类监控信号
- 计算请求量、P95 延迟、异常率、类别分布和 PSI 漂移指标
- 按固定顺序定位告警,并判断应修复服务、调整阈值还是回滚模型
先把监控拆成四层
第一层是流量,包括请求量、并发量和输入来源;第二层是系统性能,包括排队时间、预处理、推理、后处理延迟以及 CPU、GPU、显存;第三层是预测行为,包括类别、框数量、置信度和空结果比例;第四层才是真实效果,需要抽样标注、用户反馈或业务结果来计算准确率。
线上通常无法立即获得真值,因此类别分布或平均置信度只能提示风险,不能直接证明准确率下降。可靠做法是用实时代理指标发现异常,再通过带标签样本确认是否需要重训或回滚。
定义指标与告警门槛
告警阈值应来自服务等级目标和稳定期基线,而不是长期照搬固定数字。下面的数值只用于演示起始规则,部署后应按模型、硬件和业务峰谷分别校准。
| 指标 | 计算方式 | 示例门槛 | 首要检查 |
|---|---|---|---|
| 请求量 | 时间窗口内请求数 | 较同周期下降 40% | 网关、调用方、采样 |
| P95 延迟 | 95% 请求不超过的耗时 | 高于 100 ms | 排队、GPU、批处理 |
| 异常率 | 异常请求数 ÷ 总请求数 | 高于 5% | 输入、模型加载、资源 |
| PSI | 基线与当前分布差异 | 高于 0.25 | 数据源、场景、类别分布 |
PSI 对每个区间或类别计算 后求和,其中 是基线占比, 是当前占比。类别缺失时要加入很小的平滑值,避免除零或对零取对数。
用可运行脚本验证监控逻辑
下面的完整脚本模拟 10 次推理记录,计算请求量、P95 延迟、异常率、成功请求的类别分布和 PSI,并依据示例阈值生成告警。真实服务中应把同样的字段写入指标系统或结构化日志。
import json
import math
from collections import Counter

BASELINE = {"person": 0.60, "car": 0.30, "dog": 0.10}
RECORDS = [
    {"latencyMs": 42, "error": False, "class": "car"},
    {"latencyMs": 45, "error": False, "class": "car"},
    {"latencyMs": 47, "error": False, "class": "person"},
    {"latencyMs": 50, "error": False, "class": "car"},
    {"latencyMs": 52, "error": False, "class": "car"},
    {"latencyMs": 55, "error": False, "class": "dog"},
    {"latencyMs": 58, "error": False, "class": "car"},
    {"latencyMs": 62, "error": False, "class": "person"},
    {"latencyMs": 68, "error": False, "class": "car"},
    {"latencyMs": 120, "error": True, "class": None},
]

def percentile_nearest_rank(values: list[int], percent: float) -> int:
    ordered = sorted(values)
    index = math.ceil(percent * len(ordered)) - 1
    return ordered[index]

def class_distribution(records: list[dict]) -> dict[str, float]:
    classes = [record["class"] for record in records if not record["error"]]
    counts = Counter(classes)
    total = len(classes)
    return {name: counts[name] / total for name in BASELINE}

def population_stability_index(
    baseline: dict[str, float], current: dict[str, float]
) -> float:
    epsilon = 1e-6
    total = 0.0
    for name in baseline:
        expected = max(baseline[name], epsilon)
        actual = max(current[name], epsilon)
        total += (actual - expected) * math.log(actual / expected)
    return total

def main() -> None:
    request_count = len(RECORDS)
    error_count = sum(record["error"] for record in RECORDS)
    current = class_distribution(RECORDS)
    p95 = percentile_nearest_rank(
        [record["latencyMs"] for record in RECORDS], 0.95
    )
    error_rate = error_count / request_count
    psi = population_stability_index(BASELINE, current)

    alerts = []
    if p95 > 100:
        alerts.append("P95_LATENCY_HIGH")
    if error_rate > 0.05:
        alerts.append("ERROR_RATE_HIGH")
    if psi > 0.25:
        alerts.append("OUTPUT_DISTRIBUTION_DRIFT")

    # 保留稳定字段名,方便后续接入 Prometheus、日志平台或告警系统
    summary = {
        "requestCount": request_count,
        "p95LatencyMs": p95,
        "errorRate": round(error_rate, 4),
        "classDistribution": {
            name: round(value, 4) for name, value in current.items()
        },
        "psi": round(psi, 4),
        "alerts": alerts,
    }
    print(json.dumps(summary, ensure_ascii=False, indent=2))

if __name__ == "__main__":
    main()
预期输出
{
  "requestCount": 10,
  "p95LatencyMs": 120,
  "errorRate": 0.1,
  "classDistribution": {
    "person": 0.2222,
    "car": 0.6667,
    "dog": 0.1111
  },
  "psi": 0.6692,
  "alerts": [
    "P95_LATENCY_HIGH",
    "ERROR_RATE_HIGH",
    "OUTPUT_DISTRIBUTION_DRIFT"
  ]
}
把指标接入线上链路
每次请求应携带可追踪的请求 ID,并记录模型版本、输入来源、各阶段耗时、检测数量、主要类别、置信度统计和异常类型。原始图片通常不应直接写入日志,可按合规要求保存脱敏后的抽样数据或对象存储引用。
实时计数和延迟直方图适合进入时序指标系统;单请求明细适合进入结构化日志;输入与预测分布适合按小时或天汇总。仪表盘必须能按模型版本、设备、区域、调用方和时间窗口切分,否则总体均值会掩盖局部退化。
发现漂移后的定位顺序
先确认采样、埋点和基线窗口没有变化,再按调用方、区域、设备和模型版本切片。随后比较图像尺寸、亮度、目标数量、类别和置信度分布,定位变化来自数据源还是模型服务。最后抽取告警窗口样本补充真值,重新计算精确率、召回率或业务成功率。
只有服务错误或资源瓶颈时,应优先修复部署与容量;输入合法但新场景明显增加时,应补充数据并重训;新版本独有且影响业务时,可以先回滚到已验证版本。单独看到 PSI 升高,不应直接宣布模型失效。