
计算机视觉 / 系统课时
解析检测结果
解析检测结果
完成一次 YOLOv8 推理后,真正交给业务系统的通常不是带框图片,而是可序列化的检测数据。本课将从 Results 对象中提取边界框、类别、名称和置信度,并整理成稳定的 JSON 结构。
学习目标
- 理解
Results、Boxes与单个检测框之间的层级关系 - 正确读取
xyxy、cls、conf和names - 将张量结果转换为业务可用的 Python 字典和 JSON
结果对象的层级
model.predict() 返回一个 Results 列表,每个元素对应一张输入图像。单个 Results 对象保存原图尺寸、输入路径和检测框集合;result.boxes 中的每个元素代表一个目标。
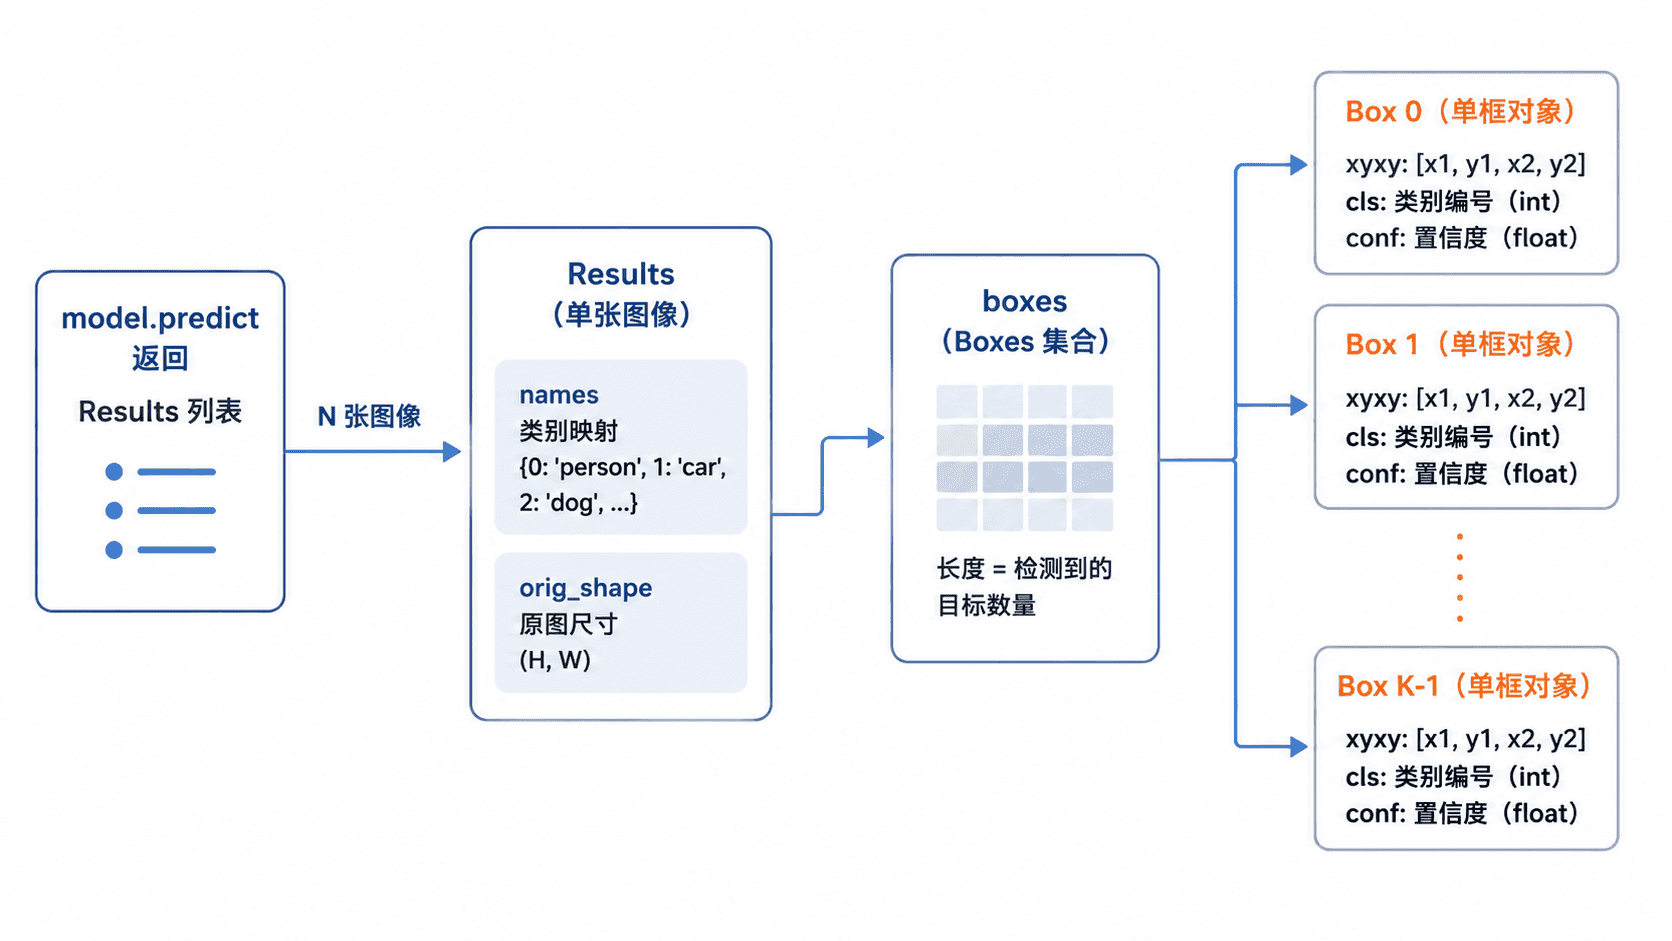
常用字段的职责如下:
box.xyxy:左上角和右下角坐标,顺序为[x1, y1, x2, y2]box.cls:类别编号,需要转换为整数box.conf:置信度,需要转换为普通浮点数result.names:类别编号到类别名称的映射result.orig_shape:原图尺寸,顺序为(高度, 宽度)
完整解析示例
下面的程序接收模型文件和图片路径,执行推理后输出可直接传给接口、写入文件或保存到数据库的 JSON。代码使用 round() 控制小数位,避免张量浮点数产生过长尾数。
python
from __future__ import annotations

import argparse
import json
from typing import Any

from ultralytics import YOLO

def parse_result(result: Any) -> dict[str, Any]:
    detections: list[dict[str, Any]] = []

    if result.boxes is not None:
        for box in result.boxes:
            # 将张量转换为 Python 基础类型,保证后续可以 JSON 序列化
            x1, y1, x2, y2 = [
                round(float(value), 2)
                for value in box.xyxy[0].tolist()
            ]
            class_id = int(box.cls[0].item())
            confidence = round(float(box.conf[0].item()), 4)

            detections.append(
                {
                    "bbox_xyxy": [x1, y1, x2, y2],
                    "class_id": class_id,
                    "class_name": result.names[class_id],
                    "confidence": confidence,
                }
            )

    height, width = result.orig_shape
    return {
        "source": str(result.path),
        "image_width": width,
        "image_height": height,
        "detections": detections,
    }

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--model", default="yolov8n.pt")
    parser.add_argument("--source", required=True)
    args = parser.parse_args()

    model = YOLO(args.model)
    results = model.predict(source=args.source, verbose=False)
    payload = [parse_result(result) for result in results]

    print(json.dumps(payload, ensure_ascii=False, indent=2))

if __name__ == "__main__":
    main()
将代码保存为 parse_results.py,并把 <PATH> 替换为实际图片路径后执行:
bash
python parse_results.py --model yolov8n.pt --source <PATH>/bus.jpg预期输出
text
[
  {
    "source": "<PATH>/bus.jpg",
    "image_width": <WIDTH>,
    "image_height": <HEIGHT>,
    "detections": [
      {
        "bbox_xyxy": [<X1>, <Y1>, <X2>, <Y2>],
        "class_id": <ID>,
        "class_name": "<NAME>",
        "confidence": <SCORE>
      }
    ]
  }
]
模型版本、权重和输入图片不同,框数量及数值会变化,但字段结构应与示例一致。
面向业务调整数据结构
边界框格式必须与下游约定一致。前端绘制通常适合 xyxy,而部分接口可能要求 [x, y, width, height]。转换时可使用 width = x2 - x1、height = y2 - y1,并明确坐标是像素值还是归一化比例。
类别编号适合机器处理,类别名称适合展示,两者最好同时保留。只保存名称会让后续类别重命名和多语言转换变得困难;只保存编号又会增加前端查询映射的成本。
关键边界处理
当图像中没有目标时,detections 应返回空数组,而不是 null 或省略字段。这样调用方可以稳定遍历结果,不必为不同响应形态增加分支。
批量推理时,一个 Results 对象只对应一张图,不能把所有框误认为来自同一输入。需要保留 source 或业务图片 ID,确保检测数据能准确回关联原始文件。
按自己的节奏,确认真正理解。