
计算机视觉 / 系统课时
规划部署方案
规划部署方案
部署前最重要的工作不是立即导出某种格式,而是先确定模型运行在哪里、由谁调用、能否上传图像以及必须达到什么性能。本课将比较四类常见部署路径,并建立一份可验证的部署决策记录,避免在格式转换后才发现方案不适用。
学习目标
- 比较本地脚本、后端服务、边缘设备和浏览器部署
- 把延迟、吞吐、隐私、离线与兼容性要求写成验收条件
- 使用部署计划文件和校验脚本发现明显冲突
先写清不可协商的约束
部署选择至少要回答六个问题:单帧允许多长延迟、每路视频最低帧率、同时处理多少路输入、原始图像能否离开现场、断网时是否必须工作,以及目标设备能否提供 GPU 或专用加速器。
性能指标应写成可测量的门槛,例如“4 路视频下,每路不低于 20 FPS,端到端 P95 延迟不超过 120 ms”。不要只写“速度要快”,也不要把模型推理时间误当作完整延迟;采集、编码、网络、排队、后处理和返回都要计入。
四种部署路径的本质差异
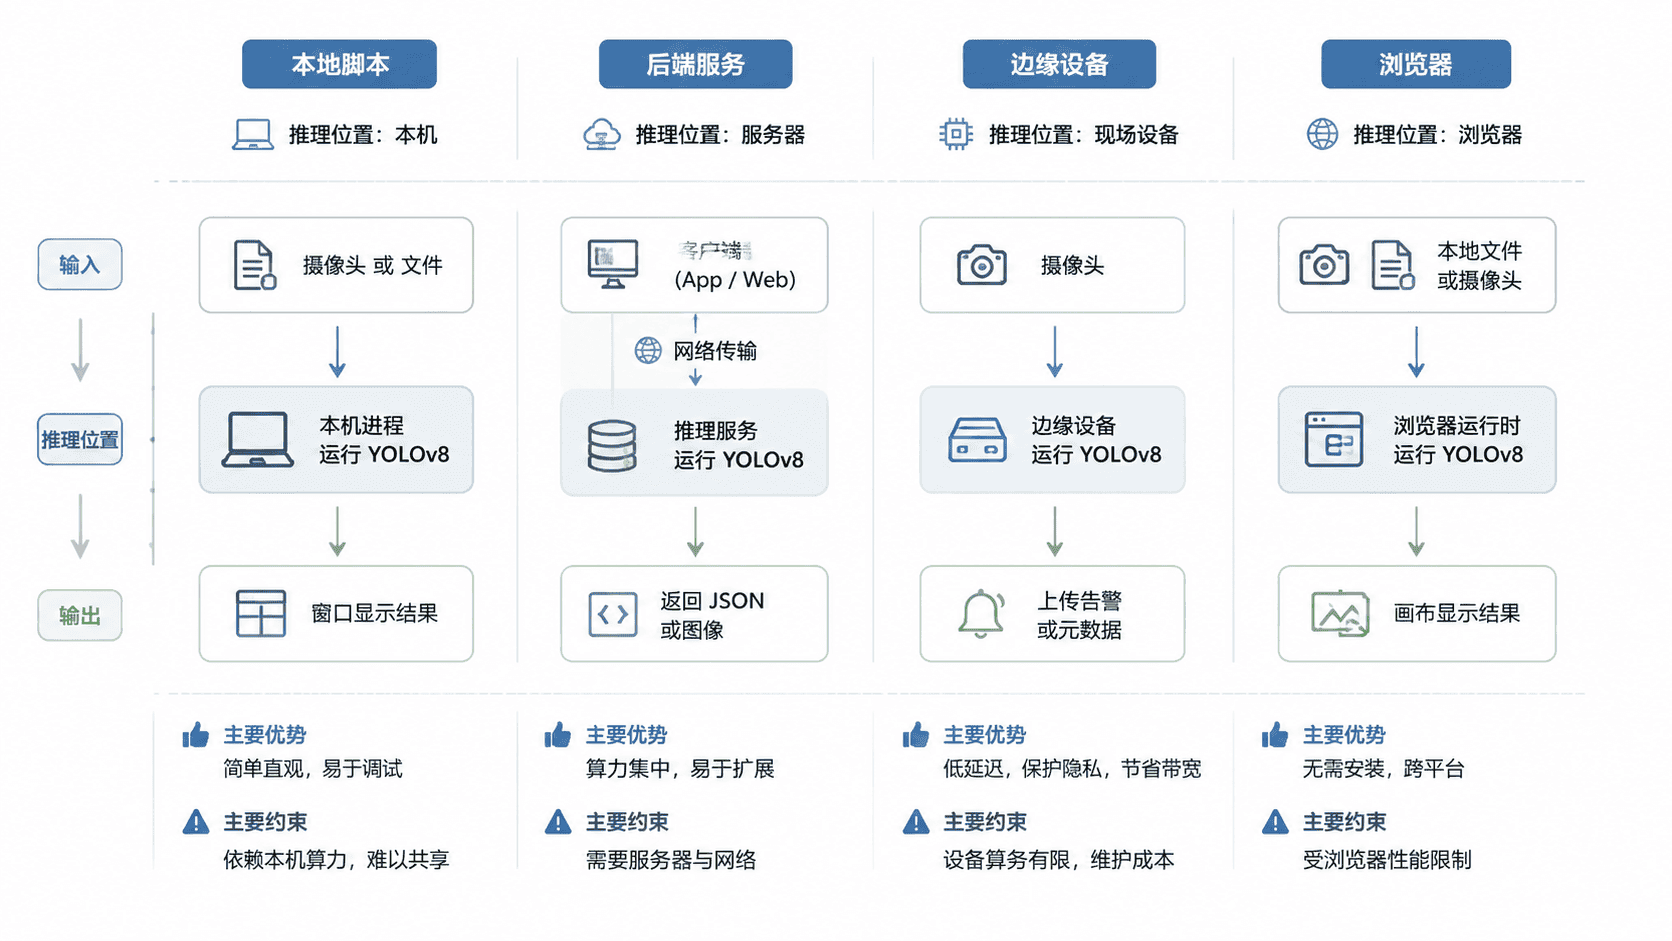
| 方案 | 最适合的场景 | 主要优势 | 主要约束 |
|---|---|---|---|
| 本地脚本 | 单机工具、离线分析、内部验证 | 开发快,调试直接,链路短 | 并发与更新能力有限 |
| 后端服务 | 多客户端共享模型、统一版本管理 | 集中扩容、监控和灰度发布 | 受网络、排队和数据合规影响 |
| 边缘设备 | 摄像头现场、低延迟、数据不出域 | 可离线运行,原始图像留在现场 | 硬件差异大,升级与运维更复杂 |
| 浏览器 | 轻量交互、免安装演示、前端隐私处理 | 无需独立客户端,数据可本地处理 | 浏览器兼容性、内存和算力波动明显 |
先决定推理位置,再选择运行时和模型格式。后端 NVIDIA GPU 可能适合 TensorRT,通用 CPU 环境可能选择 ONNX Runtime 或 OpenVINO,浏览器则要考虑 WebAssembly 或 WebGPU 支持。具体格式必须以目标硬件上的实测结果为准。
建立可审查的部署计划
下面的 JSON 不是模型配置,而是一份部署决策记录。它把场景、SLA、数据边界、目标硬件、运行时和基准测试方法固定下来,便于开发、测试和运维使用同一组验收条件。
{
  "scenario": "factory-camera",
  "input": {
    "source": "rtsp",
    "streams": 4,
    "resolution": "1280x720"
  },
  "sla": {
    "p95LatencyMs": 120,
    "minFpsPerStream": 20
  },
  "constraints": {
    "offlineRequired": true,
    "imageUploadAllowed": false
  },
  "target": {
    "placement": "edge",
    "os": "linux",
    "accelerator": "nvidia-gpu"
  },
  "runtime": {
    "format": "engine",
    "precision": "fp16"
  },
  "acceptance": {
    "warmupRuns": 20,
    "benchmarkRuns": 200
  }
}
这份配置的生效行为是“约束后续实现与验收”,它本身不会证明方案已经达标。保存为 deployment-plan.json 后,应由校验脚本检查字段完整性与明显冲突,再在目标设备上执行真实基准测试。
校验计划中的明显冲突
下面的完整脚本验证必填字段、数值范围和三类常见矛盾:要求离线却选择后端、禁止上传图像却选择后端、选择 TensorRT Engine 却没有 NVIDIA GPU。
import json
import sys
from pathlib import Path
from typing import Any

REQUIRED_PATHS = [
    ("scenario",),
    ("input", "streams"),
    ("sla", "p95LatencyMs"),
    ("sla", "minFpsPerStream"),
    ("constraints", "offlineRequired"),
    ("constraints", "imageUploadAllowed"),
    ("target", "placement"),
    ("target", "accelerator"),
    ("runtime", "format"),
    ("runtime", "precision"),
    ("acceptance", "warmupRuns"),
    ("acceptance", "benchmarkRuns"),
]

def get_value(data: dict[str, Any], path: tuple[str, ...]) -> Any:
    current: Any = data
    for key in path:
        if not isinstance(current, dict) or key not in current:
            raise ValueError(f"缺少字段: {'.'.join(path)}")
        current = current[key]
    return current

def validate(plan: dict[str, Any]) -> None:
    for path in REQUIRED_PATHS:
        get_value(plan, path)

    positive_paths = [
        ("input", "streams"),
        ("sla", "p95LatencyMs"),
        ("sla", "minFpsPerStream"),
        ("acceptance", "warmupRuns"),
        ("acceptance", "benchmarkRuns"),
    ]
    for path in positive_paths:
        value = get_value(plan, path)
        if not isinstance(value, int) or value <= 0:
            raise ValueError(f"{'.'.join(path)} 必须是正整数")

    placement = plan["target"]["placement"]
    offline_required = plan["constraints"]["offlineRequired"]
    upload_allowed = plan["constraints"]["imageUploadAllowed"]
    runtime_format = plan["runtime"]["format"]
    accelerator = plan["target"]["accelerator"]

    # 后端方案依赖网络和图像传输,与这两类硬约束直接冲突。
    if placement == "server" and offline_required:
        raise ValueError("要求离线运行时不能选择 server")
    if placement == "server" and not upload_allowed:
        raise ValueError("禁止上传图像时不能选择 server")

    # TensorRT Engine 需要与 NVIDIA GPU 目标保持一致。
    if runtime_format == "engine" and accelerator != "nvidia-gpu":
        raise ValueError("format=engine 时 accelerator 必须是 nvidia-gpu")

def main() -> None:
    if len(sys.argv) != 2:
        raise SystemExit("用法: python validate_plan.py <PLAN_PATH>")

    plan_path = Path(sys.argv[1])
    plan = json.loads(plan_path.read_text(encoding="utf-8"))
    validate(plan)

    print(
        "OK: "
        f"{plan['target']['placement']} / "
        f"{plan['runtime']['format']} / "
        f"{plan['runtime']['precision']}"
    )
    print(
        "SLA: "
        f"p95 <= {plan['sla']['p95LatencyMs']} ms, "
        f"throughput >= {plan['sla']['minFpsPerStream']} FPS/stream"
    )
    print(
        "Benchmark: "
        f"{plan['input']['streams']} streams, "
        f"warmup {plan['acceptance']['warmupRuns']}, "
        f"samples {plan['acceptance']['benchmarkRuns']}"
    )

if __name__ == "__main__":
    main()
预期结果:脚本读取计划文件并完成静态校验;存在缺失字段或逻辑冲突时会直接抛出错误,不会进入后续部署环节。
运行校验并形成结论
将脚本保存为 validate_plan.py,然后执行:
python validate_plan.py deployment-plan.json预期输出如下:
OK: edge / engine / fp16
SLA: p95 <= 120 ms, throughput >= 20 FPS/stream
Benchmark: 4 streams, warmup 20, samples 200
静态校验通过只说明方案没有明显自相矛盾。最终决策仍要在目标设备上测量冷启动、预热后 P50/P95 延迟、持续吞吐、峰值内存、并发稳定性和错误恢复,并保留原始模型作为精度对照。
选择方案的最短路径
原始图像不能离开现场或必须断网运行时,优先考虑边缘设备或本地脚本;多个客户端需要共享模型、统一升级和集中监控时,优先考虑后端服务;交互轻量且目标浏览器能力可控时,再评估浏览器部署。
同一业务也可以采用混合方案,例如边缘设备完成检测,只把告警、类别、置信度和时间戳上传后端。混合方案能同时降低带宽和隐私风险,但会增加设备管理、版本一致性和故障定位成本。