
计算机视觉 / 系统课时
YOLO 系列演进
YOLO 系列演进
本课帮助你建立 YOLO 系列的整体脉络。你将理解“一次前向计算完成检测”的核心思想,认识主要版本围绕精度、速度、训练方式和任务扩展所做的改进,并明确 YOLOv8 适合实战项目的原因。
学习目标
- 解释 YOLO 检测器追求实时性的核心思路
- 从关键能力而非版本编号理解 YOLO 的演进方向
- 认识 YOLOv8 在训练、推理和多任务支持上的特点
YOLO 的核心思想
YOLO 是 “You Only Look Once” 的缩写。它的核心不是某个固定网络结构,而是把目标检测视为一次端到端预测:模型读取整张图像,在一次前向计算中直接输出目标位置、类别和置信度。
早期检测方法常把候选区域生成、特征提取和分类拆成多个阶段。YOLO 将这些步骤统一到一个网络中,减少了重复计算,因此更容易获得实时推理速度。不过,早期版本对小目标和密集目标的定位能力相对有限,后续版本一直在改进这些问题。
版本演进看什么
理解 YOLO 演进时,不必死记所有版本细节,可以关注四条主线:骨干网络如何提取特征,多尺度特征如何融合,检测头如何输出结果,以及训练与部署流程是否更易用。
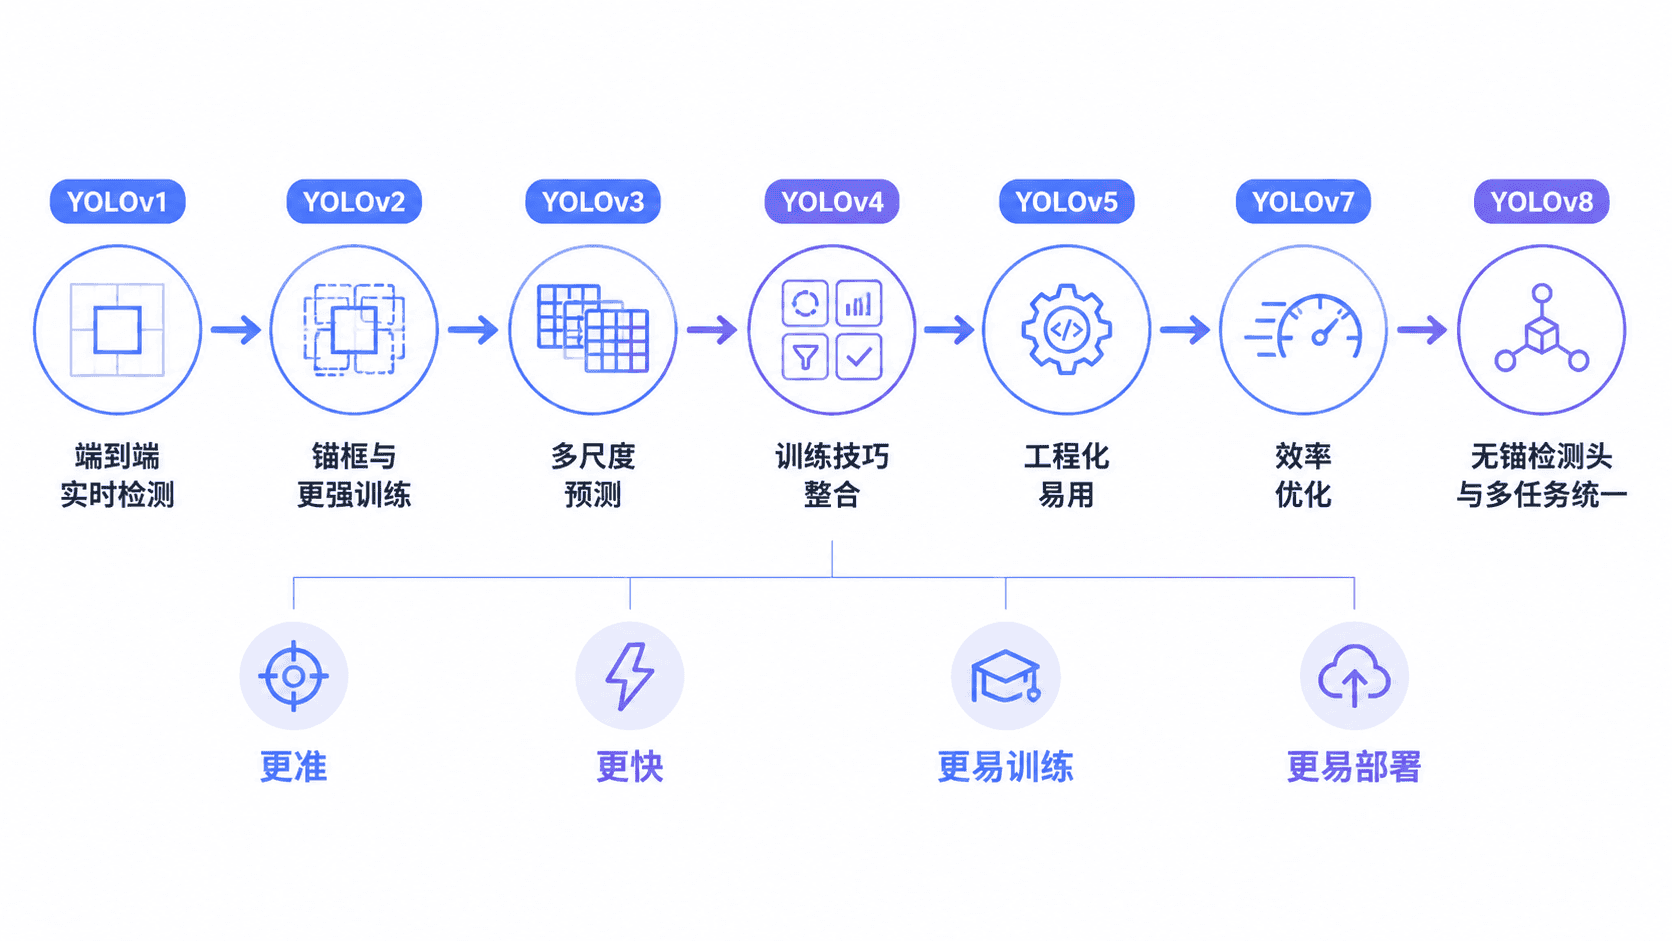
YOLOv1 奠定了单阶段、端到端实时检测的思路。YOLOv2 和 YOLOv3 逐步引入更强的特征提取、多尺度预测等机制,使模型能处理不同大小的目标。之后的多个实现继续优化训练策略、网络结构和工程体验。
YOLOv5 因完整的 PyTorch 工程、清晰的训练脚本和便捷的导出流程得到广泛使用。YOLOv7 进一步强调速度与精度的平衡。YOLOv8 则在统一接口、无锚检测头和多任务支持方面提供了更完整的实战体验。
需要注意,YOLO 系列并不是一条由单一团队连续维护的简单产品线。不同版本可能来自不同研究团队或开源组织,因此比较时应看论文、代码仓库、任务支持和部署条件,而不能只按数字大小判断优劣。
YOLOv8 的主要特点
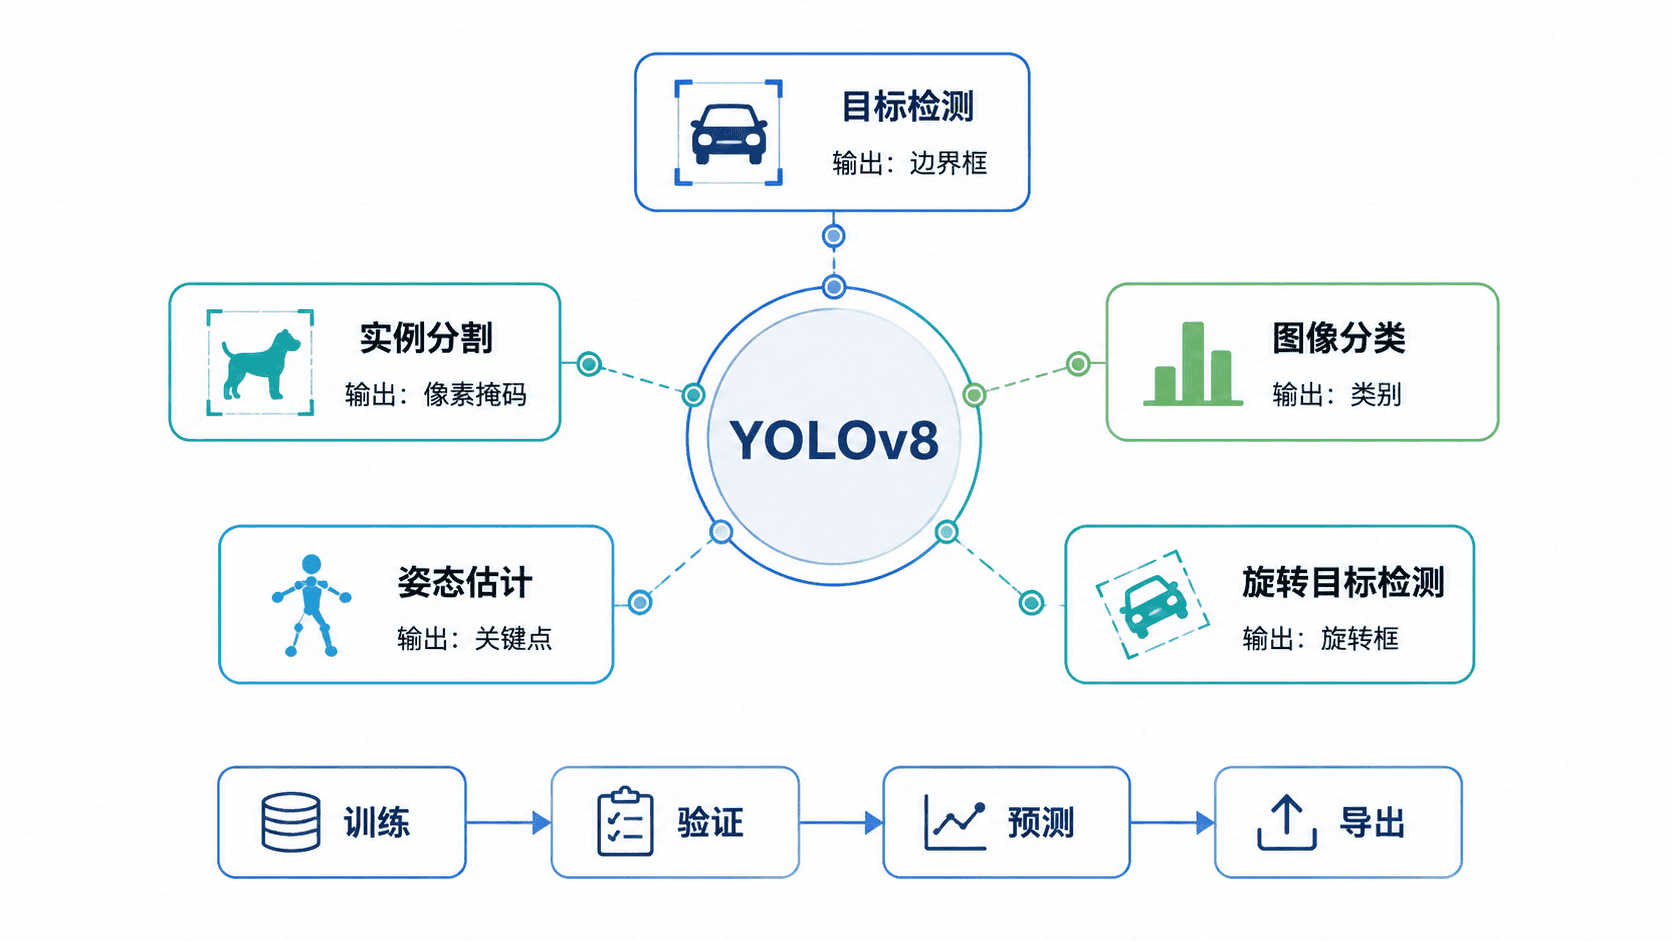
YOLOv8 采用更统一的使用方式,同一套工具可以完成模型训练、验证、预测和导出。对初学者而言,这减少了脚本切换和参数理解成本;对项目开发者而言,也更容易把实验代码迁移到部署流程。
在目标检测中,YOLOv8 使用无锚思路,不再依赖预先为数据集手工聚类一组锚框尺寸。模型直接学习目标位置,配置更简洁,也减少了锚框与数据分布不匹配带来的额外调试。
YOLOv8 不只支持目标检测,还覆盖图像分类、实例分割、姿态估计和旋转目标检测等任务。它们共享相近的训练与推理入口,但输出结构和评价指标不同,使用时仍要根据业务选择正确任务类型。
为什么实战常选择 YOLOv8
YOLOv8 的优势不只是“速度快”。它提供预训练模型、统一命令入口、较完整的数据集约定和多种导出格式,能让学习者更快完成从数据准备到结果验证的闭环。
选择模型时仍要结合设备和目标特征。轻量模型适合边缘设备和低延迟场景,大模型通常有更高的精度上限,但训练时间、显存占用和推理成本也更高。版本更新并不会自动解决数据质量、类别不平衡和场景差异问题。