
计算机视觉 / 系统课时
使用命令行训练
使用命令行训练
本课将把已经整理好的 YOLO 格式数据集交给 Ultralytics 命令行,完成一次可复现的 YOLOv8 自定义检测训练。你会配置数据集、预训练权重、轮次、图像尺寸与输出目录,并能从日志和权重文件判断训练是否真正完成。
学习目标
- 编写并检查目标检测数据集的
data.yaml - 使用一条完整命令启动 YOLOv8 训练
- 根据训练日志、权重和验证指标完成验收
训练前检查
命令行训练的核心关系是:model 指定起点权重,data 描述训练集和验证集,其他参数控制训练规模与输出位置。Ultralytics CLI 使用 yolo TASK MODE 参数=值 的形式,检测训练对应 yolo detect train。:contentReference[oaicite:0]{index=0}
先确认数据集采用常见目录结构:图像放在 images/train、images/val,同名标签放在 labels/train、labels/val。每个标签文件中的类别编号必须能在 names 中找到。
path: <PATH>/helmet-dataset
train: images/train
val: images/val
names:
  0: helmet
  1: no_helmet
这段配置不会直接产生控制台输出。保存为 <PATH>/helmet-dataset/data.yaml 后,应检查 path 指向真实目录,训练集与验证集均存在图片,类别编号从 0 连续开始。数据集 YAML 用于声明路径、数据划分和类别名称。:contentReference[oaicite:1]{index=1}
启动第一次训练
在已安装 ultralytics 的虚拟环境中执行下面的主命令。示例从轻量级 yolov8n.pt 预训练权重开始,适合先验证数据和训练链路;正式实验再根据显存与精度目标调整模型规模。
yolo detect train model=yolov8n.pt data=<PATH>/helmet-dataset/data.yaml epochs=50 imgsz=640 batch=8 device=0 project=<PATH>/runs/detect name=first-train预期输出
Ultralytics <VERSION> Python-<VERSION> torch-<VERSION> CUDA:<VERSION>
Starting training for 50 epochs...
50 epochs completed in <TIME>.
Results saved to <PATH>/runs/detect/first-train
实际版本号、耗时和日志行数会不同。没有 NVIDIA GPU 时删除 device=0 或改为 device=cpu;CPU 也能训练,但耗时通常更长。YOLOv8 官方用法同样以预训练模型、数据集、轮次和图像尺寸作为主要训练参数。:contentReference[oaicite:2]{index=2}
理解关键参数
| 参数 | 本例取值 | 作用与调整原则 |
|---|---|---|
model |
yolov8n.pt |
指定预训练权重;模型越大,通常显存和计算量越高 |
data |
data.yaml |
指向数据集配置文件,而不是图片目录 |
epochs |
50 |
完整遍历训练集的次数;首次训练先观察收敛趋势 |
imgsz |
640 |
输入图像尺寸;增大可能改善小目标表现,也会增加显存占用 |
batch |
8 |
每次迭代的样本数;显存不足时优先降低 |
project、name |
自定义目录 | 固定实验产物位置,便于比较不同训练结果 |
不要在第一次运行时同时修改过多超参数。先用稳定的小模型和较小批量跑通全流程,再根据验证指标调整轮次、图像尺寸、模型规模或数据增强。
训练流程与产物
训练时,CLI 会解析参数,读取 data.yaml,加载预训练权重,循环执行训练与验证,最后把日志、图表和权重写入实验目录。这个流程涉及多个对象和产物,用图示更容易建立整体认识。
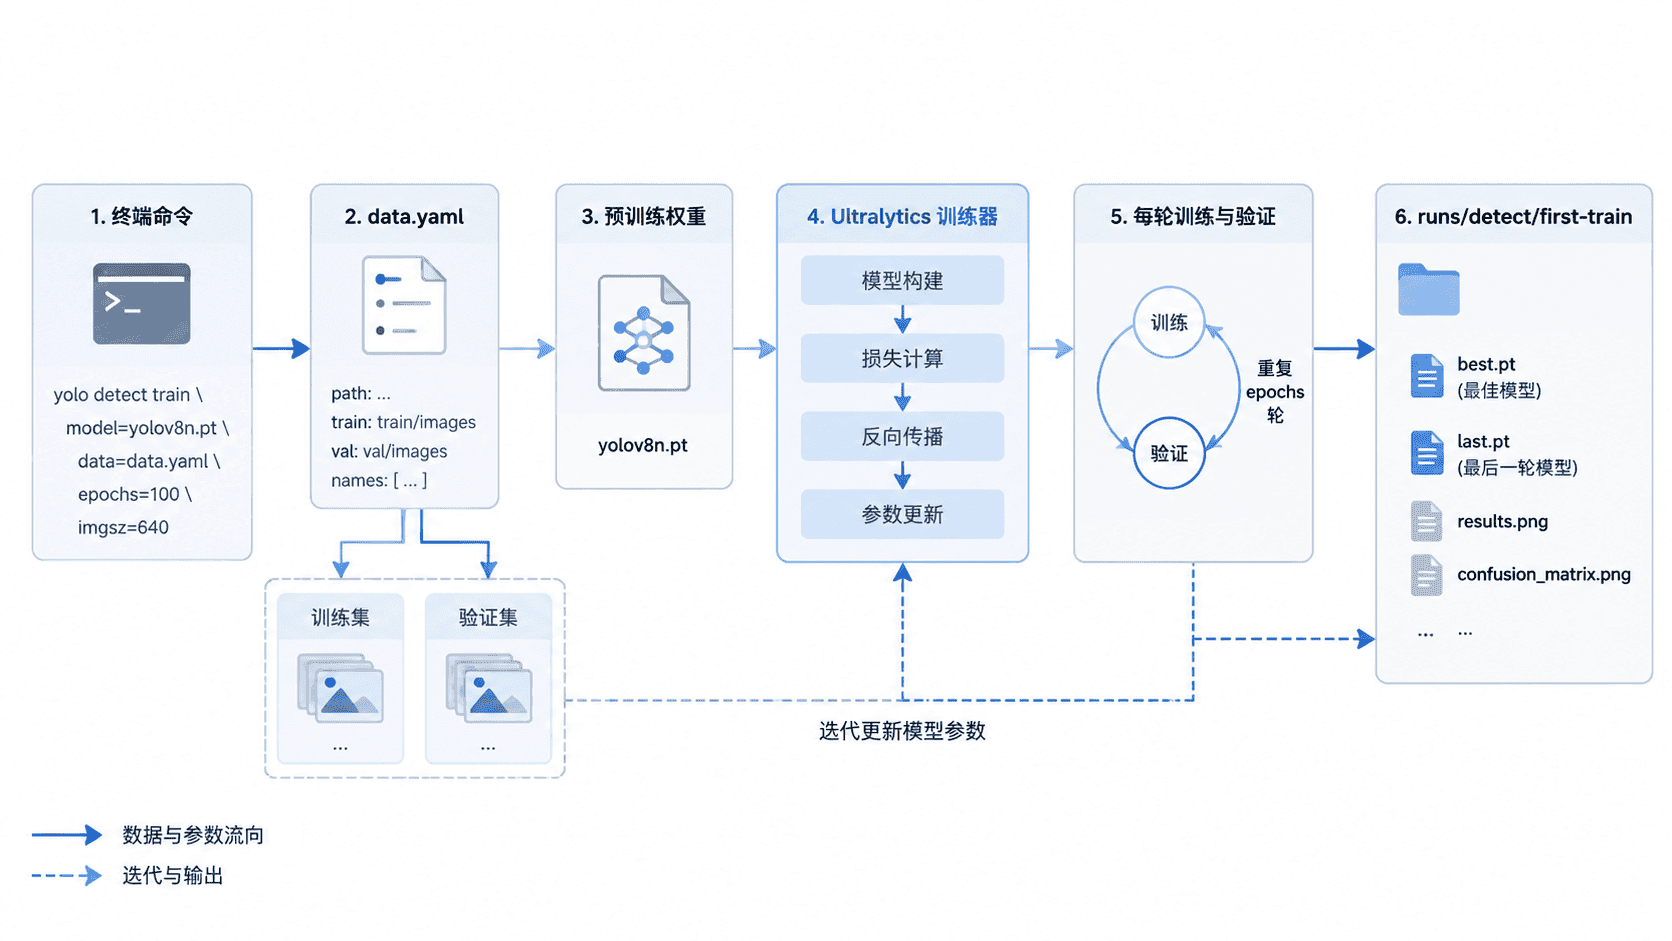
训练成功后重点检查 <PATH>/runs/detect/first-train/weights/best.pt 和 last.pt。best.pt 通常用于后续验证与推理,last.pt 保存最后一轮状态;目录中还会包含训练曲线和结果文件,具体文件名可能随 Ultralytics 版本变化。
验证训练结果
仅看到进度条结束还不够,应该使用最佳权重在验证集上重新评估。下面的命令沿用同一份 data.yaml,因此验证类别与训练类别保持一致。
yolo detect val model=<PATH>/runs/detect/first-train/weights/best.pt data=<PATH>/helmet-dataset/data.yaml imgsz=640预期输出
Class     Images  Instances  Box(P)  R  mAP50  mAP50-95
all       <COUNT> <COUNT>    <VALUE> <VALUE> <VALUE> <VALUE>
Results saved to <PATH>/runs/detect/val
指标值取决于数据集,不能预先固定。验收标准是命令无路径或标签错误、能够加载 best.pt,并输出验证集的 Precision、Recall 与 mAP 等指标,而不是要求第一次训练就达到某个统一分数。
常见失败处理
出现 Dataset not found 时,先检查 data.yaml 的实际位置及其中的 path,不要只修改训练命令。出现类别越界或标签格式错误时,检查标签首列是否落在 0 到类别数减一之间,并确认每行采用 class x_center y_center width height 的归一化格式。
出现 CUDA 显存不足时,先把 batch 从 8 降为 4 或 2;仍不足再降低 imgsz。若训练目录自动变成 first-train2,说明同名目录已经存在,这是为避免覆盖旧实验而进行的编号递增。