
计算机视觉 / 系统课时
训练与迭代模型
训练与迭代模型
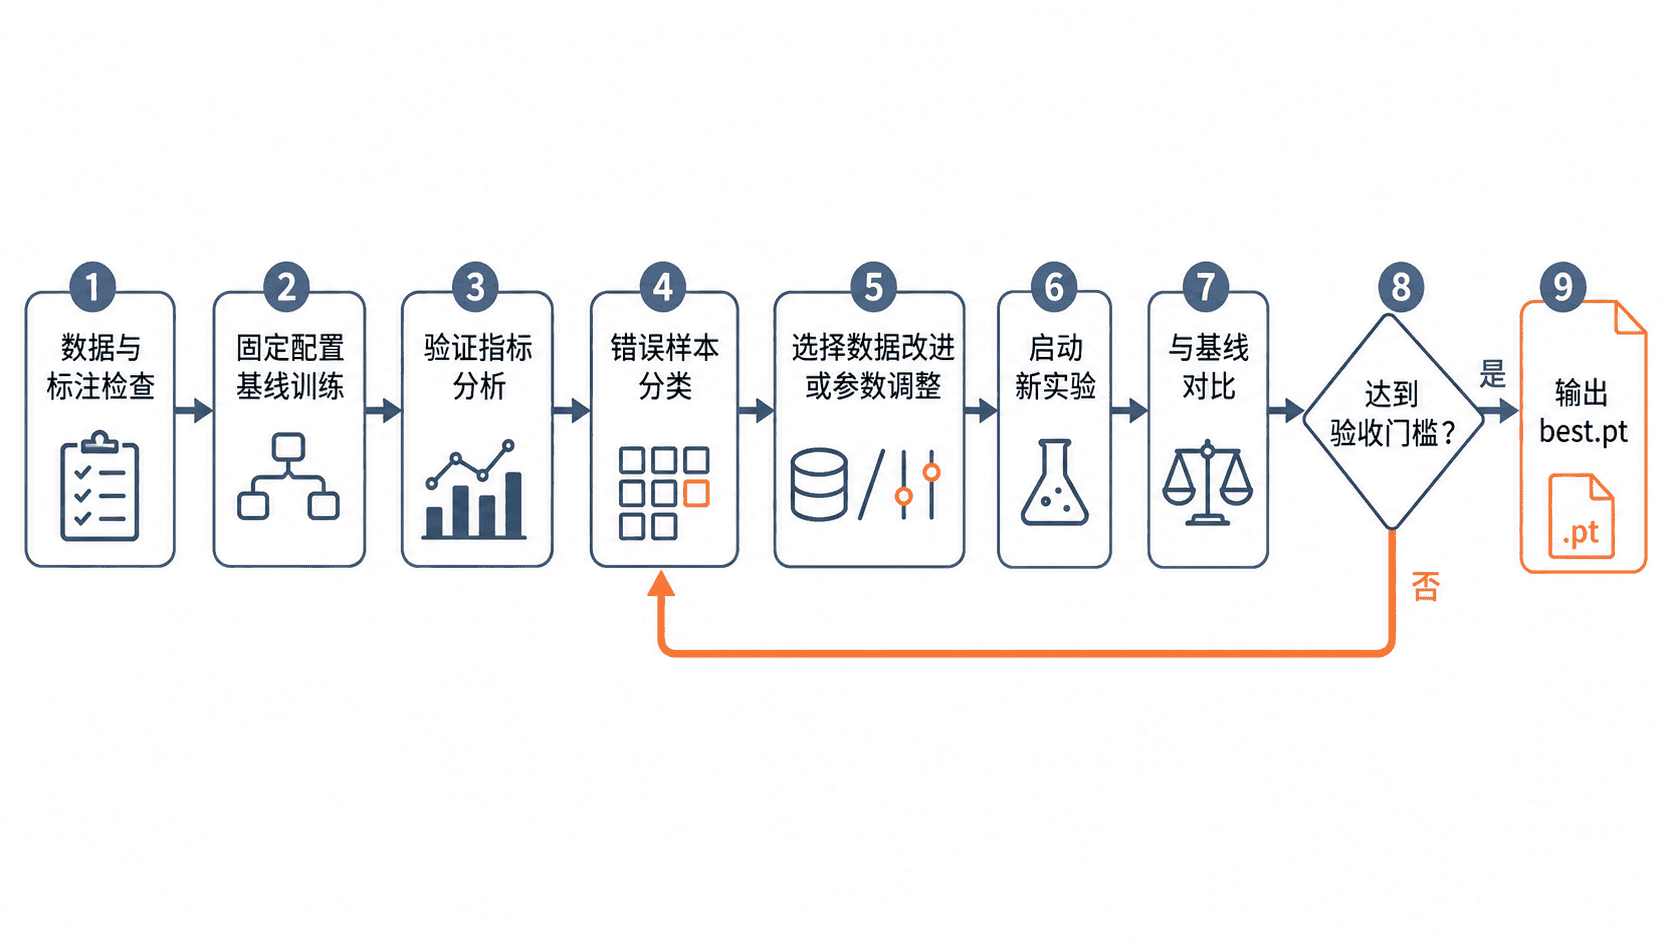
本课完成一次可复现的 YOLOv8 基线训练,并建立“看指标、查错例、改数据或参数、重新对比”的迭代闭环。最终你将得到可追溯的实验记录,以及能够进入应用交付阶段的最佳权重文件。
学习目标
- 使用固定配置完成基线训练并保存关键产物
- 根据验证指标和错误样本判断主要瓶颈
- 只改变少量变量完成可对比的模型迭代
建立可复现的基线
基线不是“先随便跑一次”,而是一组以后能够重复执行的固定条件。训练前应确认数据配置文件可用、类别编号连续、训练集与验证集互不混用,并记录模型、图像尺寸、批次、轮数、随机种子和软件版本。
下面的命令安装固定大版本的 Ultralytics,并启动一个命名明确的基线实验。batch 需要根据显存调整;显存不足时先降低批次,不要同时修改图像尺寸和模型规模。
python -m pip install "ultralytics>=8.2,<9"
yolo detect train model=yolov8n.pt data=config/dataset.yaml epochs=50 imgsz=640 batch=16 seed=42 deterministic=True project=runs/yolo-project name=baseline
预期结果:
训练正常完成,结果目录为 runs/yolo-project/baseline
关键文件包括:
runs/yolo-project/baseline/results.csv
runs/yolo-project/baseline/weights/best.pt
runs/yolo-project/baseline/weights/last.pt
实际训练日志中的耗时、显存占用和指标数值会随设备与数据集变化。后续比较统一使用 best.pt,因为它对应验证阶段表现最好的轮次,而不是最后一轮。
读懂指标而不是只看一个分数
目标检测需要同时关注 Precision、Recall、mAP50 和 mAP50-95。Precision 低通常意味着误检较多,Recall 低通常意味着漏检较多;mAP50-95 对定位精度更敏感,更适合判断边界框是否稳定。
不要只比较最终一行指标,还要查看训练曲线。若训练损失持续下降而验证指标停滞或回落,通常说明模型开始过拟合;若训练与验证指标都较低,则应优先检查标注质量、样本覆盖和类别设计,而不是盲目增加轮数。
用错误样本驱动下一轮修改
验证指标只能告诉你“效果有多好”,错误样本才能解释“为什么不好”。建议从验证集推理结果中分别收集漏检、误检、类别混淆和框偏移样本,再按共同特征归类,例如小目标、遮挡、暗光、背景相似或标注不一致。
| 现象 | 优先检查 | 合理动作 |
|---|---|---|
| 小目标漏检多 | 目标像素尺寸、远景样本数量 | 增加小目标样本,必要时提高 imgsz |
| 背景误检多 | 负样本是否缺失、类别边界是否模糊 | 补充无目标背景图和困难负样本 |
| 类别互相混淆 | 类别定义、标注一致性、外观相似度 | 合并不必要类别或补充区分性样本 |
| 框位置不稳定 | 框是否过松、截断目标标注规则 | 统一标注规范并复查异常框 |
一次迭代只解决一个主要问题。若同时更换模型、提高图像尺寸、调整增强并补充数据,即使指标提升,也无法判断真正有效的因素。
记录并比较每轮实验
每轮实验至少记录实验名称、唯一改动、核心指标、错误样本结论和权重路径。可以使用表格、CSV 或实验平台,但字段必须固定,避免只凭记忆挑选模型。
| 实验 | 唯一改动 | mAP50-95 | 主要错例 | 结论 |
|---|---|---|---|---|
| baseline | 固定基线 | <METRIC> |
小目标漏检 | 保留为对照 |
| exp-small-object | 补充小目标样本 | <METRIC> |
漏检减少 | 指标提升后进入候选 |
| exp-confusion | 清理混淆标注 | <METRIC> |
类别混淆减少 | 与候选继续比较 |
选择最佳模型时,应同时满足总体指标、关键类别指标和业务样例验收。若新模型只提高整体 mAP,却让核心类别 Recall 明显下降,不应直接替换基线。
完成迭代验收
迭代结束前,用独立测试样例再次推理,确认训练集外的数据仍然稳定。最终交付目录至少保留 best.pt、数据配置、训练命令、软件依赖和实验记录,并明确本轮模型的已知限制。
验收可以采用三条硬标准:训练过程可复现;最佳模型优于基线且关键类别没有明显退化;典型错误样本已经复测。只有三项都通过,模型才适合进入推理应用。