
计算机视觉 / 系统课时
设置批次与图像尺寸
设置批次与图像尺寸
本课解决训练参数中最常见的显存与效果取舍:用一组可执行配置理解 batch 和 imgsz 的作用,并学会根据显存占用、训练速度和小目标表现逐步调整。
学习目标
- 说明批次大小对显存、吞吐量和梯度稳定性的影响
- 判断输入尺寸变化对计算量和小目标检测的作用
- 使用一次基线训练验证配置是否适合当前设备
两个参数分别控制什么
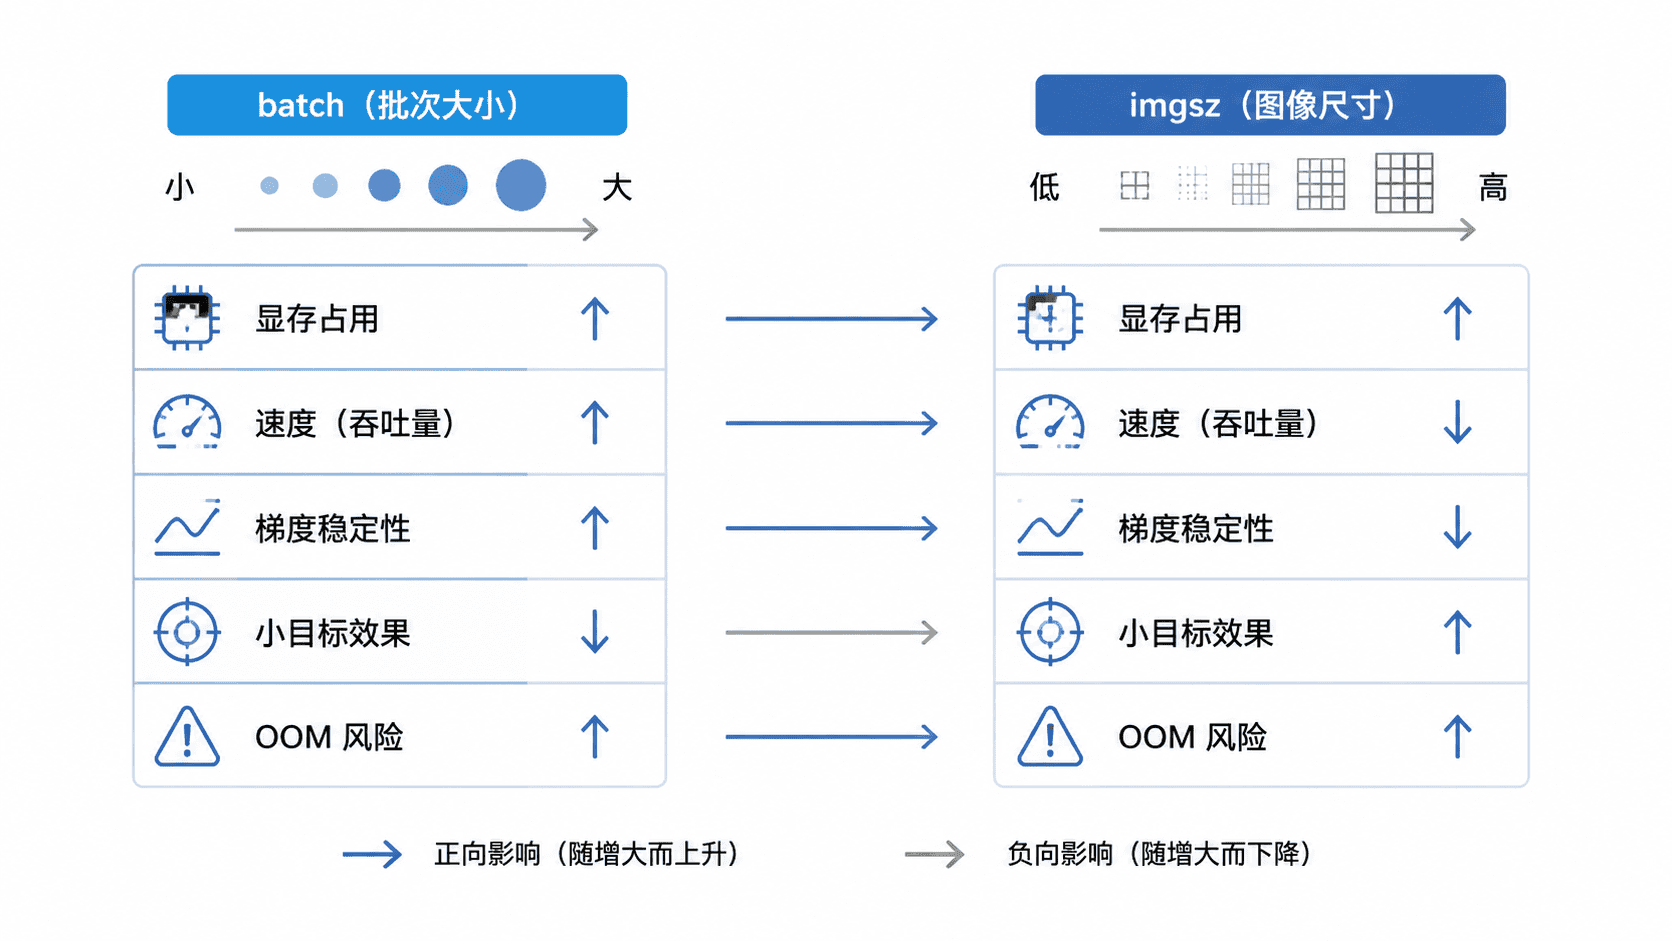
batch 表示每次参数更新前同时参与计算的图片数量。批次越大,通常显存占用越高,单次梯度更稳定,GPU 利用率也可能更好;但超过设备容量会直接触发显存不足。
imgsz 表示训练前缩放后的目标输入尺寸。尺寸越大,图像保留的细节越多,小目标可能更容易被识别,但特征图面积和计算量会明显增加。边长从 640 提高到 960 时,像素数量约变为原来的 倍。
建立第一组基线配置
首次训练不要同时追求最大批次和最高分辨率。可以从 imgsz=640、batch=16 开始;显存较小的设备先使用 batch=8,显存充足且 GPU 利用率偏低时再逐步增加。
下面的命令会使用 YOLOv8n 训练 50 个轮次,并显式设置批次和输入尺寸。执行前应准备可用的 data.yaml 数据集配置。
yolo detect train model=yolov8n.pt data=data.yaml epochs=50 imgsz=640 batch=16预期结果
训练任务成功启动,参数摘要中可看到 batch=16 和 imgsz=640。
随后开始第 1 个 epoch;具体版本号、设备名称、时间和显存数值会因环境不同而变化。
如果命令在加载首个批次时出现 CUDA out of memory,应先把 batch 减半,而不是立即降低 imgsz。只有在较小批次仍无法运行,或当前任务并不依赖细粒度目标时,再考虑降低输入尺寸。
按目标与设备逐步调整
对大目标或场景较简单的数据集,640 通常可作为稳定起点。数据中包含远距离行人、细小零件或密集目标时,可以在基线可运行后尝试 768、896 或 960,并保持其他参数不变进行对比。
调整时一次只改一个变量。先固定 imgsz 寻找可稳定运行的最大批次,再固定批次比较不同尺寸的验证集指标和单轮耗时。这样才能判断变化来自哪个参数。
| 现象 | 优先调整 | 原因 |
|---|---|---|
| 训练刚启动就显存不足 | 减小 batch |
对图像细节影响最小 |
| GPU 利用率低且显存富余 | 增大 batch |
提高并行处理能力 |
| 小目标漏检明显 | 增大 imgsz |
保留更多局部细节 |
| 单轮耗时过长 | 降低 imgsz |
计算量随面积快速增加 |
验收配置是否合理
合理配置至少满足三个条件:训练能连续运行多个轮次、显存没有频繁溢出、验证集指标与训练耗时符合项目目标。不要只看 GPU 是否“占满”,还要比较最终精度和每轮耗时。
若两个方案精度接近,应优先选择输入尺寸更小、训练更快的方案;若较大尺寸显著改善小目标召回率,再接受额外的显存和时间成本。