
计算机视觉 / 系统课时
选择预训练权重
选择预训练权重
本课解决首次训练该从哪个 YOLOv8 权重开始的问题。你将把数据规模、目标大小、显存和部署速度放到同一套决策流程中,并用统一的小规模实验比较候选模型,而不是只凭模型名称猜测。
学习目标
- 理解
yolov8n.pt到yolov8x.pt的容量与资源差异 - 根据训练设备、数据特征和部署约束筛选候选权重
- 用一致的训练参数比较精度、推理耗时和显存占用
为什么优先使用预训练权重
yolov8n.pt、yolov8s.pt、yolov8m.pt、yolov8l.pt 和 yolov8x.pt 都是检测任务权重,规模依次增大。预训练权重已经学习了通用的边缘、纹理和目标结构,通常比从随机参数开始更快形成可用结果,尤其适合标注数据有限的项目。
预训练并不等于直接可用。若业务图像与通用数据差异很大,仍需依靠自己的训练集完成适配;选择权重的目标也不是找到“最大模型”,而是在精度、速度、显存和维护成本之间取得可验证的平衡。
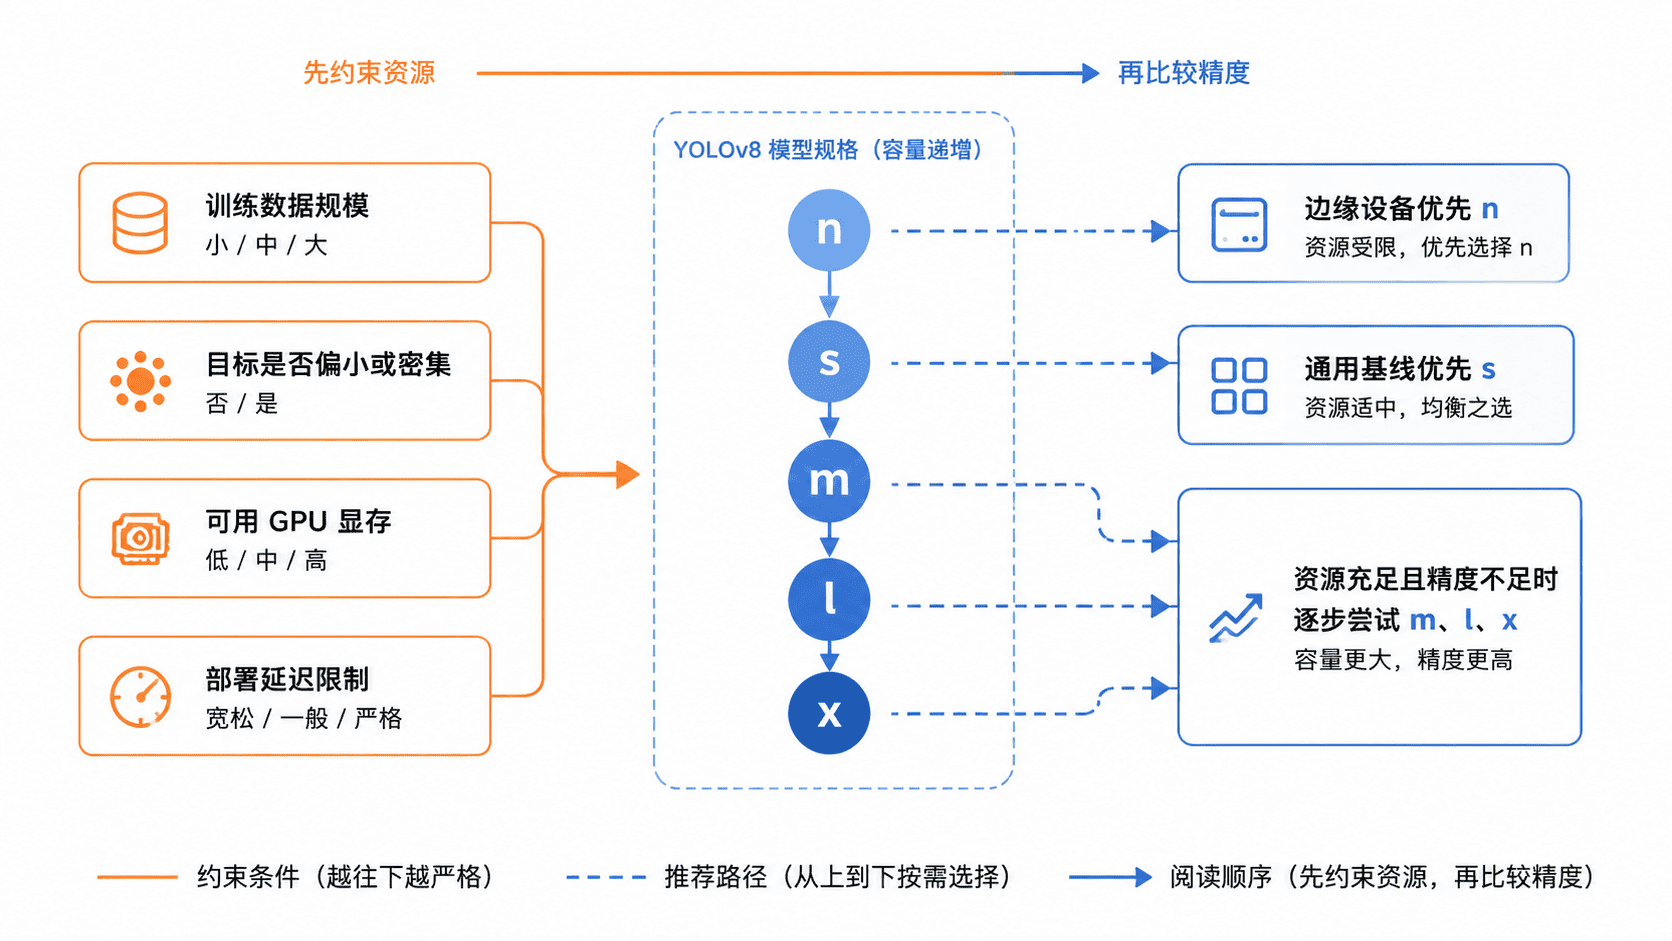
五种规格如何取舍
| 权重 | 相对速度 | 相对资源占用 | 适合作为起点的情况 |
|---|---|---|---|
yolov8n.pt |
最快 | 最低 | CPU、边缘设备、快速验证数据和流程 |
yolov8s.pt |
较快 | 较低 | 大多数中小型项目的首个正式基线 |
yolov8m.pt |
中等 | 中等 | 基线已稳定,希望继续提升复杂场景精度 |
yolov8l.pt |
较慢 | 较高 | 数据较充分、GPU 资源充足、精度优先 |
yolov8x.pt |
最慢 | 最高 | 资源约束较少,需要冲击更高上限 |
这张表只用于缩小范围,不能替代实测。数据很少时直接换大模型可能增加过拟合风险;小目标较多时,也应同时比较更高输入尺寸,因为单纯增加模型规模未必解决目标像素不足的问题。
建立选择顺序
先根据最终部署设备排除无法满足延迟或内存限制的模型,再根据训练显存筛选可运行的候选项。没有明确约束时,可先用 yolov8s.pt 建立基线;若流程尚未跑通,先用 yolov8n.pt 验证数据、代码和输出目录。
基线训练完成后再决定是否升级。若训练集和验证集表现都偏低,可尝试更大模型、提高输入尺寸或改进数据;若训练集很好而验证集明显落后,应先处理过拟合、类别不平衡和标注质量,而不是继续放大模型。
用统一实验比较候选权重
下面脚本依次对 n、s、m 三个候选权重执行相同的 3 轮短训练,再输出验证集 mAP50-95、单张图推理耗时和训练期间的峰值显存。短训练不能代表最终精度,但足以发现模型无法运行、速度不达标或差距明显等问题。
from pathlib import Path
import torch
from ultralytics import YOLO

DATA = "dataset/data.yaml"
CANDIDATES = ["yolov8n.pt", "yolov8s.pt", "yolov8m.pt"]

def peak_memory_gb() -> float:
    if not torch.cuda.is_available():
        return 0.0
    return torch.cuda.max_memory_allocated() / 1024**3

def main() -> None:
    for weight in CANDIDATES:
        if torch.cuda.is_available():
            torch.cuda.empty_cache()
            torch.cuda.reset_peak_memory_stats()

        run_name = Path(weight).stem
        model = YOLO(weight)
        model.train(
            data=DATA,
            epochs=3,
            imgsz=640,
            batch=4,
            seed=42,
            project="runs/weight_screen",
            name=run_name,
            exist_ok=True,
            verbose=False,
        )

        metrics = model.val(data=DATA, split="val", verbose=False)
        inference_ms = metrics.speed.get("inference", 0.0)
        print(
            f"{weight}: "
            f"mAP50-95={metrics.box.map:.4f}, "
            f"inference={inference_ms:.2f} ms/image, "
            f"peak_memory={peak_memory_gb():.2f} GB"
        )

if __name__ == "__main__":
    main()
安装依赖并运行脚本:
python -m pip install ultralytics torch
python compare_weights.py
预期输出格式:
yolov8n.pt: mAP50-95=<MAP_N>, inference=<MS_N> ms/image, peak_memory=<GB_N> GB
yolov8s.pt: mAP50-95=<MAP_S>, inference=<MS_S> ms/image, peak_memory=<GB_S> GB
yolov8m.pt: mAP50-95=<MAP_M>, inference=<MS_M> ms/image, peak_memory=<GB_M> GB<MAP_*>、<MS_*> 和 <GB_*> 会随数据集、GPU、软件版本和运行环境变化。没有 CUDA 时峰值显存显示为 0.00 GB,此时应重点比较 CPU 推理耗时,并减少候选数量。
根据结果作出决定
先设置不能突破的硬约束,例如单张图延迟、可用显存或设备内存。满足硬约束的模型中,再选择验证指标更好的一个;若两个模型的精度差距很小,优先选择更快、更省资源的型号。
保留每次实验的相同数据划分、随机种子、输入尺寸、批量大小和训练轮数。只有控制变量一致,结果才具有比较意义。正式训练时再增加轮数,并分别记录最佳权重、验证指标和部署设备上的真实速度。
常见选择误区
直接从 yolov8x.pt 开始,可能在显存、训练时间和部署速度上付出高成本,却未获得对应收益。只看参数规模也不可靠,因为数据质量、目标像素大小和输入尺寸同样会限制结果。
短训练排名也不能当成最终结论。它适合筛选候选项,但模型收敛速度可能不同;最终应让入选模型使用相同的完整训练方案,再以验证集指标和真实部署性能决定。