
计算机视觉 / 系统课时
构建检测接口
构建检测接口
本课使用 FastAPI 把 YOLOv8 模型封装成可调用的检测服务,完成图片上传、格式与大小校验、模型推理和结构化 JSON 返回。最终可以通过 curl 或其他系统提交图片并获得检测框、类别与置信度。
学习目标
- 设计一个清晰的图片检测 HTTP 接口与错误边界
- 使用
UploadFile接收图片并调用 YOLOv8 模型推理 - 启动服务并验证成功响应、异常状态码和并发限制
设计接口边界
本课采用 POST /v1/detect 接收 multipart/form-data,文件字段名固定为 file。服务先检查 MIME 类型和文件大小,再解码图片、执行推理,最后把检测框转换为普通 JSON 数据。FastAPI 的 UploadFile 使用可回卷的临时文件对象,适合处理图片等较大上传内容;接收表单文件还需要安装 python-multipart。:contentReference[oaicite:1]{index=1}
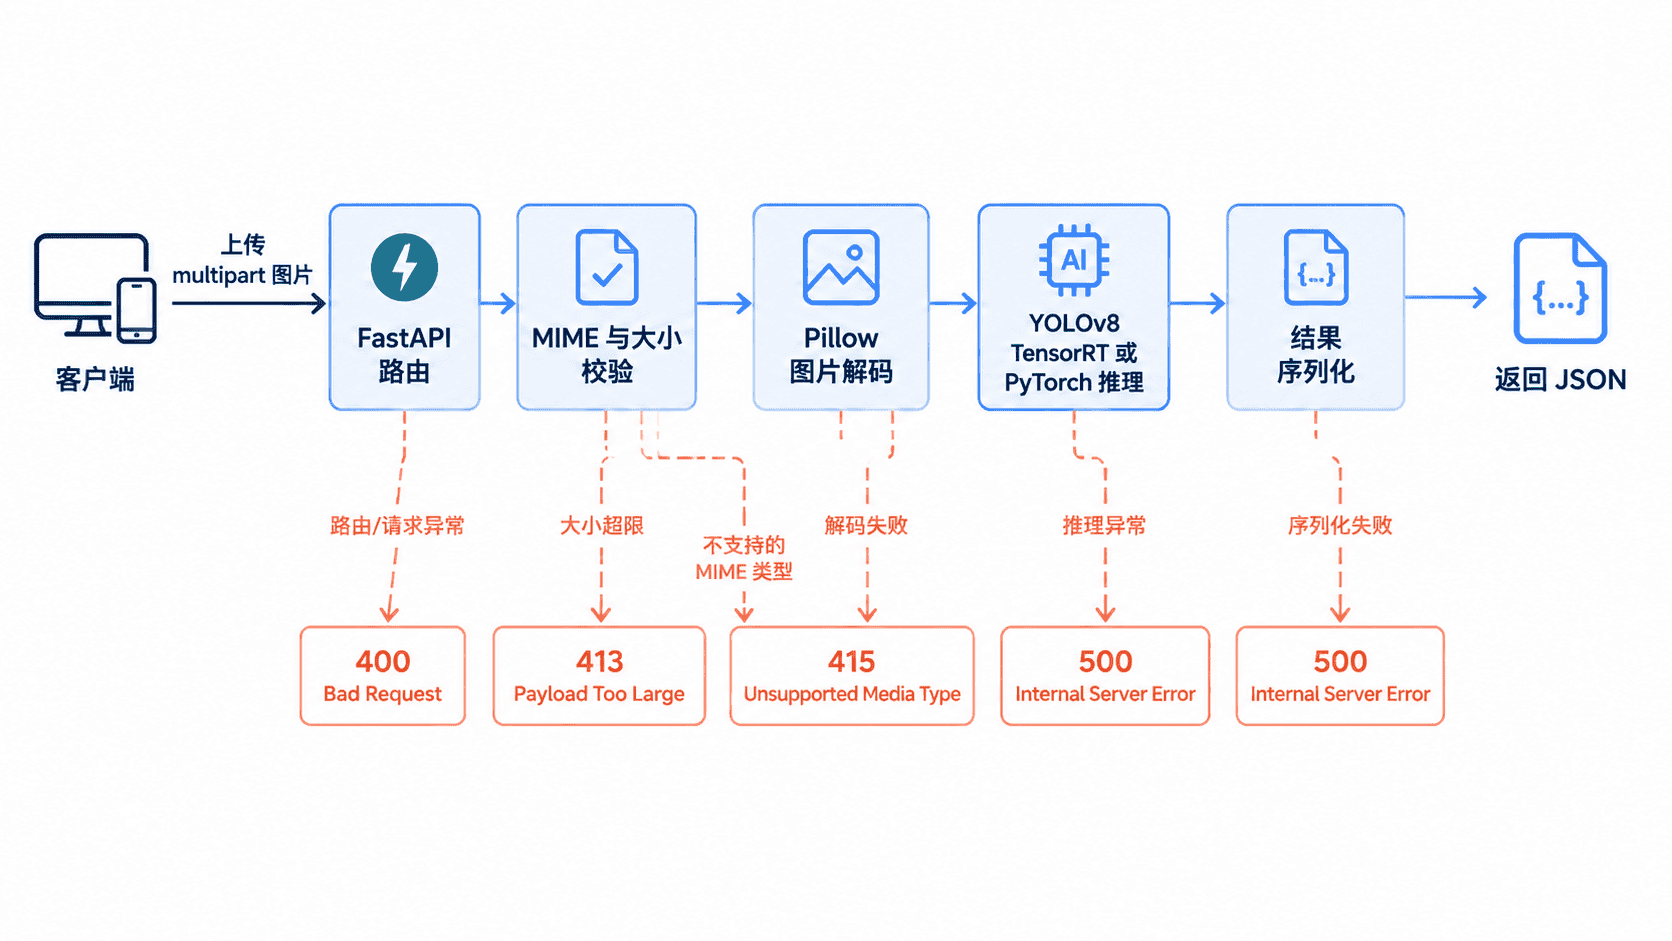
接口的最小约定如下:
| 项目 | 约定 |
|---|---|
| 请求方法 | POST /v1/detect |
| 文件字段 | file |
| 支持格式 | image/jpeg、image/png |
| 最大体积 | 10 MiB |
| 成功响应 | 图片尺寸与 detections 数组 |
| 健康检查 | GET /health |
安装依赖并准备模型
在独立虚拟环境中安装 Web 服务、文件上传、图片解码和 Ultralytics 依赖。模型可以使用 best.pt,也可以使用上一课生成的 TensorRT .engine。
python -m pip install fastapi "uvicorn[standard]" python-multipart pillow ultralytics
python - <<'PY'
import fastapi
import PIL
import ultralytics

print("dependencies: ok")
PY
预期结果是安装过程没有 ERROR,并在末尾输出:
dependencies: ok将模型放到 deploy/best-fp16.engine。若使用 PyTorch 权重,可在启动时把环境变量 MODEL_PATH 改为 runs/detect/train/weights/best.pt。
编写 FastAPI 服务
新建 app.py。下面的代码只读取最多 10 MiB 加 1 字节,避免客户端通过超大文件直接占满内存;推理部分放入线程池,并使用锁保护单个模型实例,避免多个请求同时进入同一推理对象。
from io import BytesIO
from os import getenv
from pathlib import Path
from threading import Lock
from typing import Annotated

from fastapi import FastAPI, File, HTTPException, UploadFile
from fastapi.concurrency import run_in_threadpool
from PIL import Image, UnidentifiedImageError
from ultralytics import YOLO

MODEL_PATH = getenv("MODEL_PATH", "deploy/best-fp16.engine")
MAX_FILE_BYTES = 10 * 1024 * 1024
ALLOWED_TYPES = {"image/jpeg", "image/png"}

app = FastAPI(title="YOLOv8 Detection API", version="1.0.0")
model = YOLO(MODEL_PATH, task="detect")
inference_lock = Lock()

def run_inference(image: Image.Image) -> list[dict[str, object]]:
    # 单模型实例串行执行,先保证结果稳定,再按显存容量扩展进程
    with inference_lock:
        result = model.predict(
            source=image,
            imgsz=640,
            conf=0.25,
            device=0,
            verbose=False,
        )[0]

    detections: list[dict[str, object]] = []
    for box in result.boxes:
        class_id = int(box.cls.item())
        x1, y1, x2, y2 = (round(value, 2) for value in box.xyxy[0].tolist())
        detections.append(
            {
                "classId": class_id,
                "className": result.names[class_id],
                "confidence": round(float(box.conf.item()), 4),
                "box": {"x1": x1, "y1": y1, "x2": x2, "y2": y2},
            }
        )
    return detections

@app.get("/health")
def health() -> dict[str, str]:
    return {"status": "ok", "model": Path(MODEL_PATH).name}

@app.post("/v1/detect")
async def detect(
    file: Annotated[UploadFile, File(description="JPG or PNG image")],
) -> dict[str, object]:
    if file.content_type not in ALLOWED_TYPES:
        raise HTTPException(status_code=415, detail="unsupported image type")

    content = await file.read(MAX_FILE_BYTES + 1)
    await file.close()
    if len(content) > MAX_FILE_BYTES:
        raise HTTPException(status_code=413, detail="image is too large")

    try:
        image = Image.open(BytesIO(content)).convert("RGB")
        image.load()
    except (UnidentifiedImageError, OSError) as exc:
        raise HTTPException(status_code=400, detail="invalid image file") from exc

    try:
        detections = await run_in_threadpool(run_inference, image)
    except Exception as exc:
        # 对外隐藏底层 GPU 和文件路径细节,完整异常应写入服务日志
        raise HTTPException(status_code=500, detail="inference failed") from exc

    return {
        "filename": file.filename,
        "image": {"width": image.width, "height": image.height},
        "detections": detections,
    }
预期结果是应用加载后提供 /health 与 /v1/detect 两个路由;提交合法图片时,响应中的每个检测对象都包含类别、置信度和 xyxy 坐标。
启动并调用接口
在 Linux 或 macOS 终端设置模型路径并启动服务。TensorRT 引擎要求机器具备匹配的 NVIDIA GPU 环境;使用 .pt 权重时也应根据实际设备调整代码中的 device。
export MODEL_PATH=deploy/best-fp16.engine
uvicorn app:app --host 0.0.0.0 --port 8000
预期输出包含:
INFO: Application startup complete.
INFO: Uvicorn running on http://0.0.0.0:8000另开一个终端上传测试图片。curl -F 会自动生成正确的 multipart/form-data 边界,不要手工固定 Content-Type。
curl -s -X POST "http://127.0.0.1:8000/v1/detect" -H "accept: application/json" -F "file=@test.jpg"预期响应格式如下;图片中没有达到阈值的目标时,detections 会是空数组:
{
  "filename": "test.jpg",
  "image": {
    "width": <WIDTH>,
    "height": <HEIGHT>
  },
  "detections": [
    {
      "classId": <CLASS_ID>,
      "className": "<CLASS_NAME>",
      "confidence": <CONFIDENCE>,
      "box": {
        "x1": <X1>,
        "y1": <Y1>,
        "x2": <X2>,
        "y2": <Y2>
      }
    }
  ]
}
再检查健康状态:
curl -s "http://127.0.0.1:8000/health"预期输出:
{"status":"ok","model":"best-fp16.engine"}校验错误与并发边界
| 状态码 | 触发条件 | 客户端处理 |
|---|---|---|
| 400 | 文件扩展名像图片,但实际内容无法解码 | 提示重新选择有效图片 |
| 413 | 上传内容超过 10 MiB | 压缩图片或在网关与应用统一调整限制 |
| 415 | MIME 类型不是 JPEG 或 PNG | 转换格式后重试 |
| 500 | 模型加载、GPU 或推理过程异常 | 记录请求标识并查看服务日志 |
当前锁会让同一进程内的推理串行执行,适合先建立稳定基线。直接增加 Uvicorn worker 会让每个进程各自加载一份模型,可能迅速占满显存;需要扩容时,应先测量单实例显存、延迟和队列长度,再决定多进程、副本数量或批处理策略。
上线前还应在网关层配置请求体上限、超时、认证和访问日志。接口不要返回服务器文件路径、CUDA 异常堆栈或模型内部信息,详细错误只保留在受控日志中。