
计算机视觉 / 系统课时
优化推理性能
优化推理性能
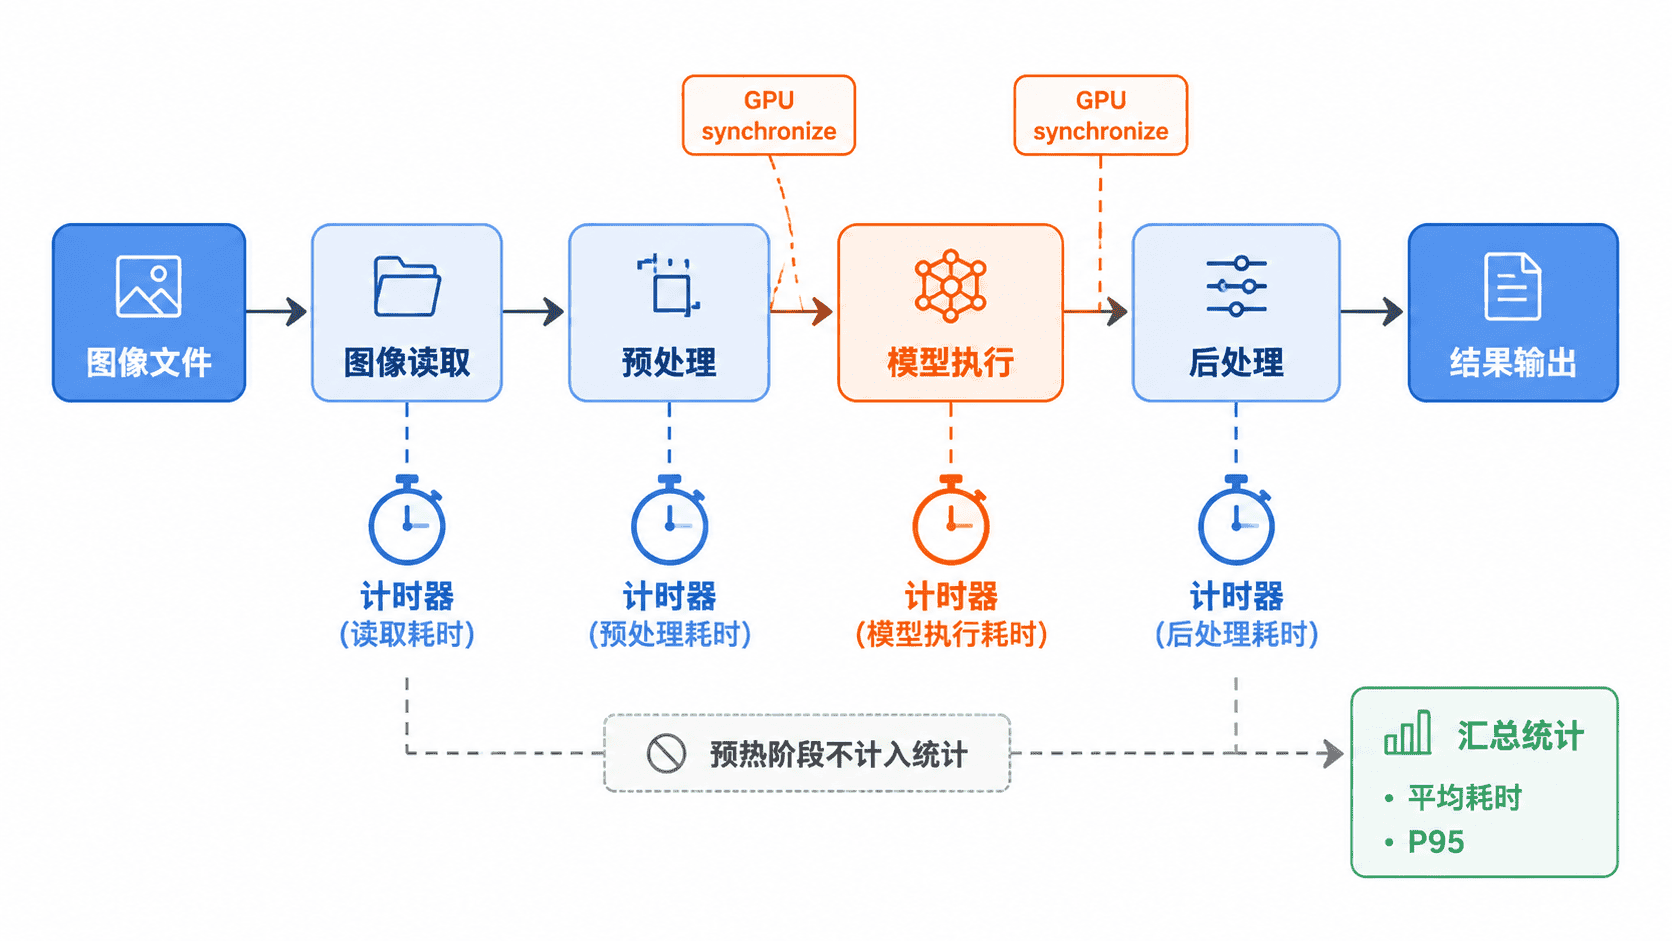
本课不直接修改模型,而是先把一次推理拆成图像读取、预处理、模型执行和后处理四个阶段,分别统计平均耗时与高分位耗时。完成测量后,你可以判断瓶颈究竟来自磁盘、CPU、GPU,还是后处理逻辑,再选择有针对性的优化手段。
学习目标
- 建立可重复的 YOLOv8 推理基准测试
- 分别测量读取、预处理、推理和后处理耗时
- 根据瓶颈阶段选择正确的优化方向
先定义测量边界
一次请求的总耗时不等于模型执行耗时。图像读取受磁盘和缓存影响,预处理通常包含缩放、填充与张量转换,模型执行主要消耗 GPU 或 CPU,后处理则包括阈值过滤、NMS 和结果封装。
GPU 运算是异步的。如果只在 model.predict() 前后读取系统时钟,程序可能在 GPU 尚未完成时就结束计时。因此基准脚本需要在测量边界调用 torch.cuda.synchronize(),并在正式统计前进行预热。
编写分阶段基准脚本
下面的脚本使用 OpenCV 单独测量文件读取时间,再读取 Ultralytics 返回的 result.speed,获得预处理、推理和后处理耗时。wall_ms 表示从调用模型到结果返回的墙钟时间,可用于发现框架调度、数据复制或日志等额外开销。
from __future__ import annotations

import argparse
import statistics
import time
from pathlib import Path

import cv2
import torch
from ultralytics import YOLO

def sync_cuda(device: str) -> None:
    normalized = device.lower()
    uses_cuda = normalized.startswith("cuda") or normalized.isdigit()
    if uses_cuda and torch.cuda.is_available():
        torch.cuda.synchronize()

def percentile(values: list[float], ratio: float) -> float:
    ordered = sorted(values)
    index = min(len(ordered) - 1, round((len(ordered) - 1) * ratio))
    return ordered[index]

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--model", required=True)
    parser.add_argument("--image", required=True)
    parser.add_argument("--device", default="cpu")
    parser.add_argument("--rounds", type=int, default=30)
    parser.add_argument("--warmup", type=int, default=5)
    parser.add_argument("--imgsz", type=int, default=640)
    args = parser.parse_args()

    image_path = Path(args.image)
    if not image_path.is_file():
        raise FileNotFoundError(f"image not found: {image_path}")

    # 首次加载模型和样例图像,用于预热与输入有效性检查。
    model = YOLO(args.model)
    sample = cv2.imread(str(image_path))
    if sample is None:
        raise ValueError(f"cannot decode image: {image_path}")

    # 预热会触发模型初始化、显存分配和算子选择,不计入正式结果。
    for _ in range(args.warmup):
        model.predict(sample, device=args.device, imgsz=args.imgsz, verbose=False)
    sync_cuda(args.device)

    metrics = {
        "read_ms": [],
        "preprocess_ms": [],
        "inference_ms": [],
        "postprocess_ms": [],
        "wall_ms": [],
    }

    # 正式循环分别记录磁盘读取和模型内部三个阶段。
    for _ in range(args.rounds):
        read_start = time.perf_counter()
        image = cv2.imread(str(image_path))
        if image is None:
            raise ValueError(f"cannot decode image: {image_path}")
        metrics["read_ms"].append((time.perf_counter() - read_start) * 1000)

        sync_cuda(args.device)
        wall_start = time.perf_counter()
        result = model.predict(
            image,
            device=args.device,
            imgsz=args.imgsz,
            verbose=False,
        )[0]
        sync_cuda(args.device)
        metrics["wall_ms"].append((time.perf_counter() - wall_start) * 1000)

        # Ultralytics 已按单张图像记录内部三个阶段的毫秒耗时。
        metrics["preprocess_ms"].append(float(result.speed["preprocess"]))
        metrics["inference_ms"].append(float(result.speed["inference"]))
        metrics["postprocess_ms"].append(float(result.speed["postprocess"]))

    # 使用平均值识别主瓶颈,同时保留 P95 观察尾延迟。
    averages = {name: statistics.mean(values) for name, values in metrics.items()}
    stage_names = ["read_ms", "preprocess_ms", "inference_ms", "postprocess_ms"]
    bottleneck = max(stage_names, key=averages.get)

    for name, values in metrics.items():
        print(
            f"{name}: avg={statistics.mean(values):.2f} ms, "
            f"p95={percentile(values, 0.95):.2f} ms"
        )
    print(f"bottleneck: {bottleneck}")

if __name__ == "__main__":
    main()
预期结果
脚本完成预热和指定轮数测试后,输出各阶段的平均耗时、P95 耗时与最慢阶段。脚本要求同一轮测试使用固定模型、图像尺寸、设备和轮数。若要比较两种优化方案,应只改变一个变量,否则无法判断性能变化来自哪里。
运行并读取结果
先安装依赖并执行基准测试。GPU 环境把 --device cpu 改为 --device 0。
python benchmark.py \
  --model models/best.pt \
  --image samples/test.jpg \
  --device cpu \
  --rounds 30 \
  --warmup 5 \
  --imgsz 640
预期输出
read_ms: avg=<TIME_MS> ms, p95=<TIME_MS> ms
preprocess_ms: avg=<TIME_MS> ms, p95=<TIME_MS> ms
inference_ms: avg=<TIME_MS> ms, p95=<TIME_MS> ms
postprocess_ms: avg=<TIME_MS> ms, p95=<TIME_MS> ms
wall_ms: avg=<TIME_MS> ms, p95=<TIME_MS> ms
bottleneck: <STAGE>
实际数值会随硬件、权重、图像尺寸和缓存状态变化。平均值反映常态性能,P95 更接近线上慢请求体验;如果 P95 明显高于平均值,应继续排查磁盘抖动、CPU 争用、GPU 排队或内存回收。
按瓶颈选择优化动作
读取阶段最慢时,优先使用本地 SSD、批量预取、内存缓存或异步解码;不要先更换模型。预处理最慢时,可减少重复颜色转换与缩放,固定输入尺寸,并评估批处理是否能摊薄 CPU 开销。
模型执行最慢时,再考虑减小 imgsz、选择更小权重、启用 FP16、批量推理,或导出 ONNX、TensorRT。后处理最慢通常意味着候选框过多,可合理提高置信度阈值、限制类别或检查 NMS 参数,但要同时验证召回率是否下降。
wall_ms 明显大于内部三个阶段之和时,额外时间可能来自 Python 调度、CPU 与 GPU 数据复制、首次初始化或服务层序列化。此时应结合端到端请求耗时继续测量,而不是只看模型日志中的 inference 数字。
保证测试结论可信
正式对比前应固定电源模式、线程数和后台负载,并至少运行多轮。测试同一文件会受到操作系统页缓存影响,因此读取性能应分别记录冷缓存和热缓存结果;线上图片来自网络时,还要把下载时间单独列出。
优化后必须同时验证精度、吞吐量和延迟。较大的 batch 可能提高每秒处理图片数,却增加单个请求等待时间;FP16 或更小输入尺寸也可能改变检测结果。性能提升只有在业务精度和稳定性仍满足要求时才成立。