
计算机视觉 / 系统课时
配置学习率
配置学习率
本课将把学习率从“照抄默认值”变成可验证的训练配置:理解初始学习率、末期衰减和预热的协作方式,并通过损失变化识别过大、过小或预热不足。
学习目标
- 解释
lr0、lrf、学习率调度与预热的职责 - 使用命令显式配置一组可复现的学习率参数
- 根据训练曲线和验证指标判断调整方向
学习率如何影响训练
学习率决定每次参数更新的步幅。步幅过大时,优化过程可能越过较优区域,表现为损失剧烈波动、验证指标忽高忽低,严重时出现 NaN;步幅过小时,损失下降缓慢,训练多个轮次仍没有明显进展。
YOLOv8 训练中,lr0 是初始学习率,lrf 是最终学习率相对于 lr0 的比例。例如 lr0=0.01、lrf=0.01 时,训练末期目标学习率约为 0.0001。warmup_epochs 用于在训练开始阶段逐步升高学习率,避免随机初始化或新检测头在早期受到过大更新冲击。
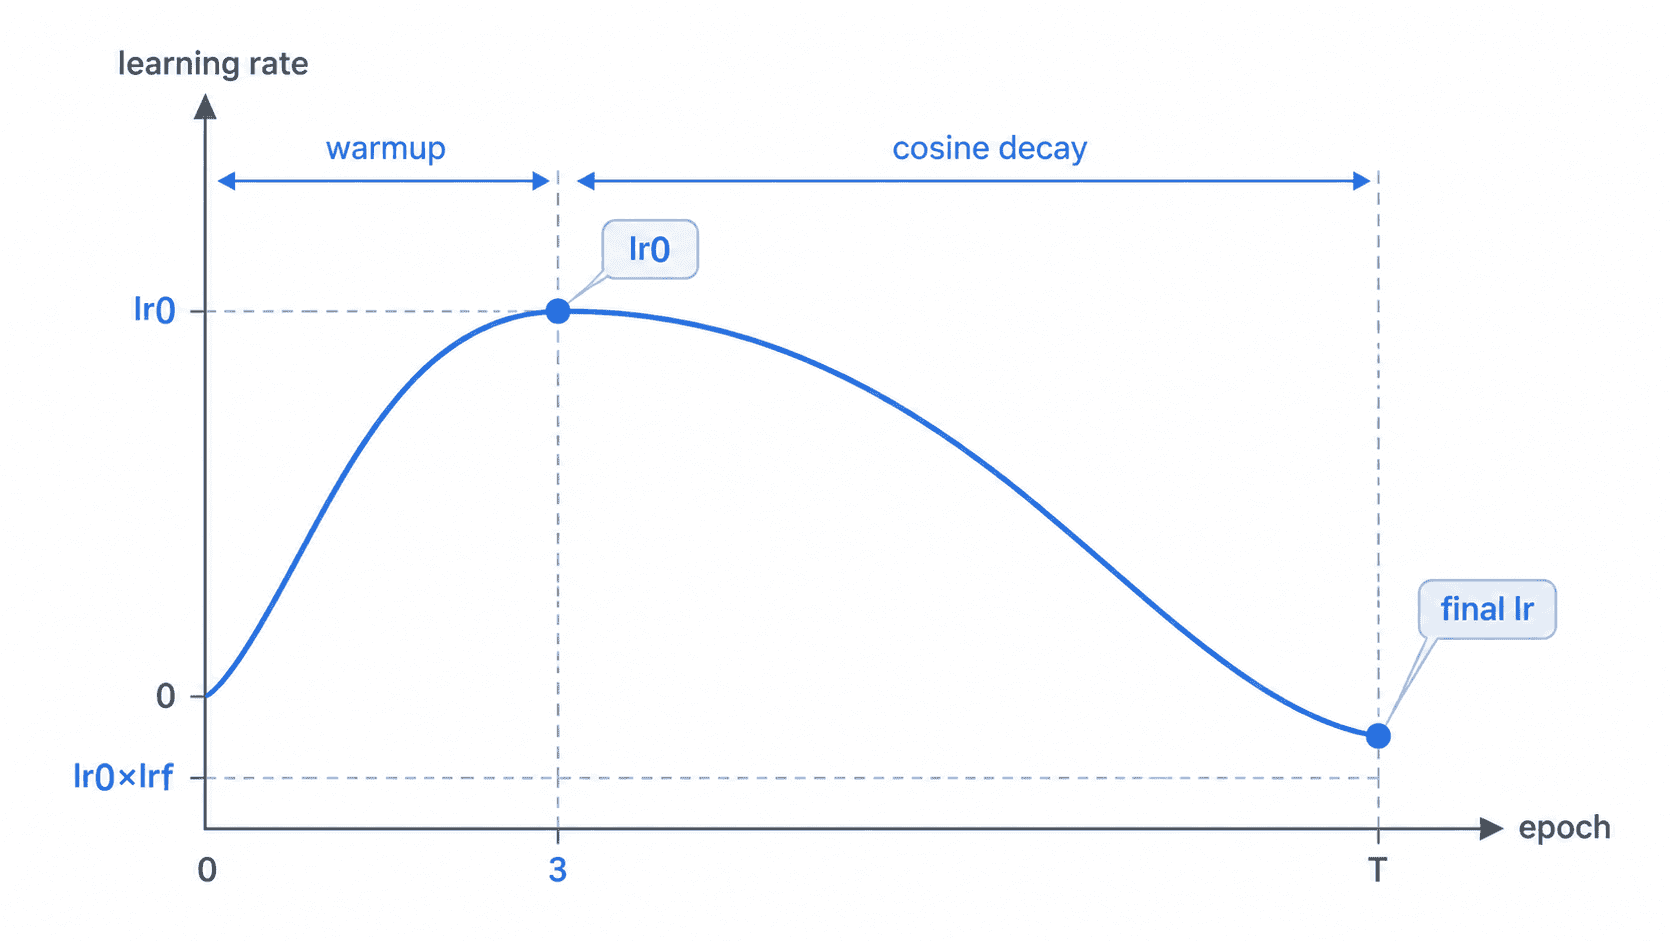
配置一组可复现参数
当需要研究学习率时,应显式指定优化器,避免自动优化器根据模型和数据规模改写学习率。下面使用 SGD、余弦衰减和 3 个预热轮次建立基线。
yolo detect train model=yolov8n.pt data=data.yaml epochs=100 imgsz=640 batch=16 optimizer=SGD lr0=0.01 lrf=0.01 cos_lr=True warmup_epochs=3.0预期结果
训练任务成功启动,参数摘要中可看到 optimizer=SGD、lr0=0.01、lrf=0.01、cos_lr=True 和 warmup_epochs=3.0。
训练从预热阶段进入正式调度;具体日志格式、时间和指标数值会因版本与数据集不同而变化。
这组参数不是所有项目的固定答案,而是便于比较的起点。若改用 AdamW,通常需要从更小的初始学习率开始测试,例如 0.001,并重新观察损失是否稳定。
识别学习率过大或过小
学习率过大时,训练损失常在相邻轮次间明显震荡,验证集 mAP 可能先升后降,甚至出现梯度或损失为非数值。此时先把 lr0 降低到原来的二分之一或十分之一,再保持其他参数不变重跑短实验。
学习率过小时,损失曲线通常较平滑,但下降速度很慢,前若干轮的验证指标几乎不变。此时可以小幅提高 lr0,例如从 0.001 调到 0.002,而不是一次放大十倍。
预热不足通常集中表现为训练最初几个轮次不稳定,随后又恢复正常。可把 warmup_epochs 从 3 增加到 5;若整个训练过程都波动,则问题更可能是 lr0 过大,而不是单纯预热不足。
采用短实验完成调参
正式训练前先运行 10~20 个轮次的短实验。每次只修改一个参数,并记录初始损失下降速度、是否出现异常波动、验证集指标和最佳轮次。
建议按以下顺序处理:先固定优化器,再调 lr0;确认前期稳定后,再决定是否使用余弦衰减和调整 lrf;最后仅在早期震荡明显时延长预热。这样可以避免多个参数同时变化导致结论失真。
验收学习率配置
一组可接受的配置应满足:预热阶段没有异常尖峰,训练损失总体下降,验证指标在合理轮次内开始改善,并且后期没有持续震荡。最终应使用相同数据划分和随机种子比较候选方案。
不要只选择训练损失最低的方案。检测任务还应同时检查验证集的精确率、召回率和 mAP,确认学习率没有让模型过快记住训练集而损害泛化能力。