
计算机视觉 / 系统课时
阅读训练日志
阅读训练日志
训练完成不等于模型可用。本课将把控制台日志和 results.csv 中的损失、精确率、召回率与 mAP 串成一套判断顺序,帮助你识别正常收敛、过拟合和指标失衡,并找到应当保留的训练轮次。
学习目标
- 识别定位损失、分类损失和 DFL 损失的职责
- 解释精确率、召回率、mAP50 与 mAP50-95 的差异
- 从
results.csv提取关键指标并判断训练趋势
先读懂一轮日志
YOLOv8 每轮训练通常先输出训练阶段的损失,再输出验证集上的检测指标。阅读时不要只盯一个数字,而要先确认当前 epoch、损失是否正常,再看验证指标是否持续改善。
下面是一段结构化的日志示例,尖括号中的值会随设备、数据集和训练轮次变化。
Epoch    GPU_mem   box_loss   cls_loss   dfl_loss   Instances   Size
<EPOCH>  <GPU_MEM> <VALUE>    <VALUE>    <VALUE>    <INSTANCES> 640
Class    Images    Instances  Box(P      R          mAP50       mAP50-95)
all <IMAGES> <INSTANCES> <VALUE> <VALUE> <VALUE> <VALUE>| 字段 | 主要含义 | 阅读方向 |
|---|---|---|
box_loss |
预测框与真实框的位置偏差 | 同一次实验中整体下降通常表示定位在改善 |
cls_loss |
类别预测误差 | 下降表示类别区分能力在改善 |
dfl_loss |
边界框分布回归误差 | 与 box_loss 结合观察,不单独下结论 |
P |
精确率,预测为目标的结果中有多少是正确的 | 低时通常意味着误检较多 |
R |
召回率,真实目标中有多少被检测出来 | 低时通常意味着漏检较多 |
mAP50 |
在 IoU=0.50 条件下汇总各类别 AP | 相对宽松,适合观察检测能力是否建立 |
mAP50-95 |
在 IoU 0.50~0.95 多个阈值上取平均 | 更严格,更能反映定位质量 |
Ultralytics 的检测验证结果以 Precision、Recall、mAP50 和 mAP50-95 共同描述模型表现,其中 mAP50-95 对边界框贴合程度要求更高。:contentReference[oaicite:0]{index=0}
从 results.csv 复核最后一轮
控制台适合实时观察,results.csv 更适合复盘和对比实验。将下面脚本保存为 read_last_epoch.py,它会读取最后一行,并按固定字段输出核心结果。
from __future__ import annotations

import argparse
import csv
from pathlib import Path

METRICS = (
    "epoch",
    "train/box_loss",
    "train/cls_loss",
    "train/dfl_loss",
    "metrics/precision(B)",
    "metrics/recall(B)",
    "metrics/mAP50(B)",
    "metrics/mAP50-95(B)",
    "val/box_loss",
    "val/cls_loss",
    "val/dfl_loss",
)

def main() -> None:
    parser = argparse.ArgumentParser(description="读取 YOLOv8 最后一轮训练指标")
    parser.add_argument("csv_path", type=Path)
    args = parser.parse_args()

    if not args.csv_path.is_file():
        raise SystemExit(f"文件不存在: {args.csv_path}")

    # utf-8-sig 可兼容带 BOM 的 CSV 文件
    with args.csv_path.open("r", encoding="utf-8-sig", newline="") as file:
        rows = list(csv.DictReader(file))

    if not rows:
        raise SystemExit("results.csv 没有数据行")

    # 部分版本的列名前后可能包含空格,统一清理后再读取
    latest = {key.strip(): value.strip() for key, value in rows[-1].items()}
    for name in METRICS:
        print(f"{name}: {latest.get(name, '<NOT_FOUND>')}")

if __name__ == "__main__":
    main()
运行命令:
python read_last_epoch.py "<PATH>/results.csv"预期输出:
epoch: <EPOCH>
train/box_loss: <VALUE>
train/cls_loss: <VALUE>
train/dfl_loss: <VALUE>
metrics/precision(B): <VALUE>
metrics/recall(B): <VALUE>
metrics/mAP50(B): <VALUE>
metrics/mAP50-95(B): <VALUE>
val/box_loss: <VALUE>
val/cls_loss: <VALUE>
val/dfl_loss: <VALUE><PATH>、<EPOCH> 和各项 <VALUE> 以实际实验为准。若某项显示 <NOT_FOUND>,先打开 CSV 表头确认当前 Ultralytics 版本使用的列名,再调整 METRICS。
用组合指标做判断
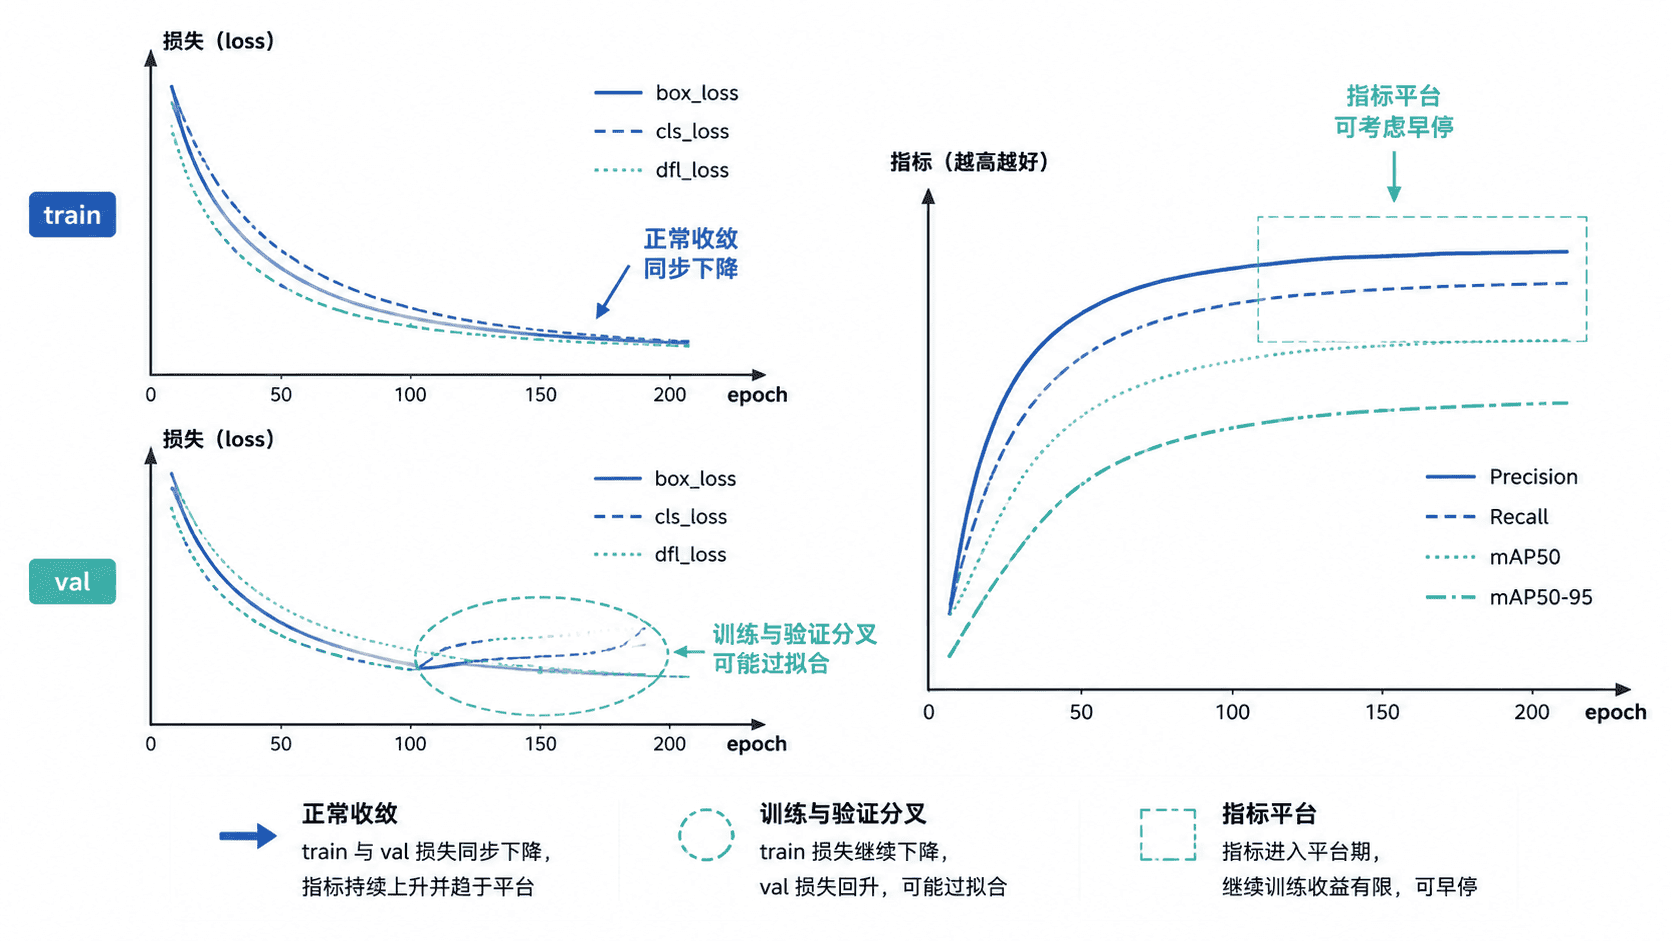
健康训练通常表现为训练损失和验证损失总体下降,mAP50-95 持续上升后逐渐进入平台。单个 epoch 的短暂波动并不等于训练失败,应优先观察连续多轮趋势。
训练损失继续下降而验证损失回升,同时 mAP 停滞或下降,往往说明模型开始过拟合。此时应检查数据量、增强强度、训练轮数与早停设置,而不是仅追求更低的训练损失。
精确率高但召回率低,说明模型较保守,误检少但漏检多;召回率高但精确率低,则说明检出更多目标的同时引入了更多误检。最终选择权重时,应结合业务更怕误检还是更怕漏检,并以 mAP50-95 和逐类别结果复核,而不是只看一个总指标。:contentReference[oaicite:1]{index=1}