
计算机视觉 / 系统课时
使用 Python API 训练
使用 Python API 训练
本课将把 YOLOv8 训练流程封装进一个可直接运行的 Python 脚本。相比临时拼接命令,Python API 更适合集中管理参数、增加前置检查、记录实验目录,并在后续接入配置文件、循环实验或自动验证。
学习目标
- 使用
YOLO类加载 YOLOv8 预训练权重 - 用字典集中组织训练参数并调用
model.train() - 运行脚本并检查最佳权重是否成功生成
准备数据与项目目录
Python API 仍然依赖 YOLO 格式数据集和 data.yaml。推荐把训练入口放在项目根目录,数据和输出目录分别管理,避免在代码中散落难以迁移的绝对路径。
yolov8-project/
├── train.py
├── datasets/
│   └── helmet/
│       ├── data.yaml
│       ├── images/
│       └── labels/
└── runs/这是目录结构示例,不会产生控制台输出。data.yaml 至少应声明训练集、验证集与类别名称;运行脚本前,确认 datasets/helmet/data.yaml 已存在且内部路径可解析。
编写训练入口
Ultralytics Python API 通过 YOLO("yolov8n.pt") 加载模型,再由 model.train(...) 启动训练。官方文档同时支持直接传参和保存返回结果,适合把训练过程纳入 Python 工程。:contentReference[oaicite:3]{index=3}
把下面代码保存为项目根目录下的 train.py。示例使用相对路径定位数据集,先做文件存在性检查,再通过 TRAIN_CONFIG 集中维护训练参数。
from pathlib import Path

from ultralytics import YOLO

TRAIN_CONFIG = {
    "epochs": 50,
    "imgsz": 640,
    "batch": 8,
    "project": "runs/detect",
    "name": "python-first-train",
    "seed": 42,
}

def main() -> None:
    project_root = Path(__file__).resolve().parent
    data_yaml = project_root / "datasets" / "helmet" / "data.yaml"

    # 在启动耗时训练前暴露路径错误,避免运行到数据加载阶段才失败。
    if not data_yaml.is_file():
        raise FileNotFoundError(f"找不到数据集配置文件: {data_yaml}")

    # 从预训练权重微调,比从空白结构开始更适合第一次自定义训练。
    model = YOLO("yolov8n.pt")
    model.train(data=str(data_yaml), **TRAIN_CONFIG)

    save_dir = Path(model.trainer.save_dir)
    best_weight = save_dir / "weights" / "best.pt"

    # 用产物检查完成最小验收,后续可在这里继续调用验证或推理。
    print(f"save_dir={save_dir}")
    print(f"best_weight_exists={best_weight.is_file()}")

if __name__ == "__main__":
    main()
预期结果
save_dir=<PATH>/runs/detect/<RUN_NAME>
best_weight_exists=True训练过程中还会输出设备、轮次、损失和验证指标;这些动态内容随环境与数据而变化。TRAIN_CONFIG 只放通用训练参数,数据集路径由入口函数计算。这样既能保持参数集中,又能在复制项目或切换运行目录时减少路径错误。seed=42 有助于提高实验可复现性,但 GPU 算法、并行加载和依赖版本仍可能造成细微差异。
运行并检查输出
在项目根目录激活已经安装 ultralytics 的 Python 环境,然后执行脚本。
python train.py预期输出
Starting training for 50 epochs...
50 epochs completed in <TIME>.
Results saved to <PATH>/runs/detect/<RUN_NAME>
save_dir=<PATH>/runs/detect/<RUN_NAME>
best_weight_exists=True
<RUN_NAME> 通常是 python-first-train;如果同名目录已经存在且未允许覆盖,Ultralytics 可能追加数字。训练日志中的版本、设备、批次耗时和指标会随环境与数据变化,最终应以 best_weight_exists=True 和实际权重文件存在为准。
理解 API 调用链
脚本中的对象关系是:路径检查负责阻止错误输入,YOLO 对象负责加载模型,model.train() 创建并执行训练器,训练器再把指标与权重写入实验目录。后续工程化通常就在这些节点增加配置读取、日志记录或实验循环。
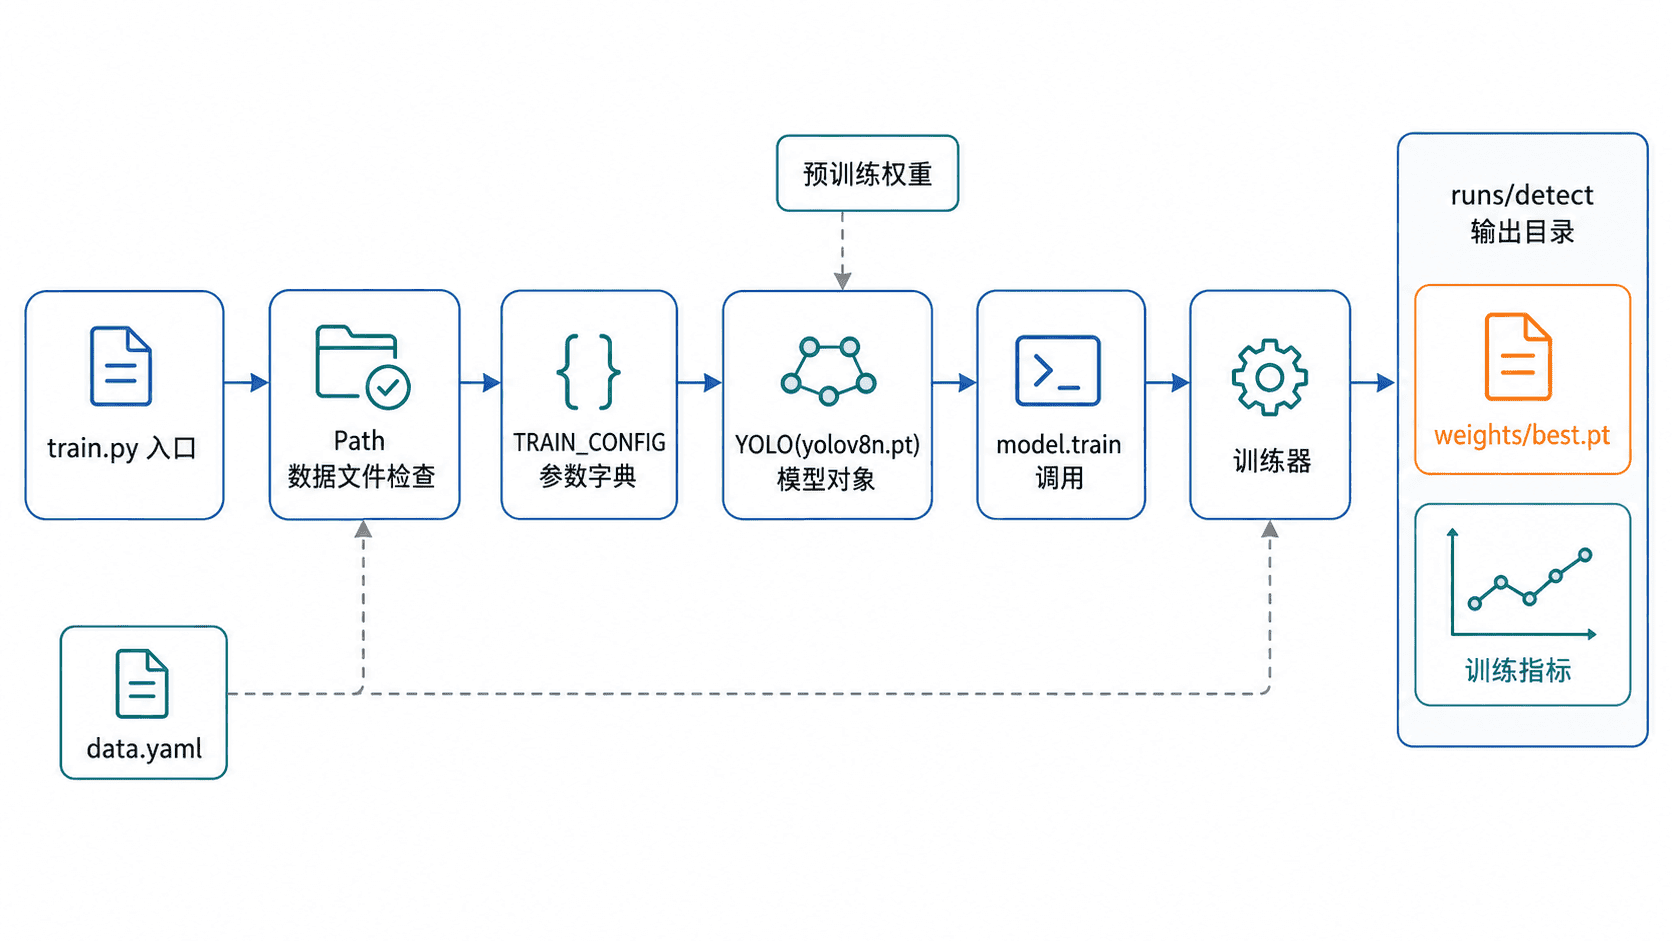
这种组织方式比把所有参数直接写进 model.train() 更适合持续实验。需要比较模型规模时,只修改模型文件;需要比较轮次、图像尺寸或批量时,只修改配置字典;需要切换数据集时,只调整 data_yaml。
参数管理边界
不要把每个 Ultralytics 参数都提前写入配置。首次工程化只保留会主动调整的参数,其他项使用库默认值,避免配置过长却无法解释其作用。新增参数时,应同时记录修改原因,例如显存不足才降低 batch,小目标识别不足才评估提高 imgsz。
Windows 环境必须保留 if __name__ == "__main__": 入口保护,尤其是后续启用多进程数据加载时。出现 CUDA 显存不足时,优先降低 TRAIN_CONFIG["batch"];没有可用 GPU 时可加入 "device": "cpu",但应预期训练时间明显增加。
后续扩展方式
当单次脚本稳定运行后,可以把 TRAIN_CONFIG 移到 YAML 或 JSON 配置文件,再由 Python 读取;也可以循环修改 name、模型权重和关键超参数,形成多组实验。每次实验都应使用独立输出目录,并保留数据版本、参数和最佳权重之间的对应关系。
若要在训练后自动验证,可在确认 best.pt 存在后重新加载该权重并调用验证接口。不要在第一版脚本中同时加入数据下载、训练、验证、导出和部署,先保持单一职责,出现问题时更容易定位。