
计算机视觉 / 系统课时
实例分割任务
实例分割任务
本课将完成一个最小可用的 YOLOv8 实例分割流程:先认识每个目标独立掩膜的输出形式,再准备多边形标注与数据集配置,最后训练分割模型并对新图片执行推理。
学习目标
- 区分目标检测、实例分割和语义分割的输出
- 按 YOLO 格式组织多边形标注数据
- 完成 YOLOv8 分割模型的训练、推理与结果检查
实例分割比检测多输出什么
目标检测只给出目标所在的矩形区域;实例分割还会为每个目标生成独立掩膜或轮廓。同一类别出现两个对象时,应得到两个实例、两个边界框和两份掩膜,而不是把同类像素合并成一张类别图。
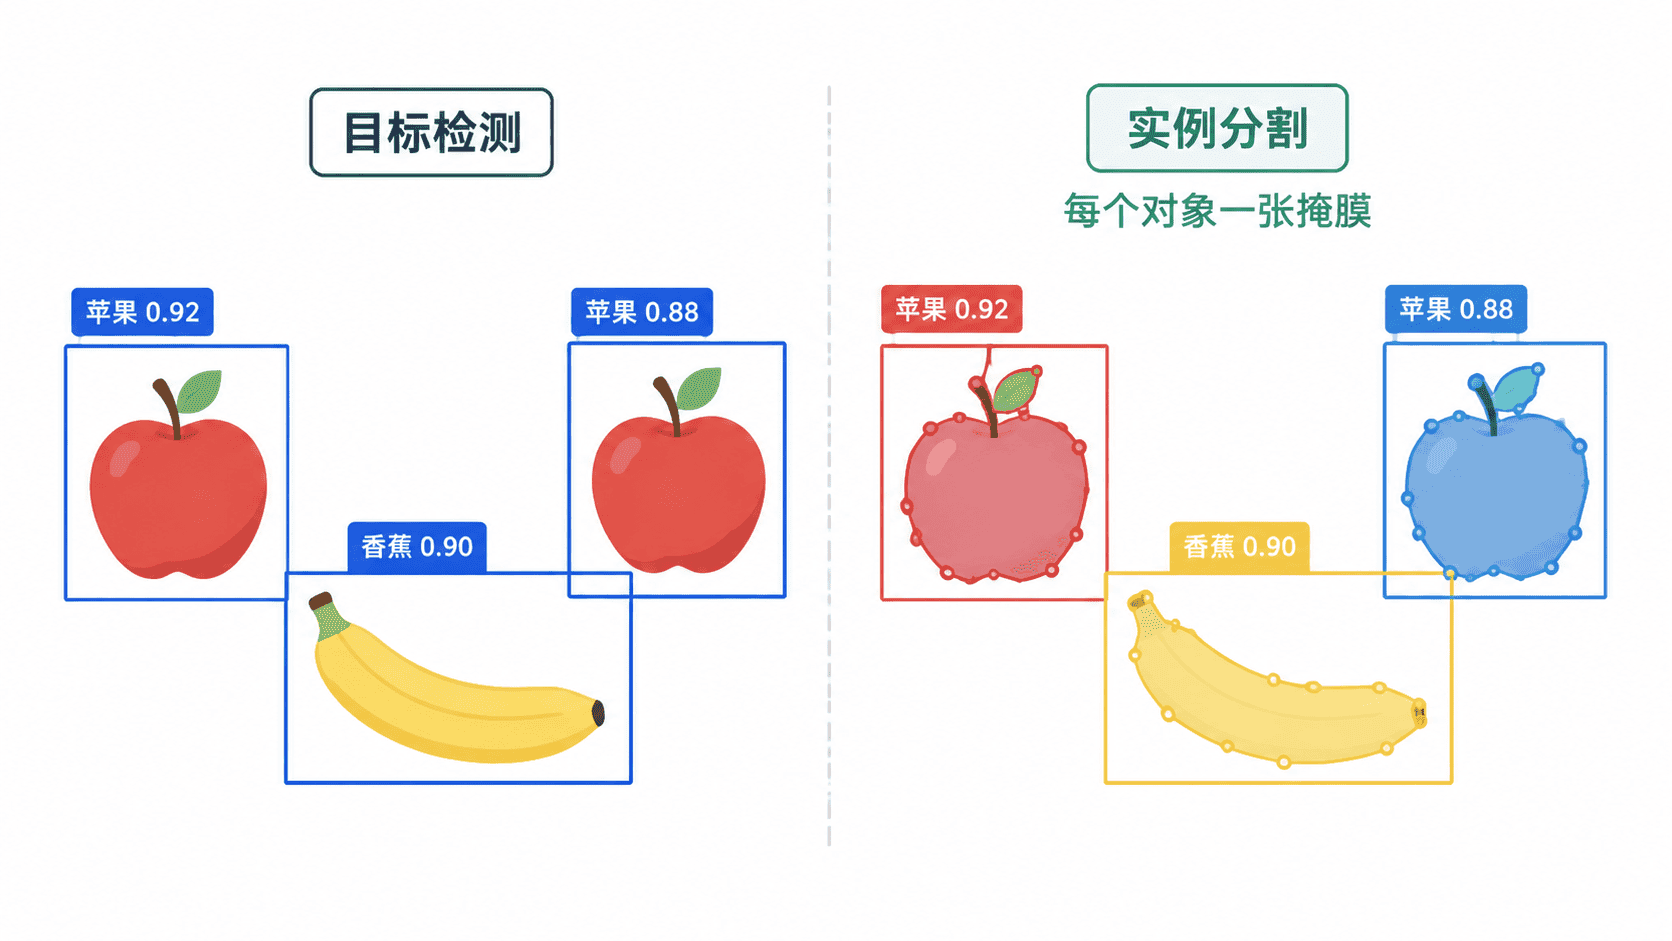
在推理结果中,边界框、类别和置信度仍位于 result.boxes,实例掩膜位于 result.masks。二值掩膜适合逐像素计算,像素坐标多边形适合 OpenCV 绘制,归一化多边形适合保存或继续转换标注。
准备多边形标注数据
图片与标签文件必须同名,例如 0001.jpg 对应 0001.txt。推荐按训练集和验证集分开组织,空白图片可保留一个空标签文件,也可以不创建标签文件,但同一项目应采用一致规则。
data/fruit_seg/
├─ images/
│  ├─ train/
│  │  └─ 0001.jpg
│  └─ val/
│     └─ 0002.jpg
├─ labels/
│  ├─ train/
│  │  └─ 0001.txt
│  └─ val/
│     └─ 0002.txt
└─ seg.yaml
每行表示一个实例,格式为类别编号后跟若干个归一化顶点坐标。一个多边形至少需要三个点,所有 x、y 都应位于 0 到 1 之间。
<class_id> <x1> <y1> <x2> <y2> ... <xn> <yn>下面是一条四边形实例标注。它只表示一个对象;同一图片包含多个对象时,应继续增加多行。
0 0.2100 0.1800 0.4600 0.1700 0.4800 0.6200 0.2200 0.6400数据集配置中的类别顺序必须与标签编号一致。path 是数据集根目录,train 和 val 均相对于该目录解析。
path: data/fruit_seg
train: images/train
val: images/val

names:
  0: apple
  1: banana
配置生效后,训练程序会在对应图片目录旁查找 labels/train 和 labels/val。正式训练前应抽查若干标注,确认轮廓贴合目标、顶点顺序连续、类别编号没有越界。
训练并执行推理
下面的脚本使用 yolov8n-seg.pt 作为预训练权重。它先训练自定义数据集,再加载固定输出目录中的 best.pt 对验证图片推理;retina_masks=True 便于获得与原图分辨率一致的高分辨率掩膜。
from __future__ import annotations

import argparse
from pathlib import Path

from ultralytics import YOLO

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--data", type=Path, required=True)
    parser.add_argument("--source", type=Path, required=True)
    parser.add_argument("--model", default="yolov8n-seg.pt")
    parser.add_argument("--epochs", type=int, default=50)
    parser.add_argument("--imgsz", type=int, default=640)
    parser.add_argument("--conf", type=float, default=0.25)
    parser.add_argument("--project", type=Path, default=Path("runs/segment"))
    parser.add_argument("--name", default="fruit-seg")
    args = parser.parse_args()

    model = YOLO(args.model)
    model.train(
        data=str(args.data),
        epochs=args.epochs,
        imgsz=args.imgsz,
        project=str(args.project),
        name=args.name,
        exist_ok=True,
    )

    best_path = args.project / args.name / "weights" / "best.pt"
    if not best_path.exists():
        raise FileNotFoundError(f"未找到最佳权重:{best_path}")

    predict_name = f"{args.name}-predict"
    segment_model = YOLO(str(best_path))
    results = segment_model.predict(
        source=str(args.source),
        conf=args.conf,
        save=True,
        retina_masks=True,
        project=str(args.project),
        name=predict_name,
        exist_ok=True,
        verbose=False,
    )

    first = results[0]
    instance_count = 0 if first.masks is None else len(first.masks.data)

    print(f"best: {best_path.resolve()}")
    print(f"predict_dir: {(args.project / predict_name).resolve()}")
    print(f"instances: {instance_count}")

    if first.masks is not None and instance_count > 0:
        print(f"first_polygon_points: {len(first.masks.xy[0])}")
    else:
        print("first_polygon_points: 0")

if __name__ == "__main__":
    main()
预期结果
脚本可完成训练、加载最佳权重并保存分割推理图;实际训练日志由数据量和运行设备决定。运行前确保 seg.yaml、图片和标签路径均存在。训练过程会产生较多进度日志,下面只列出脚本结束时的关键输出。
python segment_pipeline.py --data data/fruit_seg/seg.yaml --source data/fruit_seg/images/val/0002.jpg --epochs 50预期输出
best: <PATH>/runs/segment/fruit-seg/weights/best.pt
predict_dir: <PATH>/runs/segment/fruit-seg-predict
instances: <N>
first_polygon_points: <POINTS><PATH>、<N> 和 <POINTS> 会随运行环境与推理结果变化。输出目录中应出现带掩膜叠加效果的图片;若 instances 为 0,应先降低置信度做排查,再检查验证图片是否属于训练分布。
读取结果与验收
masks.data 是逐实例二值掩膜集合,适合计算面积、交并比或提取前景;masks.xy 是原图像素坐标轮廓,适合交给 OpenCV;masks.xyn 是归一化轮廓,适合跨尺寸保存。读取这些字段前必须判断 result.masks 是否为 None。
验收时不能只看边界框。轮廓应贴合目标边缘,不应跨越到相邻实例;两个相互接触的同类目标也应保持独立。若框准确但掩膜粗糙,应优先检查标注边界、输入分辨率和小目标占比,而不是只调整置信度。
常见失败处理
使用普通检测权重 yolov8n.pt 时不会产生实例掩膜,应改用带 -seg 后缀的模型。标签仍采用检测框格式时,分割训练无法获得正确轮廓信息,必须重新导出多边形标注。
多边形自交、顶点跳跃或坐标超出 0 到 1 会造成异常轮廓。类别编号超过 names 范围会导致数据检查失败。训练能够启动但验证结果为空时,应继续核对图片与标签是否同名,以及 images、labels 的目录层级是否严格对应。