
计算机视觉 / 系统课时
YOLOv8 模型结构
YOLOv8 模型结构
本课从一张完整的数据流图出发,说明图像进入 YOLOv8 后如何依次经过 Backbone、Neck 和 Head,并最终得到类别、置信度与边界框结果。学完后,你能看懂模型结构图,也能判断某个模块究竟负责“提取特征”“融合特征”还是“生成预测”。
学习目标
- 说清 Backbone、Neck 和 Head 的职责与连接关系
- 理解 C2f、SPPF、多尺度融合和无锚框检测头的作用
- 能沿着一次前向传播解释检测结果如何产生
整体数据流
YOLOv8 的检测流程可以概括为:输入图像先被缩放并整理为张量,Backbone 逐步降低特征图尺寸并提取语义信息,Neck 融合不同层级的特征,Head 在多个尺度上输出分类和边界框预测,最后再经过置信度筛选与非极大值抑制得到最终检测框。
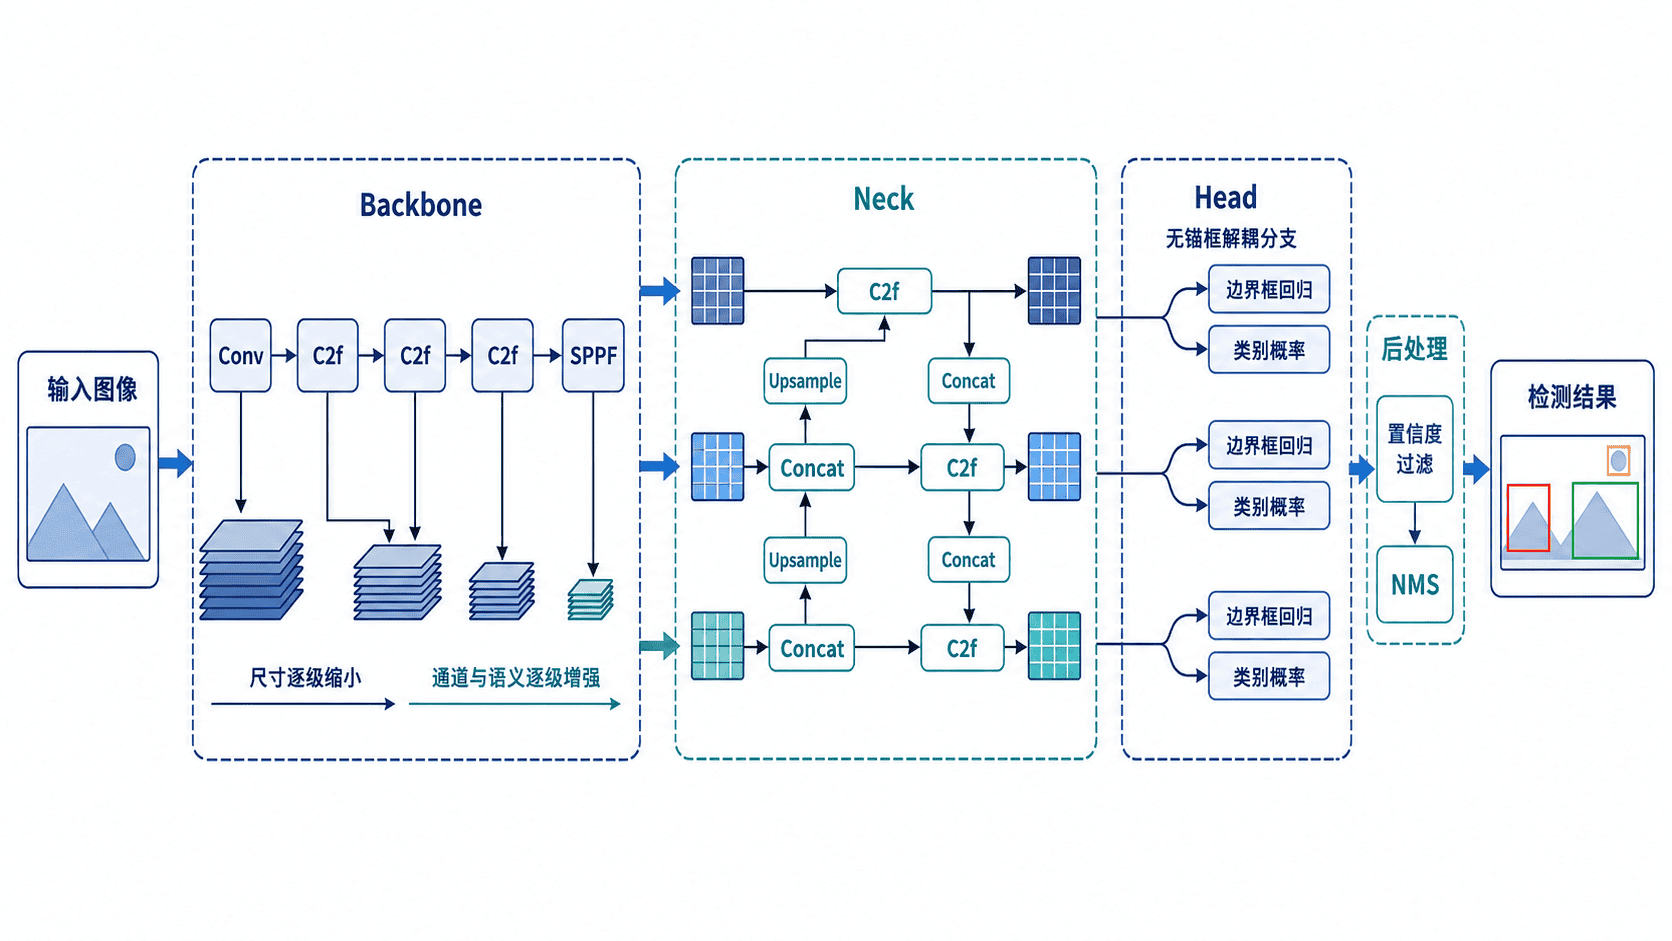
Backbone、Neck 和 Head 不是三个彼此独立的程序,而是一次前向传播中的连续阶段。理解它们时,重点不是记住每一层的编号,而是跟踪“空间分辨率、语义强度和定位细节”如何变化。
Backbone:提取分层特征
Backbone 负责把原始像素转换成可用于检测的特征。网络越向后,特征图通常越小,感受野越大,表达也从边缘、纹理逐渐转向物体部件和整体语义。YOLOv8 使用卷积进行下采样,并通过 C2f 模块保留更充分的梯度流和多层特征。
C2f 可以理解为一种高效的特征聚合结构:输入特征被拆分后,一部分经过多个 Bottleneck,另一部分保留较短路径,最后再拼接融合。它兼顾了表达能力与计算效率,是 YOLOv8 主干和颈部的核心模块之一。
Backbone 末端的 SPPF 会以较低开销聚合不同感受野的信息,使模型在不继续大幅降低分辨率的情况下看到更大范围的上下文。它对尺寸差异较大的目标尤其有帮助,但并不会直接输出检测框。
Neck:融合不同尺度
只使用 Backbone 最深层特征,虽然语义强,却容易丢失小目标所需的细节;只使用浅层特征,又缺乏区分类别所需的高级语义。Neck 的任务就是让不同层级互相补充。
YOLOv8 的 Neck 采用类似 FPN 与 PAN 的双向融合思路。自顶向下路径把深层语义传给高分辨率特征,自底向上路径再把定位信息送回低分辨率特征。经过上采样、拼接和 C2f 处理后,模型会得到多个尺度的融合特征,分别适合检测小、中、大目标。
这里的“多尺度”指同一张图像在不同分辨率的特征图上被同时分析,而不是把输入图像重复缩放多次。每个尺度都承担一部分目标尺寸范围,最终结果再统一合并。
Head:生成检测预测
YOLOv8 使用无锚框、解耦式检测头。无锚框表示模型不再依赖预先设定的一组 Anchor 形状,而是直接以特征图位置为参考预测目标边界。这样可以减少锚框匹配与调参负担。
“解耦”表示分类与边界框回归由不同分支完成。分类分支判断当前位置更可能属于哪个类别,回归分支预测目标边界相对参考点的距离分布,再还原为实际坐标。训练时,边界框回归通常结合 IoU 类损失与分布式回归思想,使定位更稳定。
Head 会在多个尺度上产生大量候选结果。推理阶段先按置信度去除明显无效的候选,再通过 NMS 合并高度重叠且属于同类的框。最终输出通常包含边界框坐标、类别编号和置信度。
如何阅读模型结构图
阅读任何 YOLOv8 结构图时,可以按三步判断。先看特征图尺寸是否逐级缩小,以确认 Backbone 的下采样路径;再看是否存在上采样、拼接和双向连接,以确认 Neck 的多尺度融合;最后看多个输出尺度是否分别进入分类与回归分支,以确认 Head 的预测方式。
不要把模块名称等同于功能。例如,C2f 同时出现在 Backbone 和 Neck 中,但前者偏向特征提取,后者偏向融合后的特征重整。判断模块作用时,应结合它所在的位置、输入来源和输出去向。