
计算机视觉 / 系统课时
优化实时帧率
优化实时帧率
实时视频检测的目标不是单纯追求更高的数字,而是在可接受精度下保持画面不过度积压、结果足够及时。本课将把缩放输入、主动跳帧、异步读取和轻量模型组合成一条低延迟处理管线,并用可运行脚本验证优化效果。
学习目标
- 区分吞吐量、端到端延迟与显示帧率
- 使用最新帧队列、输入缩放和跳帧降低积压
- 按正确顺序选择模型与参数并验证收益
先区分三个性能指标
吞吐量表示每秒完成多少次推理,端到端延迟表示一帧从采集到显示经历了多久,显示帧率则受解码、绘制和窗口刷新共同影响。只观察窗口右上角的 FPS,可能掩盖“画面很流畅但结果落后数秒”的积压问题。
同步循环会依次执行读取、预处理、推理和绘制。任一环节变慢,后续帧就会在摄像头或缓冲区中排队。实时场景更适合“只保留最新帧”:宁可丢弃已经过时的画面,也不要持续处理历史帧。
四项优化如何配合
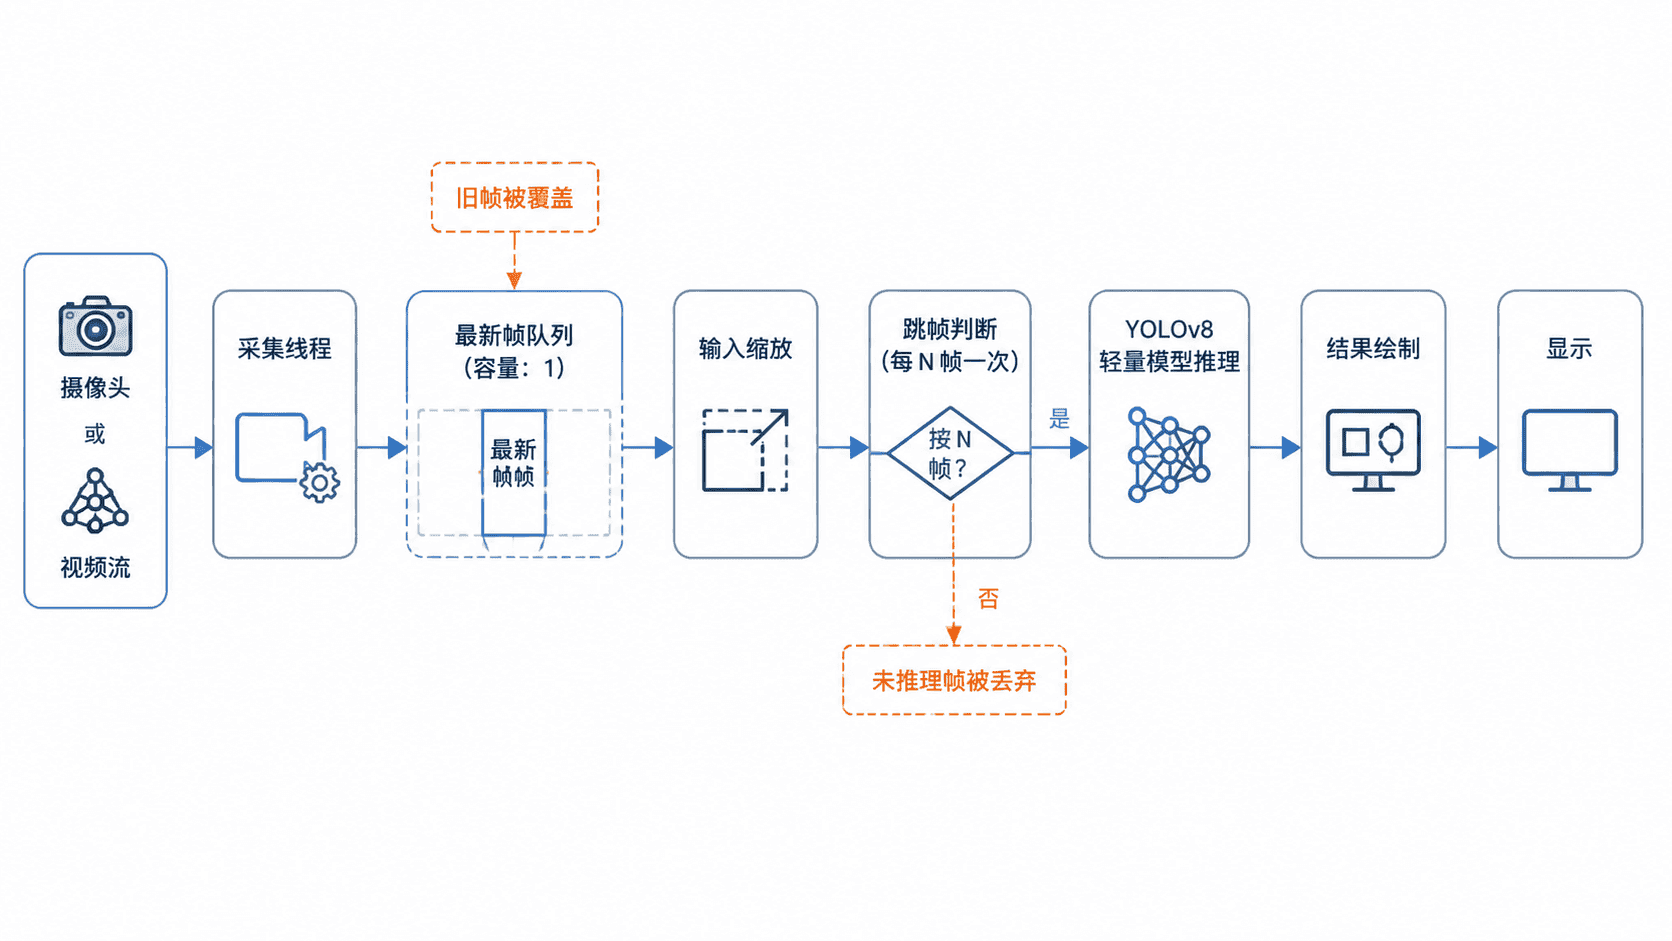
输入缩放负责减少图像搬运、预处理和绘制开销;imgsz 进一步控制模型实际推理尺寸。主动跳帧减少推理次数,异步读取避免读取操作阻塞主线程,轻量模型则直接降低单次推理成本。
这四项优化解决的问题不同。异步读取不会让模型本身变快,它主要防止读取与推理串行等待;最新帧队列也不会提高精度,它的价值是限制排队长度,让结果尽量贴近当前画面。
实现低延迟处理管线
下面的完整脚本使用独立线程读取视频,只在队列中保留最新一帧。主线程按 infer_every 控制推理频率,并在推理前缩放输入。yolov8n.pt 是轻量模型示例,生产项目应替换为自己的权重。
import argparse
import queue
import threading
import time
from typing import Union

import cv2
from ultralytics import YOLO

class LatestFrameReader:
    def __init__(self, source: Union[int, str]) -> None:
        self.capture = cv2.VideoCapture(source)
        if not self.capture.isOpened():
            raise RuntimeError(f"无法打开视频源: {source}")

        self.frames: queue.Queue[tuple[int, object]] = queue.Queue(maxsize=1)
        self.stopped = threading.Event()
        self.sequence = 0
        self.thread = threading.Thread(target=self._read_loop, daemon=True)

    def start(self) -> "LatestFrameReader":
        self.thread.start()
        return self

    def _read_loop(self) -> None:
        while not self.stopped.is_set():
            ok, frame = self.capture.read()
            if not ok:
                self.stopped.set()
                break

            self.sequence += 1

            # 队列只保留最新帧,避免推理速度不足时不断累积延迟。
            if self.frames.full():
                try:
                    self.frames.get_nowait()
                except queue.Empty:
                    pass

            self.frames.put((self.sequence, frame))

    def read(self, timeout: float = 1.0) -> tuple[int, object]:
        return self.frames.get(timeout=timeout)

    def stop(self) -> None:
        self.stopped.set()
        self.thread.join(timeout=1.0)
        self.capture.release()

def parse_source(value: str) -> Union[int, str]:
    return int(value) if value.isdigit() else value

def resize_by_width(frame, target_width: int):
    if target_width <= 0 or frame.shape[1] <= target_width:
        return frame

    ratio = target_width / frame.shape[1]
    target_height = int(frame.shape[0] * ratio)
    return cv2.resize(
        frame,
        (target_width, target_height),
        interpolation=cv2.INTER_AREA,
    )

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--source", default="0")
    parser.add_argument("--model", default="yolov8n.pt")
    parser.add_argument("--input-width", type=int, default=960)
    parser.add_argument("--imgsz", type=int, default=640)
    parser.add_argument("--infer-every", type=int, default=2)
    parser.add_argument("--conf", type=float, default=0.25)
    parser.add_argument("--device", default="cpu")
    parser.add_argument("--half", action="store_true")
    args = parser.parse_args()

    if args.infer_every < 1:
        raise ValueError("--infer-every 必须大于等于 1")

    model = YOLO(args.model)
    reader = LatestFrameReader(parse_source(args.source)).start()
    use_half = args.half and args.device != "cpu"

    window_started = time.perf_counter()
    completed = 0

    try:
        while not reader.stopped.is_set():
            try:
                sequence, frame = reader.read()
            except queue.Empty:
                continue

            # 主动跳过部分帧,控制单位时间内的推理次数。
            if sequence % args.infer_every != 0:
                continue

            resized = resize_by_width(frame, args.input_width)
            infer_started = time.perf_counter()

            result = model.predict(
                source=resized,
                imgsz=args.imgsz,
                conf=args.conf,
                device=args.device,
                half=use_half,
                verbose=False,
            )[0]

            infer_ms = (time.perf_counter() - infer_started) * 1000
            annotated = result.plot()
            completed += 1

            elapsed = time.perf_counter() - window_started
            if elapsed >= 1.0:
                processed_fps = completed / elapsed
                print(
                    f"processed_fps={processed_fps:.1f}, "
                    f"infer_ms={infer_ms:.1f}"
                )
                completed = 0
                window_started = time.perf_counter()

            cv2.imshow("YOLOv8 realtime", annotated)
            if cv2.waitKey(1) & 0xFF == ord("q"):
                break
    finally:
        reader.stop()
        cv2.destroyAllWindows()

if __name__ == "__main__":
    main()
预期结果:脚本能够打开摄像头或视频流,窗口持续显示当前检测结果,终端每秒打印一次处理帧率和最近一次推理耗时。具体数值由模型、硬件和视频源决定。
运行并验证效果
在已安装 ultralytics 与 opencv-python 的环境中运行脚本。摄像头通常使用 0,视频文件或 RTSP 地址可直接替换 --source。
python realtime_fps.py --source 0 --model yolov8n.pt --input-width 960 --imgsz 640 --infer-every 2 --device cpu预期输出如下,其中 <FPS> 与 <MS> 是动态值,实际结果可能不同。
processed_fps=<FPS>, infer_ms=<MS>
processed_fps=<FPS>, infer_ms=<MS>
验证时先记录基线,再一次只修改一个变量。建议依次测试 imgsz、input-width、infer-every 和模型尺寸,同时观察处理帧率、推理耗时、目标漏检情况以及画面是否仍然贴近实时。
调参顺序与边界
优先选择满足精度要求的最小模型,然后降低 imgsz,再决定是否缩放原始画面。仍达不到实时要求时才增加 infer-every,因为跳帧会降低时间覆盖率,快速移动目标可能恰好出现在被跳过的帧中。
异步读取适合摄像头和网络视频,但它无法修复网络抖动、解码失败或模型过慢。若 GPU 利用率很低,应检查视频解码和数据复制;若 GPU 长期满载,则应优先调整模型、输入尺寸、精度模式或部署运行时。