
计算机视觉 / 系统课时
模型规格与任务类型
模型规格与任务类型
本课解决两个常见选型问题:同一种任务该选 YOLOv8n、s、m、l 还是 x,以及面对检测、分割、分类、姿态估计和旋转框需求时应使用哪类模型。最终你将得到一套不依赖固定跑分、可结合设备与业务约束落地的选择方法。
学习目标
- 理解 n、s、m、l、x 五种模型规模的主要差异
- 区分检测、分割、分类、姿态估计和旋转框任务的输出
- 能根据精度、速度、显存和部署环境完成初步选型
模型规模代表什么
YOLOv8 常见规格从小到大依次为 n、s、m、l、x。它们使用相近的总体架构,但网络深度、通道宽度、参数量和计算量逐级增加。模型越大,通常越有机会获得更高精度,但训练更慢、显存占用更高,推理延迟也更大。
| 规格 | 主要特点 | 常见适用场景 |
|---|---|---|
| n | 最轻量,速度优先 | 移动端、边缘设备、快速原型 |
| s | 轻量与精度较均衡 | 普通实时检测、入门项目 |
| m | 更强表达能力 | 服务器推理、精度要求较高的业务 |
| l | 较高精度,资源消耗明显 | GPU 服务、复杂场景 |
| x | 最大规模,精度优先 | 研究、离线分析、资源充足环境 |
表中的结论是相对关系,不是固定性能承诺。真实速度会受到输入尺寸、批量大小、GPU 或 CPU 型号、推理框架、精度模式以及后处理数量影响,因此不能只根据模型名称判断是否满足实时要求。
五类任务的输出差异
检测任务输出目标类别与水平边界框,适合人数统计、车辆检测和缺陷定位。实例分割在检测框之外继续输出每个实例的像素级掩码,适合轮廓测量、抠图和目标面积计算。
分类任务只判断整张图像属于哪个类别,不定位目标位置。姿态估计在检测到对象后输出关键点及其置信度,例如人体关节。旋转框任务输出带角度的边界框,适合航拍、文本、船舶或密集倾斜目标。
| 任务 | 主要输出 | 选择依据 |
|---|---|---|
| 检测 | 类别、置信度、水平框 | 只需知道目标在哪里 |
| 分割 | 类别、框、实例掩码 | 需要精确轮廓或面积 |
| 分类 | 整图类别概率 | 图中只有一个主要判断对象 |
| 姿态估计 | 对象框、关键点 | 需要分析姿势或关节位置 |
| 旋转框 | 类别、置信度、角度框 | 目标方向变化大且密集 |
同一规模字母可以出现在不同任务模型中,但它们的 Head、训练标签和输出结构并不相同。模型文件名中的任务后缀只是快速识别方式,真正选型仍要从业务输出开始。
一套可执行的选型顺序
选型时先决定任务,再决定模型规模。若业务只关心“有没有目标、目标在哪里”,优先检测;只有当水平框无法表达需求时,才升级到分割、姿态或旋转框。任务类型选错,比模型规格偏小更难补救。
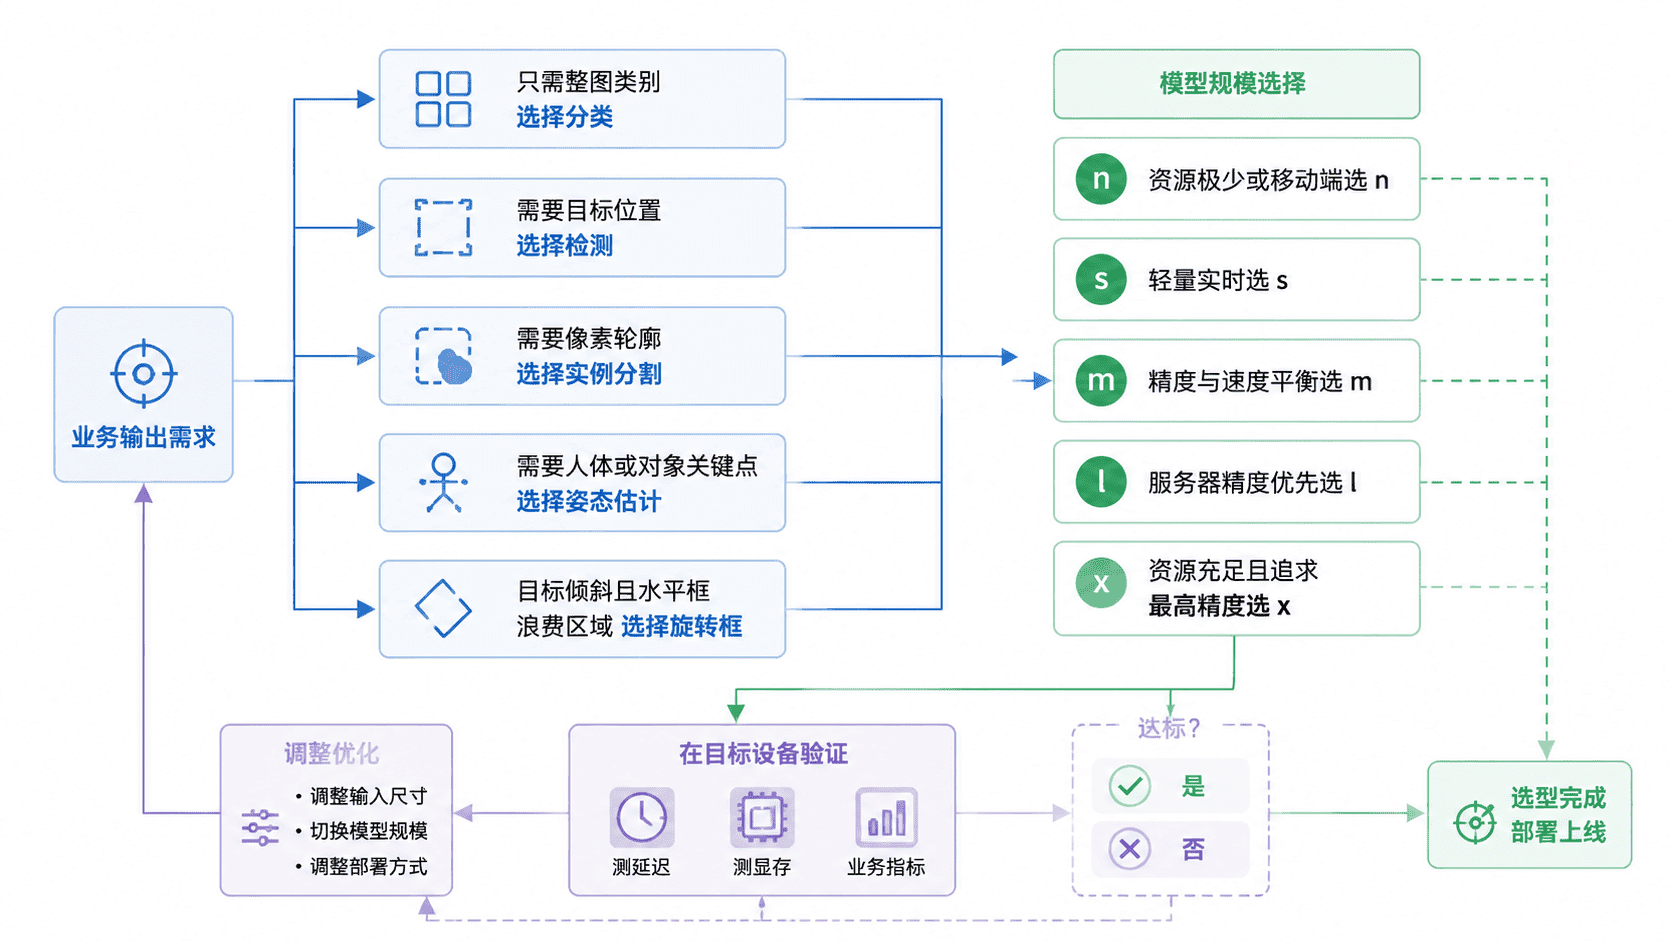
确定任务后,先用较小模型建立基线。n 或 s 能快速验证数据格式、训练流程和业务可行性。如果精度不足,再在相同数据划分和评估指标下升级到 m、l 或 x。直接从最大模型开始,往往会让训练周期、显存需求和问题定位成本同时上升。
最后必须在目标部署设备上实测。服务端模型不仅要看单张图片延迟,还要观察并发吞吐、显存峰值和后处理时间;边缘设备还要检查模型转换、算子支持、功耗和持续运行温度。公开基准只能用于缩小候选范围,不能替代项目验收。
常见选型误区
第一个误区是认为模型越大一定越适合。若数据量小、标注噪声高或类别边界不清,大模型也可能只增加训练成本,无法稳定提升业务指标。
第二个误区是把分割当作“更高级的检测”。分割标签制作成本更高,输出和后处理也更复杂。只有业务确实需要像素级轮廓时,增加这部分成本才有意义。
第三个误区是只看平均精度。实际系统还要考虑漏检代价、误检代价、单类指标、最小目标尺寸和端到端延迟。模型选择应以业务验收指标为准,而不是单个公开榜单数字。
快速决策示例
假设要在普通 GPU 服务器上识别仓库中的人员与叉车,只需要水平框,并要求接近实时。合理起点是检测任务的 s 规格;若小目标召回不足,可先检查数据与输入尺寸,再对比 m 规格,而不是立即改用分割或 x 规格。
若任务改为统计零件表面缺陷的真实面积,水平框无法代表缺陷轮廓,此时应改用实例分割。任务类型变化后,需要重新准备掩码标签,不能直接沿用只有矩形框的检测数据集。