
计算机视觉 / 系统课时
导出 TensorRT 引擎
导出 TensorRT 引擎
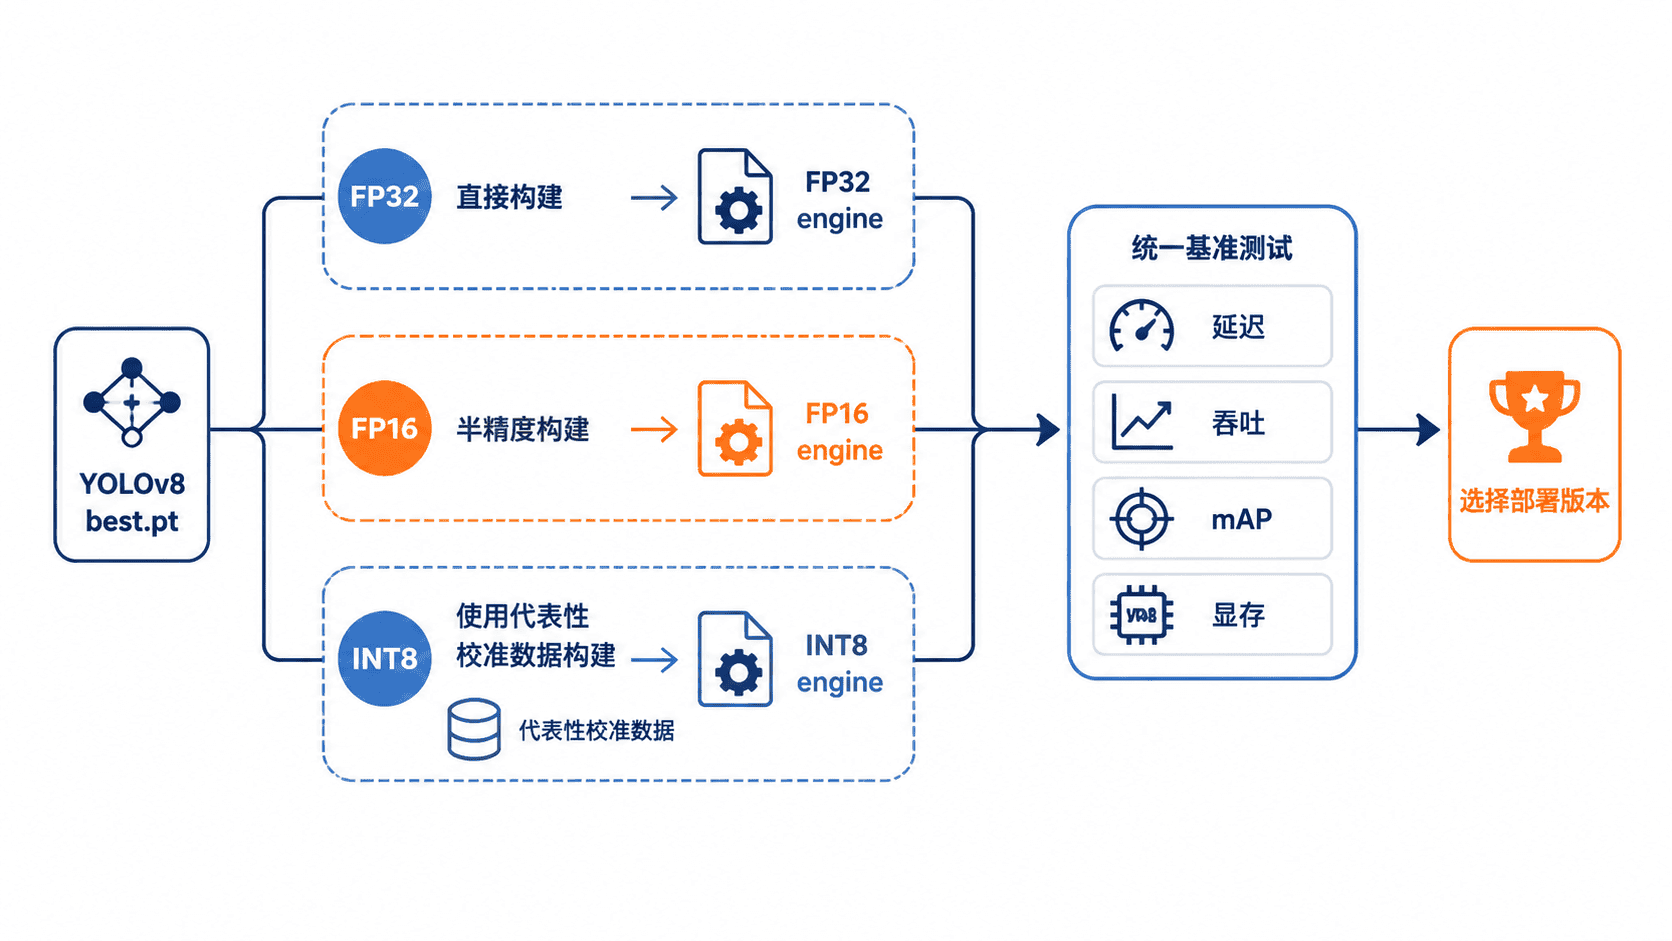
本课把训练得到的 YOLOv8 权重转换为可部署的 TensorRT 引擎,并用统一数据比较 FP32、FP16 与 INT8 的延迟和精度差异。完成后,你将得到可验证、可选择而不是只看文件是否生成的导出结果。
学习目标
- 检查 GPU、驱动、CUDA 与 Ultralytics 是否满足 TensorRT 导出条件
- 导出 FP32、FP16 和 INT8 三种精度的
.engine文件 - 使用相同输入与验证集比较速度、精度损失和部署代价
先确定可导出的环境
TensorRT 面向 NVIDIA GPU,导出过程会根据当前 GPU、TensorRT 版本和输入尺寸选择执行内核。因此,生产引擎应尽量在目标部署机或相同型号 GPU、相同软件栈中构建;换 GPU、驱动或 TensorRT 大版本后,应重新导出并验证。
Ultralytics 当前导出接口使用 format="engine" 生成 TensorRT 引擎,FP16 和 INT8 可分别通过 quantize=16 与 quantize=8 指定。INT8 还需要代表性数据完成校准,并应在实际部署设备上完成校准。:contentReference[oaicite:0]{index=0}
先在准备导出的虚拟环境中执行检查。最新 TensorRT 的具体 CUDA、驱动和 GPU 架构要求会随版本变化,应以所安装版本的支持矩阵为准。
nvidia-smi --query-gpu=name,driver_version,memory.total --format=csv,noheader
python - <<'PY'
import torch
import ultralytics

print(f"CUDA available: {torch.cuda.is_available()}")
print(f"PyTorch CUDA: {torch.version.cuda}")
print(f"Ultralytics: {ultralytics.__version__}")
PY
预期输出如下,尖括号中的实际值会因机器而异:
<GPU_NAME>, <DRIVER_VERSION>, <MEMORY_MIB> MiB
CUDA available: True
PyTorch CUDA: <CUDA_VERSION>
Ultralytics: <ULTRALYTICS_VERSION>
若 CUDA available 为 False,先修复 PyTorch CUDA 环境;若 nvidia-smi 无法执行,先处理驱动问题。不要在 CPU 环境中继续尝试 TensorRT 导出。
生成三种精度引擎
下面的完整脚本从同一份 best.pt 构建三种引擎,并在每次导出后重命名,避免后一次导出覆盖前一次结果。把 WEIGHTS 和 DATA 改成自己的权重与数据集配置路径。
from pathlib import Path
import shutil

from ultralytics import YOLO

WEIGHTS = Path("runs/detect/train/weights/best.pt")
DATA = Path("data.yaml")
OUTPUT_DIR = Path("deploy")
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

def export_engine(label: str, **options: object) -> Path:
    # 每次重新加载原始权重,确保三个精度分支使用同一模型起点
    model = YOLO(str(WEIGHTS))
    exported = Path(
        model.export(
            format="engine",
            imgsz=640,
            batch=1,
            device=0,
            dynamic=False,
            workspace=4,
            **options,
        )
    )

    target = OUTPUT_DIR / f"best-{label}.engine"
    if target.exists():
        target.unlink()
    shutil.move(str(exported), target)
    return target

if __name__ == "__main__":
    print(f"fp32: {export_engine('fp32')}")
    print(f"fp16: {export_engine('fp16', quantize=16)}")
    print(
        "int8:",
        export_engine(
            "int8",
            quantize=8,
            data=str(DATA),
            fraction=1.0,
        ),
    )
预期结果是 deploy 目录出现三个文件,脚本末尾输出:
fp32: deploy/best-fp32.engine
fp16: deploy/best-fp16.engine
int8: deploy/best-int8.engine
workspace=4 表示最多提供 4 GiB 构建工作区,并不等于最终引擎大小。显存不足时先降低 workspace、batch 或 imgsz。INT8 的 data.yaml 必须能访问代表真实业务分布的图片,否则校准速度虽可能提升,精度损失却可能不可接受。
用同一输入比较速度和误差
只比较单次首帧耗时会把引擎初始化和缓存开销算进去。下面先预热,再对同一张图片测量平均延迟,同时在同一验证集上读取 mAP50 与 mAP50-95。
from pathlib import Path
from statistics import mean
from time import perf_counter

import torch
from ultralytics import YOLO

DATA = "data.yaml"
IMAGE = "datasets/project/images/val/sample.jpg"
ENGINES = {
    "fp32": Path("deploy/best-fp32.engine"),
    "fp16": Path("deploy/best-fp16.engine"),
    "int8": Path("deploy/best-int8.engine"),
}

def average_latency_ms(model: YOLO, warmup: int = 10, runs: int = 50) -> float:
    for _ in range(warmup):
        model.predict(IMAGE, imgsz=640, device=0, verbose=False)

    costs = []
    for _ in range(runs):
        torch.cuda.synchronize()
        started = perf_counter()
        model.predict(IMAGE, imgsz=640, device=0, verbose=False)
        torch.cuda.synchronize()
        costs.append((perf_counter() - started) * 1000)
    return mean(costs)

if __name__ == "__main__":
    baseline_map = None
    for label, engine_path in ENGINES.items():
        model = YOLO(str(engine_path), task="detect")
        latency = average_latency_ms(model)
        metrics = model.val(data=DATA, imgsz=640, batch=1, device=0, verbose=False)

        current_map = float(metrics.box.map)
        if baseline_map is None:
            baseline_map = current_map
        delta = current_map - baseline_map

        print(
            f"{label}: latency={latency:.2f} ms, "
            f"mAP50={float(metrics.box.map50):.4f}, "
            f"mAP50-95={current_map:.4f}, delta={delta:+.4f}"
        )
预期输出格式如下,具体数值由 GPU、模型和数据集决定:
fp32: latency=<LATENCY_MS> ms, mAP50=<MAP50>, mAP50-95=<MAP>, delta=+0.0000
fp16: latency=<LATENCY_MS> ms, mAP50=<MAP50>, mAP50-95=<MAP>, delta=<DELTA>
int8: latency=<LATENCY_MS> ms, mAP50=<MAP50>, mAP50-95=<MAP>, delta=<DELTA>
比较时必须固定 imgsz、batch、验证集、预处理和置信度设置。若只改变精度却同时改变输入尺寸,得到的速度与精度差异就无法归因。
选择精度并处理失败
| 精度 | 主要特点 | 适用选择 |
|---|---|---|
| FP32 | 精度基线稳定,通常速度和显存占用最高 | 用于建立基准或硬件不适合低精度时 |
| FP16 | 通常能明显降低延迟与显存,精度变化较小 | 支持 FP16 的 NVIDIA GPU 上优先验证 |
| INT8 | 延迟和吞吐潜力最高,但依赖校准数据 | 边缘部署或高吞吐场景,且精度损失可接受 |
导出报显存不足时,按 workspace、batch、imgsz 的顺序逐步降低资源要求。加载引擎出现版本或硬件不兼容时,不要复制旧引擎反复尝试,应在目标环境重新构建。INT8 指标下降明显时,先检查校准数据是否覆盖小目标、弱光、遮挡和主要类别,再决定是否扩大校准集或退回 FP16。