
计算机视觉 / 系统课时
姿态估计任务
姿态估计任务
本课使用 YOLOv8 姿态模型识别图像中的人体关键点,并把模型输出解析为可使用的坐标与置信度。你将理解关键点、骨架连接和图像坐标之间的关系,最终得到每个人的 17 个关键点数据。
学习目标
- 理解关键点编号、坐标和骨架连接的含义
- 使用 YOLOv8 姿态模型完成图片推理
- 读取每个人的关键点坐标与置信度并处理未检测情况
理解关键点和骨架关系
姿态估计不是只画一个人体框,而是在人体上定位鼻子、眼睛、肩膀、肘部、手腕、髋部、膝盖和脚踝等关键点。常用的 COCO 人体姿态格式包含 17 个关键点,模型再按预定义连接关系把相关关节连成骨架。
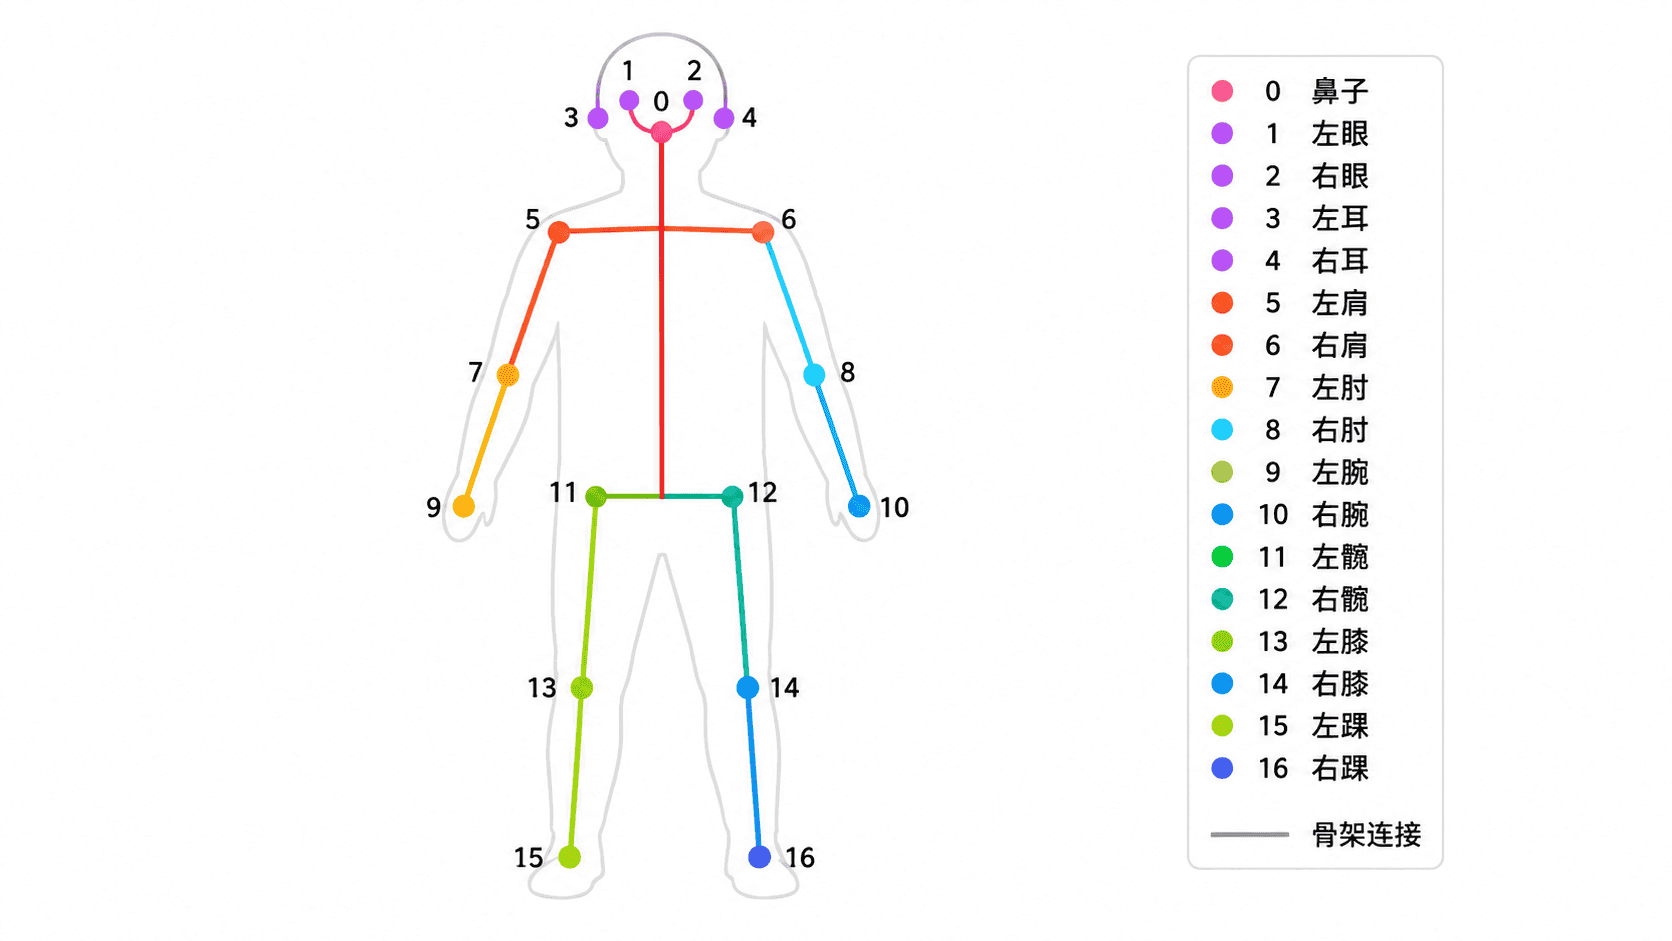
每个关键点通常包含二维坐标 和置信度。图像左上角是坐标原点,向右为 增大,向下为 增大。关键点置信度较低时,说明该关节可能被遮挡、超出画面或定位不稳定。
运行姿态模型推理
先安装 Ultralytics,并准备一张包含完整或部分人体的测试图片。下面使用官方预训练轻量模型 yolov8n-pose.pt,无需自行训练即可完成通用人体姿态推理。
python -m pip install ultralytics预期输出
Successfully installed ultralytics-<VERSION><VERSION> 为实际安装版本。随后创建 pose_predict.py,运行以下完整脚本。
from ultralytics import YOLO

model = YOLO("yolov8n-pose.pt")
results = model.predict(
    source="person.jpg",
    conf=0.25,
    imgsz=640,
    save=True,
    verbose=False,
)

result = results[0]
person_count = 0 if result.keypoints is None else len(result.keypoints)

print(f"检测到的人数: {person_count}")
print(f"可视化结果目录: {result.save_dir}")
预期输出
检测到的人数: <COUNT>
可视化结果目录: <PATH>
<COUNT> 与输入图片有关,<PATH> 是本次运行生成的实际目录。保存后的图片会显示人体框、关键点和骨架,可先用它确认模型是否正确定位人物。
解析关键点坐标
下面脚本在同一次推理中读取关键点。result.keypoints.xy 的形状通常为“人数 × 17 × 2”,result.keypoints.conf 则保存每个关键点的置信度。
from ultralytics import YOLO

KEYPOINT_NAMES = [
    "nose", "left_eye", "right_eye", "left_ear", "right_ear",
    "left_shoulder", "right_shoulder", "left_elbow", "right_elbow",
    "left_wrist", "right_wrist", "left_hip", "right_hip",
    "left_knee", "right_knee", "left_ankle", "right_ankle",
]

model = YOLO("yolov8n-pose.pt")
result = model.predict(source="person.jpg", conf=0.25, verbose=False)[0]

if result.keypoints is None or len(result.keypoints) == 0:
    print("未检测到人体关键点")
else:
    xy = result.keypoints.xy.cpu().tolist()
    scores = result.keypoints.conf.cpu().tolist()

    for person_index, (person_xy, person_scores) in enumerate(zip(xy, scores), start=1):
        print(f"人物 {person_index}")
        for name, (x, y), score in zip(KEYPOINT_NAMES, person_xy, person_scores):
            print(f"{name}: x={x:.1f}, y={y:.1f}, conf={score:.3f}")
预期输出
人物 1
nose: x=<X>, y=<Y>, conf=<SCORE>
left_eye: x=<X>, y=<Y>, conf=<SCORE>
...
right_ankle: x=<X>, y=<Y>, conf=<SCORE>
坐标与置信度会随图片变化。若没有检测到人体,脚本只输出“未检测到人体关键点”,不会访问不存在的张量。
处理关键边界
关键点坐标默认对应原始图像像素,可直接用于绘制、角度计算或动作规则。若后续需要跨分辨率比较,应先将坐标归一化为 和 ,避免同一动作因图片尺寸不同而产生数值偏差。
不要只凭单个低置信度关键点判断动作。更稳妥的做法是先过滤置信度不足的关节,再检查完成一个动作所需的多个关键点是否同时可用。多人场景还应使用人物索引或跟踪 ID,避免把不同人的关节混在一起。