
计算机视觉 / 系统课时
排查误检与漏检
排查误检与漏检
本课建立一套可复用的检测错误排查顺序:先固定评估条件,再把问题分成误检、漏检、定位偏差和类别错误,最后依据证据判断应修改数据、标注、模型容量还是推理参数。
学习目标
- 能按统一标准分类四类典型检测错误
- 能从验证结果反推数据、标注、模型和阈值问题
- 能设计修复后的回归验证,避免只凭个别图片下结论
先固定评估条件
排查前先锁定模型权重、验证集、图像尺寸、置信度阈值和 IoU 阈值。若每次分析都更换参数,样本差异与参数差异会混在一起,无法判断问题究竟来自模型还是评估方式。
下面使用 YOLOv8 CLI 对固定验证集生成指标、混淆矩阵和预测结果。conf=0.001 适合完整评估召回能力,不代表部署时也要使用同样阈值。
yolo detect val model=runs/detect/train/weights/best.pt data=data.yaml split=val imgsz=640 conf=0.001 iou=0.7 plots=True save_json=True project=runs/diagnose name=val-error exist_ok=True预期输出
Ultralytics YOLOv8 <VERSION> Python-<VERSION> torch-<VERSION>
Model summary: <MODEL_SUMMARY>
Class     Images  Instances  Box(P      R      mAP50  mAP50-95)
all       <N>     <N>        <P>        <R>    <MAP50> <MAP50_95>
Results saved to runs/diagnose/val-error
实际版本、样本数和指标会不同。重点检查输出目录中的 confusion_matrix.png、PR_curve.png、val_batch*_pred.jpg 和 JSON 预测结果。
给错误建立统一分类
误检是背景被预测成目标,常见于背景纹理与目标相似、负样本不足或置信度阈值过低。漏检是已有标注目标未被模型检出,常见于小目标、遮挡、低对比度、训练样本不足或阈值过高。
定位偏差表示类别基本正确,但预测框与真实框重叠不足;类别错误表示框住了目标,却预测成错误类别。后两类经常与标注边界不一致、类别定义重叠、相似类别样本失衡或模型容量不足有关。
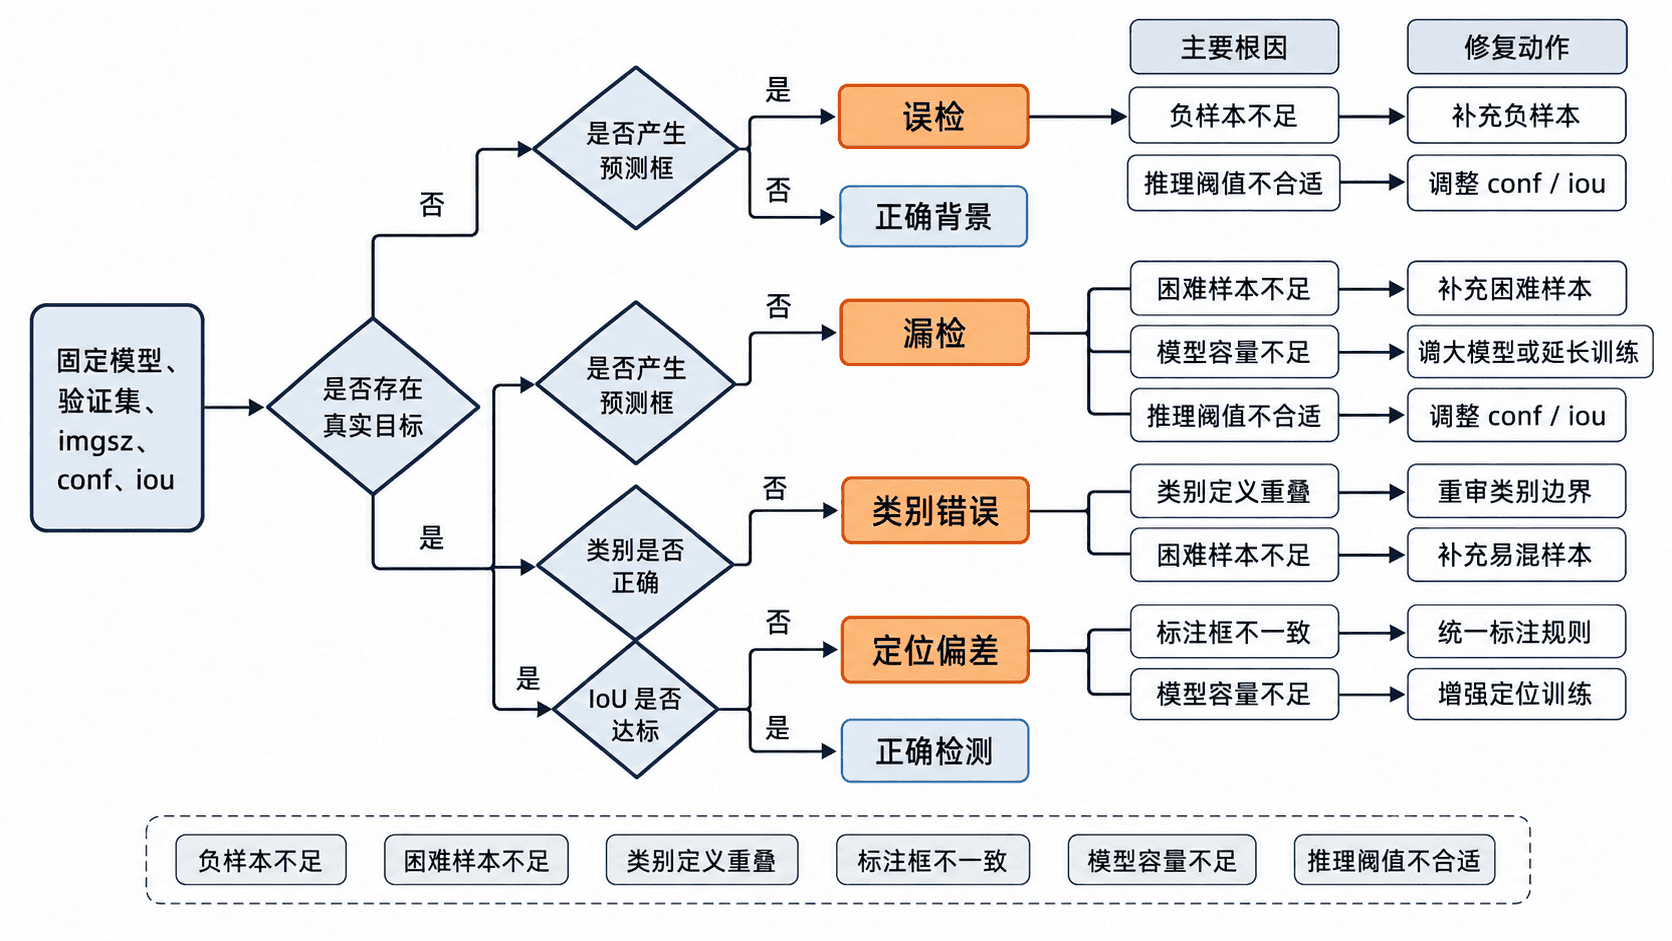
按证据定位根因
先看错误是否集中在少数场景。若雨天、夜间、远距离或某种背景中大量出错,优先补充对应数据;若同一目标在不同图片中的标注尺度和边界不一致,先修正标注规范;若训练集和验证集都对相似类别混淆,检查类别定义是否可被视觉区分。
再看模型与参数。训练损失仍高且各类错误普遍存在,可能需要更长训练、更大模型或更合适的输入尺寸;只有部署阈值变化时错误数量明显改变,则优先调整 conf 与 iou。提高置信度通常减少误检但增加漏检,降低置信度则相反,因此必须结合业务成本选择。
| 现象 | 优先检查 | 常见修复 |
|---|---|---|
| 背景纹理被重复识别 | 负样本与置信度 | 增加相似背景负样本,适度提高 conf |
| 小目标大量漏检 | 分辨率、标注与样本占比 | 提高 imgsz,补充小目标样本,检查框是否过小 |
| 相似类别互相混淆 | 类别定义与样本平衡 | 合并不可区分类别,补充边界样本 |
| 框位置系统性偏移 | 标注规范与图像预处理 | 统一框选规则,检查缩放和坐标转换 |
修复后做回归验证
每次只改变一个主要因素,例如先修标注,再训练同一模型;或保持权重不变,仅调整阈值。用同一验证集重新运行评估,并同时比较整体指标、各类别指标和原错误样本,避免总体 mAP 上升却让关键场景退化。
验收时至少记录基线版本、修改内容、验证集版本、参数和结果目录。对于高风险业务,还应建立一组固定的“必过样本”,逐张确认关键目标没有重新出现误检或漏检。