
计算机视觉 / 系统课时
批量与并发处理
批量与并发处理
批量处理解决单位时间内完成更多推理的问题,并发控制解决多个请求同时到达时如何安全共享算力的问题。本课将实现一个只加载一次模型的动态批处理器,让并发请求先进入有界队列,再由单一 GPU 工作线程合并推理并返回各自结果。
学习目标
- 区分离线批量、在线并发和实时流处理
- 使用任务队列与短等待窗口动态组批
- 通过单模型工作线程避免重复加载和显存争用
先区分三种请求形态
离线图片目录更关注总吞吐量,可以一次提交多张图片并使用较大的批次。在线接口更关注单请求延迟,需要在很短的等待窗口内合并同时到达的请求。实时视频则还要决定是否允许丢帧,通常使用流式结果并限制缓存长度。
批量不等于并发。批量描述一次模型调用中包含多少个输入,并发描述同时有多少调用者提交任务。若每个请求线程都创建模型或直接访问同一模型,可能造成重复加载、线程安全问题和同一块 GPU 上的显存竞争。
设计单模型动态组批链路
稳妥的单 GPU 结构是“并发生产、串行推理”:接口线程只负责提交任务,模型只由一个推理线程访问。有界队列限制等待任务数量,短暂组批窗口在吞吐量和延迟之间取平衡,Future 则把批量结果准确返回给原请求。
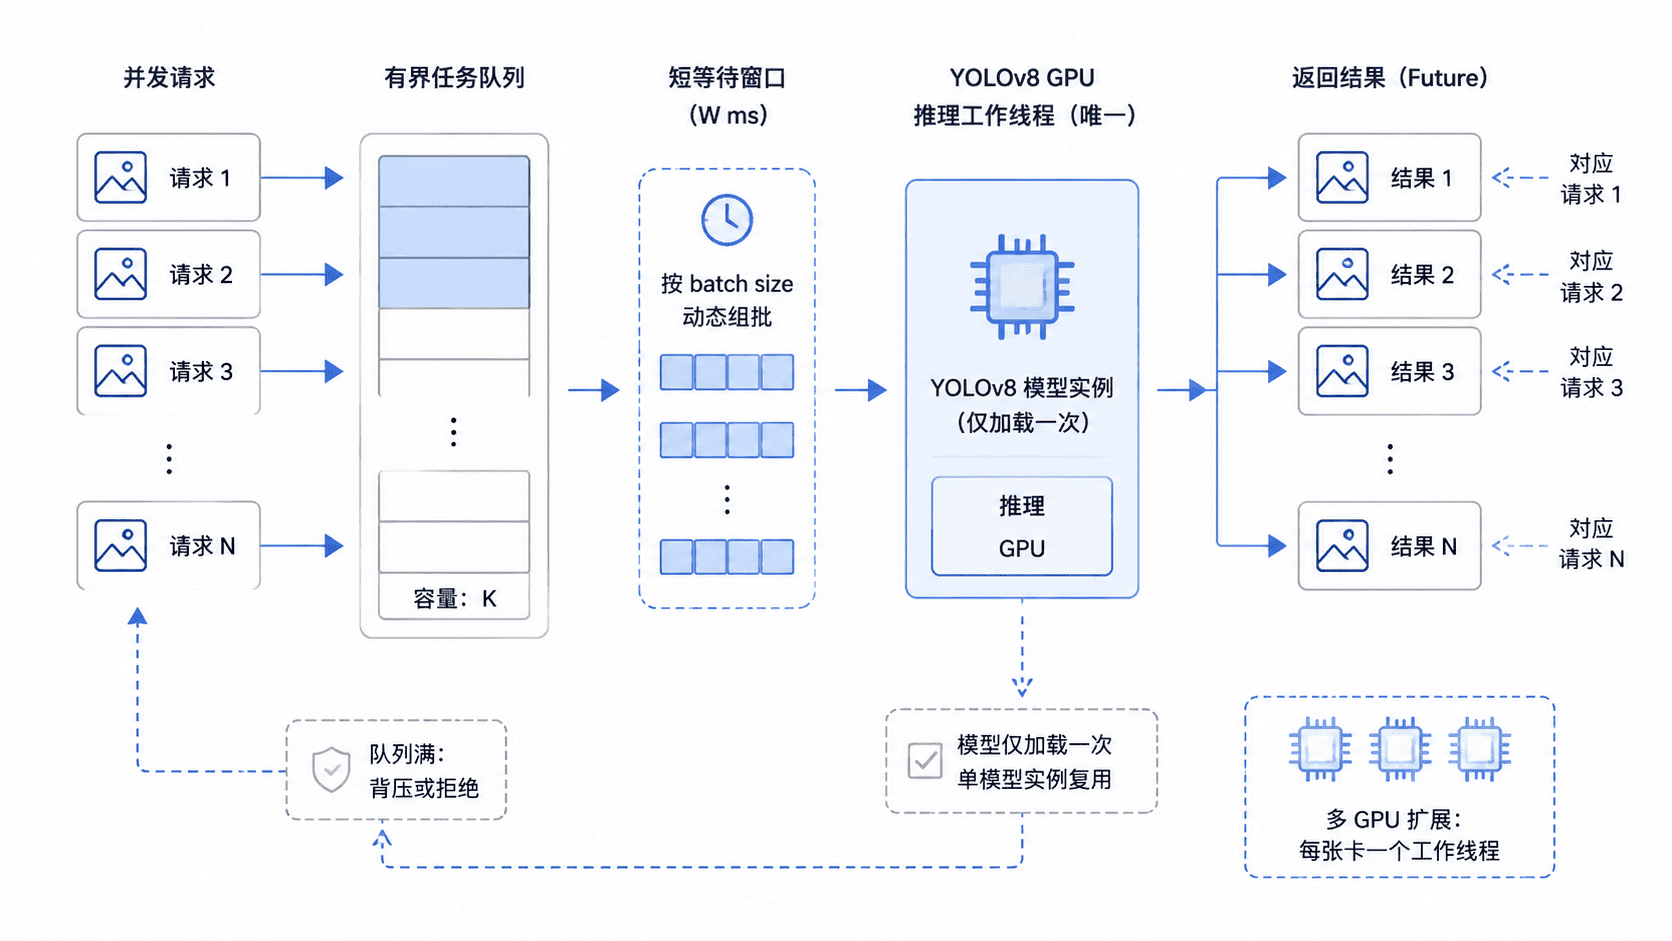
这一结构不会让多个线程同时调用同一模型。若部署多张 GPU,应为每张卡建立独立的模型实例和工作队列,再由上层路由任务;不要简单增加同卡工作线程数量,否则吞吐量可能没有提升,显存和上下文切换成本却会上升。
实现有界队列与动态组批
下面的完整程序使用多个生产线程模拟并发请求。所有请求进入一个有界队列,工作线程最多等待 20 毫秒收集任务,达到 batch_size 后立即调用一次 model.predict()。
import argparse
import time
from concurrent.futures import Future, ThreadPoolExecutor
from dataclasses import dataclass
from pathlib import Path
from queue import Empty, Full, Queue
from threading import Thread

from ultralytics import YOLO

@dataclass
class Job:
    source: str
    future: Future

class BatchPredictor:
    def __init__(
        self,
        weights: str,
        device: str,
        batch_size: int = 4,
        max_wait_ms: int = 20,
        queue_size: int = 64,
    ) -> None:
        self.model = YOLO(weights)
        self.device = device
        self.batch_size = batch_size
        self.max_wait_seconds = max_wait_ms / 1000
        self.jobs = Queue(maxsize=queue_size)
        self.worker = Thread(target=self._run, daemon=True)
        self.worker.start()
        print("model_loaded_once=true")

    def submit(self, source: str) -> Future:
        future = Future()
        try:
            # 有界队列形成背压,避免突发请求无限占用内存。
            self.jobs.put(Job(source, future), timeout=1)
        except Full:
            future.set_exception(RuntimeError("request queue is full"))
        return future

    def close(self) -> None:
        self.jobs.put(None)
        self.worker.join()

    def _run(self) -> None:
        batch_id = 0
        while True:
            first = self.jobs.get()
            if first is None:
                return

            batch = [first]
            deadline = time.monotonic() + self.max_wait_seconds
            stop_after_batch = False

            # 在短等待窗口内合并请求,达到上限后立即推理。
            while len(batch) < self.batch_size:
                remaining = deadline - time.monotonic()
                if remaining <= 0:
                    break
                try:
                    item = self.jobs.get(timeout=remaining)
                except Empty:
                    break
                if item is None:
                    stop_after_batch = True
                    break
                batch.append(item)

            batch_id += 1
            print(f"batch={batch_id} size={len(batch)}")
            try:
                results = self.model.predict(
                    source=[job.source for job in batch],
                    device=self.device,
                    imgsz=640,
                    conf=0.25,
                    verbose=False,
                )
                for job, result in zip(batch, results):
                    job.future.set_result(
                        {
                            "source": str(result.path),
                            "detections": len(result.boxes),
                        }
                    )
            except Exception as exc:
                for job in batch:
                    job.future.set_exception(exc)

            if stop_after_batch:
                return

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--weights", required=True)
    parser.add_argument("--sources", nargs="+", required=True)
    parser.add_argument("--device", default="cuda:0")
    parser.add_argument("--batch-size", type=int, default=4)
    parser.add_argument("--producers", type=int, default=8)
    args = parser.parse_args()

    if not Path(args.weights).is_file():
        raise SystemExit("权重路径不存在。")
    missing = [source for source in args.sources if not Path(source).is_file()]
    if missing:
        raise SystemExit(f"图片路径不存在:{missing}")

    predictor = BatchPredictor(
        weights=args.weights,
        device=args.device,
        batch_size=args.batch_size,
    )

    def request(source: str) -> dict:
        return predictor.submit(source).result(timeout=120)

    try:
        # 生产线程模拟并发请求,模型只由单一推理线程访问。
        with ThreadPoolExecutor(max_workers=args.producers) as pool:
            futures = [pool.submit(request, source) for source in args.sources]
            results = [future.result() for future in futures]
    finally:
        predictor.close()

    for result in results:
        print(
            f"result source={result['source']} "
            f"detections={result['detections']}"
        )
    print(f"completed={len(results)}")

if __name__ == "__main__":
    main()
预期结果:模型只加载一次,并发提交的图片被组合成一个或多个批次,每个输入最终都得到独立检测结果。保存为 batch_predictor.py 后执行:
python batch_predictor.py --weights "<PATH>/best.pt" --sources "<PATH>/a.jpg" "<PATH>/b.jpg" "<PATH>/c.jpg" "<PATH>/d.jpg" --batch-size 4 --producers 8预期输出中的批次数量、每批大小和检测数量会随请求到达时间与图片内容变化:
model_loaded_once=true
batch=<ID> size=<BATCH_SIZE>
result source=<PATH> detections=<N>
result source=<PATH> detections=<N>
completed=<N>
调整吞吐量与延迟
batch_size 越大,GPU 通常越容易被充分利用,但单个请求等待组批和执行的时间也会增加。在线接口可以从 2、4、8 逐级测试;max_wait_ms 可从 10~30 毫秒起步,再根据延迟目标和请求密度调整。
queue_size 用来建立背压。队列满时应快速返回“系统繁忙”或进入上游限流,而不是继续堆积内存。不同尺寸图片混在同一批次时可能产生更多填充,离线任务可按相近分辨率分组,以减少无效计算。
对于长视频或摄像头,应使用 stream=True 逐帧消费结果,避免一次保存全部结果。强调低延迟时可保持 stream_buffer=False,让处理速度跟不上输入帧率时丢弃旧帧;必须逐帧留存的离线任务则应使用持久化队列,而不是无限扩大内存缓存。
验收并发处理是否有效
运行测试时应确认日志中的 model_loaded_once=true 只出现一次,输入数量与 completed 一致,并在持续并发下观察 GPU 显存是否稳定。随后分别记录单请求延迟、P95 延迟、每秒处理图片数和队列拒绝数,避免只看平均吞吐量。
若增加生产线程后吞吐量不再提升,瓶颈通常已经转移到 GPU、图片解码或磁盘读取。此时继续增加线程只会拉高等待时间,应改为调整批次、并行预处理、缓存输入,或为新增 GPU 建立独立工作实例。