
计算机视觉 / 系统课时
排查摄像头与模型问题
排查摄像头与模型问题
这类故障最容易被“模型坏了”或“摄像头坏了”混在一起判断。正确做法是把链路拆成设备打开、帧读取、模型加载、推理输出四层,并为每层留下可复现的检查结果,最终能明确问题发生在哪一层。
学习目标
- 按固定顺序区分摄像头、帧读取、模型文件和输出解析故障。
- 使用 OpenCV 4.x 的真实 API 打印设备、模型和输出维度诊断信息。
- 根据错误现象选择修复动作,并用同一组检查重新验证。
先把故障切成四层
排查顺序固定为“设备能否打开 → 能否连续读帧 → 模型能否加载 → 输出形状是否符合解析器假设”。不要一开始就改阈值或重装 OpenCV,因为设备层失败时,后面的模型修改不会产生任何有效信息。
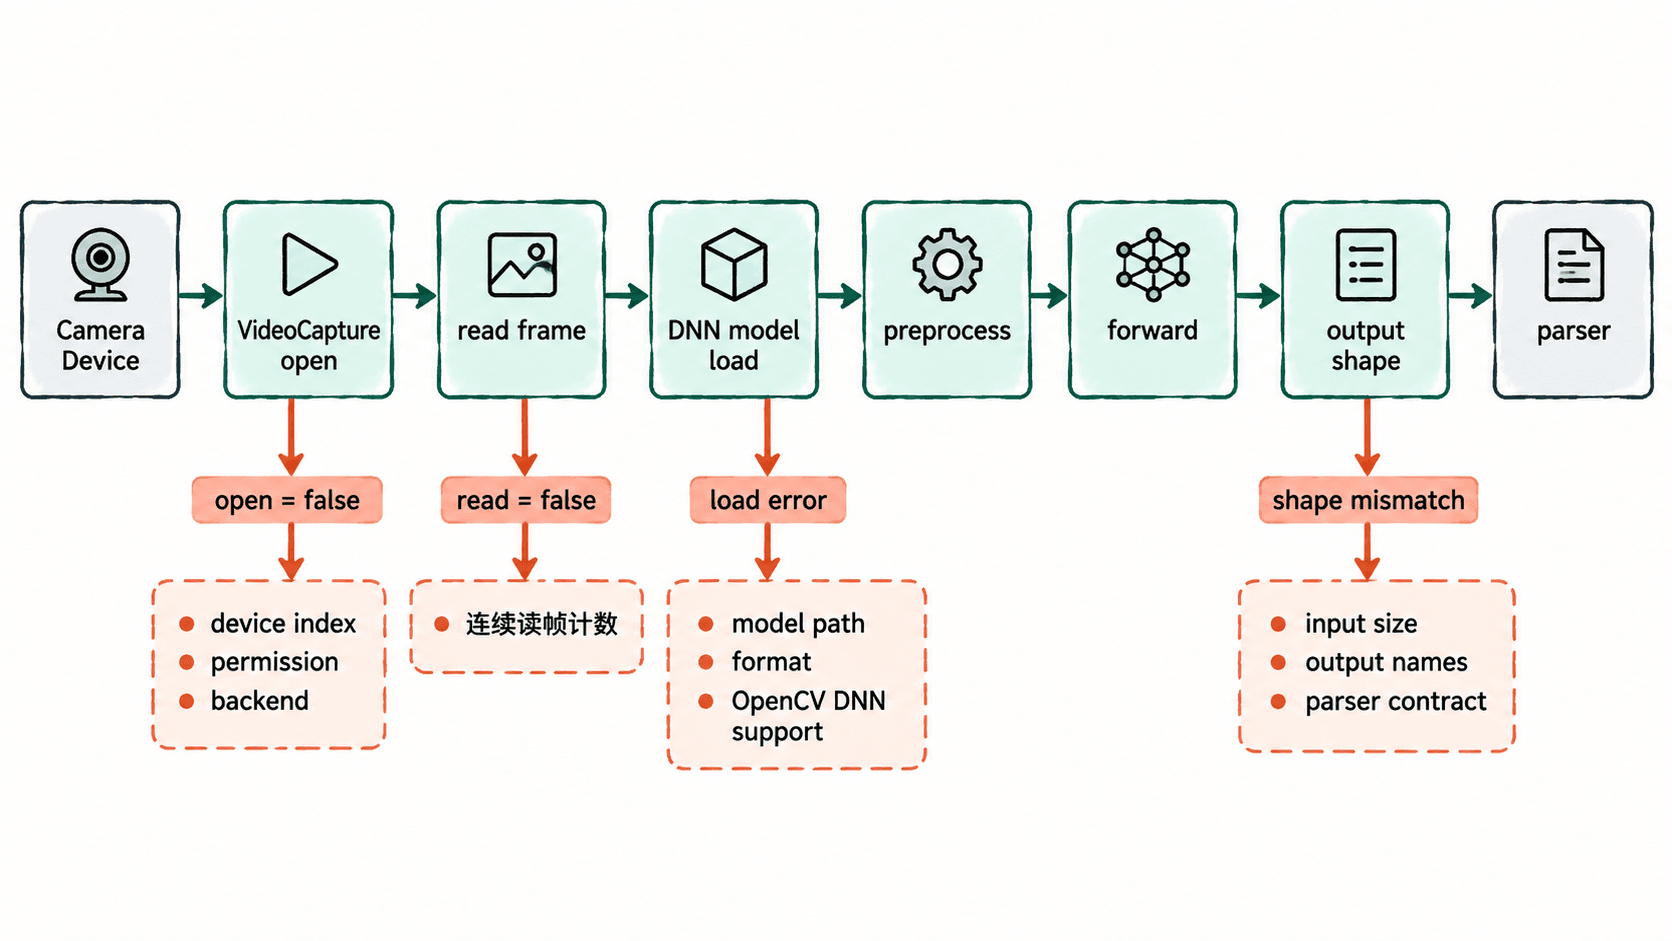
实际记录时至少保留四个字段:OpenCV 版本、视频后端、首帧尺寸、模型输出名与 shape。这样同一个问题换到另一台机器时,可以直接比较环境差异,而不是只留下“打不开”这种无法复现的描述。
先证明摄像头能打开并持续读帧
下面脚本适用于 OpenCV 4.x。它先检查 isOpened(),再连续读取 30 帧;只有 30 帧都成功,才把“设备已打开”视为基本成立。请求的分辨率和 FPS 只是协商值,所以还要用 get() 读取设备最终接受的实际值。
import cv2

cap = cv2.VideoCapture(0, cv2.CAP_ANY)
print(f"opencv={cv2.__version__}")
print(f"opened={cap.isOpened()}")

if not cap.isOpened():
    raise SystemExit("camera open failed")

print(f"backend={cap.getBackendName()}")

ok_count = 0
last_frame = None
for _ in range(30):
    ok, frame = cap.read()
    if not ok or frame is None:
        break
    ok_count += 1
    last_frame = frame

width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))
height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
fps = cap.get(cv2.CAP_PROP_FPS)
cap.release()

print(f"frames_ok={ok_count}/30")
print(f"actual={width}x{height}@{fps:.2f}")
if last_frame is not None:
    print(f"shape={last_frame.shape}")
预期输出
opencv=<VERSION>
opened=True
backend=<BACKEND>
frames_ok=30/30
actual=<WIDTH>x<HEIGHT>@<FPS>
shape=(<HEIGHT>, <WIDTH>, 3)
如果 opened=False,先换设备索引 0、1、2 逐个测试,再检查系统相机权限和是否被会议软件独占。Windows 可在必要时显式尝试 cv2.CAP_DSHOW 或 cv2.CAP_MSMF,Linux 常见后端是 cv2.CAP_V4L2;这些常量都是真实的 OpenCV Video I/O 后端选择,不应在同一次测试里混用多个后端。
若 opened=True 但 frames_ok 很低,问题更可能在驱动、USB 带宽、分辨率协商或设备断流。此时先降到 640×480、30 FPS,再连续读 300 帧;若成功率仍低于 99%,应先解决采集链路,而不是继续排查模型。
把模型加载和推理分开验证
对 ONNX 模型,先只验证文件存在且 readNetFromONNX() 能创建网络,再做一次前向推理。下面脚本需要一个真实 ONNX 文件和一张测试图片;--width、--height 必须填写为模型导出时的输入尺寸,示例默认 640×640。
from pathlib import Path
import argparse
import cv2

parser = argparse.ArgumentParser()
parser.add_argument("--model", required=True)
parser.add_argument("--image", required=True)
parser.add_argument("--width", type=int, default=640)
parser.add_argument("--height", type=int, default=640)
args = parser.parse_args()

model_path = Path(args.model)
image_path = Path(args.image)

if not model_path.is_file():
    raise SystemExit(f"model not found: {model_path}")
if not image_path.is_file():
    raise SystemExit(f"image not found: {image_path}")

net = cv2.dnn.readNetFromONNX(str(model_path))
image = cv2.imread(str(image_path))
if image is None:
    raise SystemExit("image decode failed")

blob = cv2.dnn.blobFromImage(
    image,
    scalefactor=1.0 / 255.0,
    size=(args.width, args.height),
    swapRB=True,
    crop=False,
)
net.setInput(blob)

names = net.getUnconnectedOutLayersNames()
outputs = net.forward(names)

print(f"outputs={len(outputs)}")
for name, output in zip(names, outputs):
    print(f"{name}: shape={output.shape} dtype={output.dtype}")
预期输出
outputs=<N>
<OUTPUT_NAME>: shape=<OUTPUT_SHAPE> dtype=float32
如果加载阶段就抛出 cv2.error,先确认路径、文件大小和格式是否与调用匹配;ONNX 用 readNetFromONNX(),不要把其他格式文件改扩展名后强行读取。若错误指向 unsupported layer、node 或 importer,问题通常是模型导出算子与当前 OpenCV DNN 支持范围不兼容,需要重新导出更兼容的 ONNX,或改用该模型官方推荐的推理运行时。
输出维度异常时先检查契约
“输出维度异常”不等于模型损坏。不同检测模型可能输出单个张量,也可能输出多个张量;同为目标检测,SSD 风格常见最后一维包含 7 个字段,而不同 YOLO 导出版本的维度布局和字段数量也可能不同。因此解析器必须以实际 getUnconnectedOutLayersNames() 和 forward() 结果为准。
最小检查顺序是:先确认输入 blob.shape,再打印每个输出张量的 shape,最后才进入框坐标、类别和置信度解析。若模型声明输入为 640×640,而代码实际传入 224×224,即使 forward() 能执行,输出的网格数量也可能与解析器预期完全不同。
用同一张故障表完成修复和复测
| 现象 | 优先检查 | 修复动作 | 复测标准 |
|---|---|---|---|
isOpened() 为 False |
索引、权限、占用、后端 | 更换正确索引,关闭占用程序,必要时固定平台后端 | 连续 30 帧全部读取成功 |
打开成功但频繁 read() 失败 |
分辨率、FPS、USB/驱动 | 降到 640×480@30,换接口或更新驱动 | 300 帧成功率至少 99% |
readNetFromONNX() 抛异常 |
路径、文件、算子支持 | 校验模型文件,重新导出兼容 ONNX | 网络可创建且能执行一次 forward() |
forward() 成功但 shape 不符 |
输入尺寸、输出名、解析器假设 | 按实际输出名和 shape 修改解析逻辑 | 测试图上输出数量、字段和坐标范围均合理 |
复测时必须使用与修复前相同的脚本和同一张测试图片,否则无法判断变化来自修复还是测试条件变化。交付故障记录至少保存“复现命令、OpenCV 版本、设备后端、输入尺寸、输出 shape、最终修复动作”六项,这些信息足以让另一台机器继续定位。