
计算机视觉 / 系统课时
理解目标检测任务
理解目标检测任务
面对一张图像,“识别里面是什么”和“找出每个目标在哪里”是不同任务。理解分类、定位、检测与实例分割的输出差异后,你就能根据业务需要选择模型,并正确解读后续 OpenCV DNN 得到的类别、边界框和置信度。
学习目标
- 根据模型输出区分图像分类、目标定位、目标检测和实例分割
- 看懂目标检测常见的类别、边界框与置信度结果
- 根据数量统计、位置获取和像素级轮廓等需求选择合适任务
四类视觉任务输出什么
假设输入是一张 1280×720 的街景,其中有 3 辆汽车和 2 名行人。四类任务使用同一幅图像,但交付结果完全不同。
| 任务 | 典型输出 | 对这张街景的结果 |
|---|---|---|
| 图像分类 | 整张图一个或多个类别 | street 或 traffic scene |
| 目标定位 | 一个主要目标的类别与位置 | car 加一个边界框 |
| 目标检测 | 多个目标的类别、分数与边界框 | 3 个 car 框和 2 个 person 框 |
| 实例分割 | 每个实例的类别与像素掩膜 | 5 个目标各自独立的 mask |
目标定位通常假设图中只有一个主要目标;目标检测允许同类别出现多次;实例分割则进一步回答目标实际占据了哪些像素,而不只是给出矩形范围。
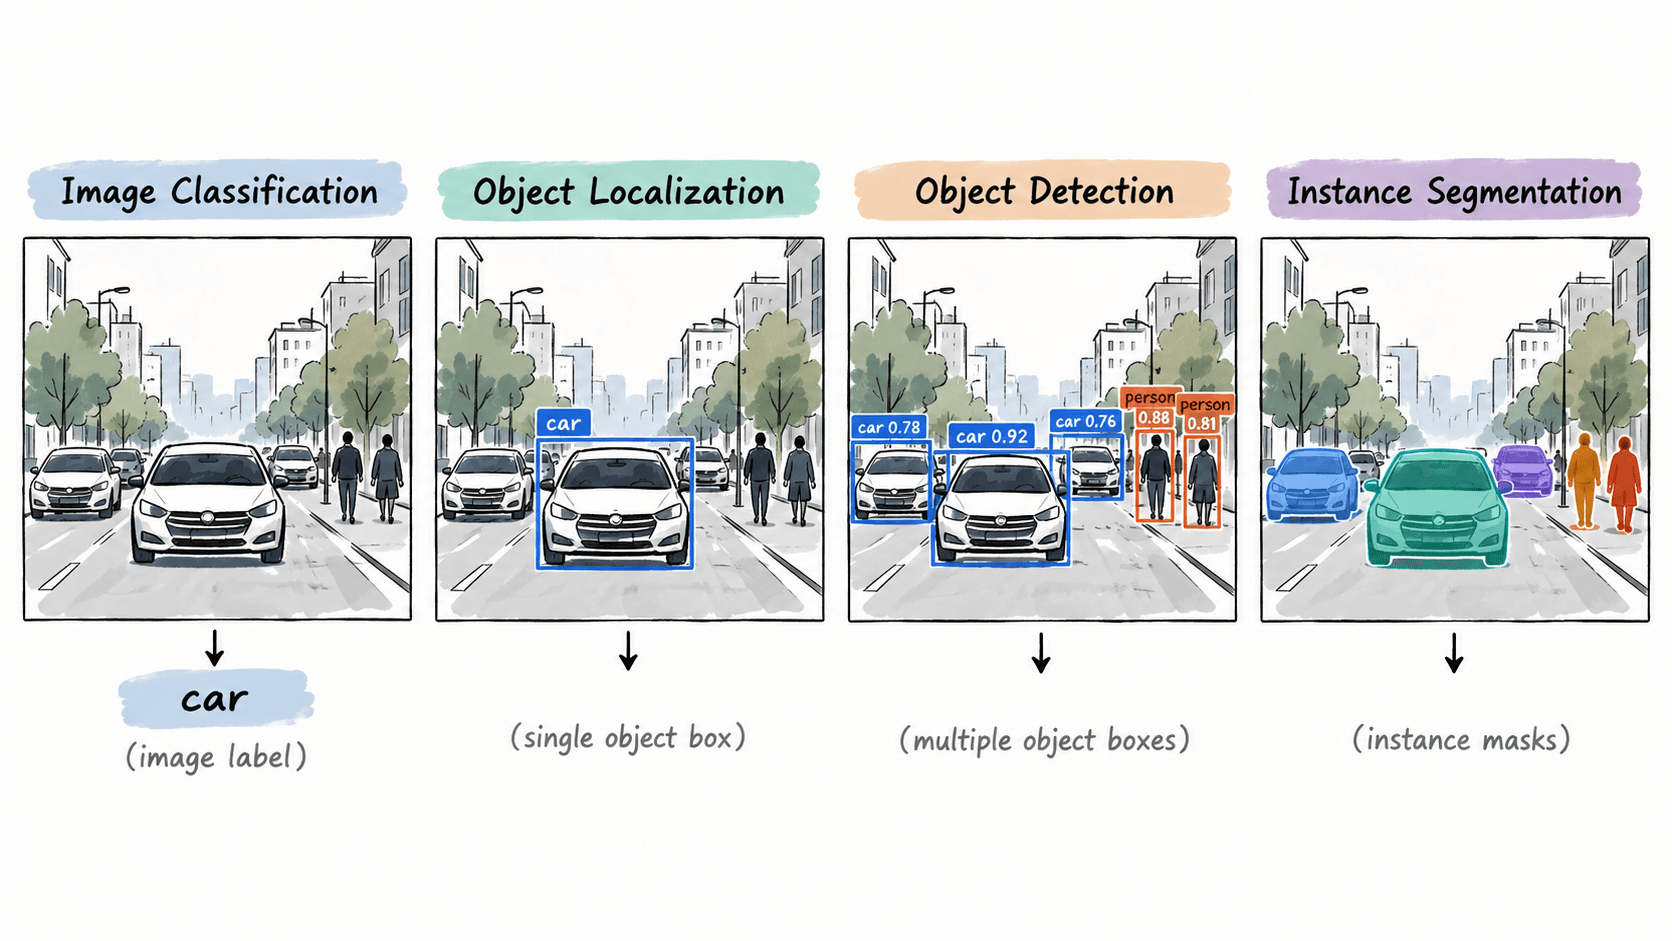
看懂检测框与置信度
目标检测至少要回答“是什么、在哪里、模型有多确定”。常见结果可表示为类别 person、置信度 0.87 和矩形坐标 (x1, y1, x2, y2)。例如 (120, 80, 420, 360) 表示左上角为 (120,80)、右下角为 (420,360),框宽 300 像素、高 280 像素。
不同模型的框格式并不统一。有的输出 (x1,y1,x2,y2),有的输出中心点与宽高 (cx,cy,w,h),还有模型输出 0~1 的归一化坐标。接入模型时必须先查看其输入输出定义,不能直接假设第四个数就是右下角坐标。
置信度阈值决定哪些候选框继续保留。教学测试可先从 0.5 开始:低于 0.5 的候选先过滤,再观察漏检和误检情况。阈值升到 0.7 往往会减少低质量框,但也可能把较难目标一起删掉,因此应使用实际样本调整,而不是固定套用一个值。
按产品需求选择任务
选择任务时先写清最终需要的数据,而不是先决定使用哪个模型。下面几种需求可以直接对应到任务类型。
- 只判断照片是不是猫:使用图像分类,不需要边界框。
- 每张商品图只有一个商品,还要自动裁剪主体:使用目标定位即可。
- 统计货架上有多少瓶饮料,并获取每瓶位置:使用目标检测。
- 测量显微图中相互重叠细胞各自的面积:使用实例分割,因为矩形框无法准确表示轮廓。
例如仓库盘点要求输出“纸箱数量”和“每个纸箱中心位置”,目标检测已经能够提供这些信息;改成实例分割会增加标注与推理成本,却不一定增加业务价值。反过来,如果要计算每块缺陷实际覆盖的像素面积,单纯检测框又不够精确。
检查检测结果是否可用
最直接的检查不是只看置信度,而是同时核对类别和位置。教学阶段可以准备 20~50 张人工确认过的测试图,逐张记录漏检、误检和框偏移,再决定是否需要换模型或调整阈值。
框的位置常用 IoU 判断重合程度。假设预测框和人工框面积都为 10000 像素,二者交集为 8000 像素,则并集为 10000 + 10000 - 8000 = 12000,IoU 为 8000 / 12000 ≈ 0.67。教学验收可先把 IoU 不低于 0.5 作为简单匹配规则;正式数据集应以该数据集规定的评测协议为准。
一个检测系统即使“类别基本正确”,若经常把框画到相邻目标上,也无法用于裁剪、跟踪或空间测量。因此后续使用 OpenCV DNN 时,应把类别、置信度和边界框作为一组结果共同验证。