
计算机视觉 / 系统课时
优化视频处理性能
优化视频处理性能
视频处理变慢时,最有效的顺序通常不是先上多线程,而是先确认瓶颈,再减少像素与重复计算,最后把采集和处理解耦。本节给出一套可直接运行的 OpenCV 方案:降到 960×540、只保留必要处理,并使用“只保留最新帧”的读取线程控制延迟。
学习目标
- 用分辨率、处理频率和单帧耗时判断主要性能成本。
- 通过缩小画面与合并重复操作减少每帧计算量。
- 用独立读取线程和最新帧策略降低实时视频积压延迟。
先量出最值得优化的部分
先固定输入和算法,再测每个阶段耗时。1920×1080 一帧约有 207 万像素,960×540 只有约 52 万像素,是前者的 25%。对卷积、边缘检测和多数逐像素操作,像素数下降通常会显著降低耗时,但实际加速不会严格等于 4 倍,因为读取、拷贝和显示仍有固定成本。
以 30 FPS 为目标时,总预算只有约 33.3 ms。若测得读取 4 ms、缩放 2 ms、算法 38 ms、显示 3 ms,端到端约 47 ms,瓶颈显然在算法而不是读取线程。此时先降低处理分辨率或减少算法调用次数,比直接增加线程更有效。
降低每帧计算量
优先做三类低风险改动:把处理分辨率从 1920×1080 降到 960×540;同一帧只执行一次 cv2.cvtColor,后续步骤复用灰度图;只在真正需要的区域运行检测。例如目标只会出现在画面中央 60% 区域,就先裁 ROI,再做 Canny 或检测。
如果某个检测器单次耗时 40 ms,而业务允许结果以 15 Hz 更新,可以每 2 帧运行一次检测,并在中间帧复用上次结果。这样检测的平均计算负担约变成每显示帧 20 ms,但要明确:显示仍可保持接近 30 FPS,检测结果本身只有约 15 次/秒。
分离读取与处理
串行循环中,cap.read()、算法和显示依次执行;当算法变慢时,摄像头或后端缓冲区可能积累旧帧,用户看到的是“流畅但越来越延迟”的画面。实时交互更常用“读取线程持续更新最新帧,处理线程只拿最新可用帧”的策略。
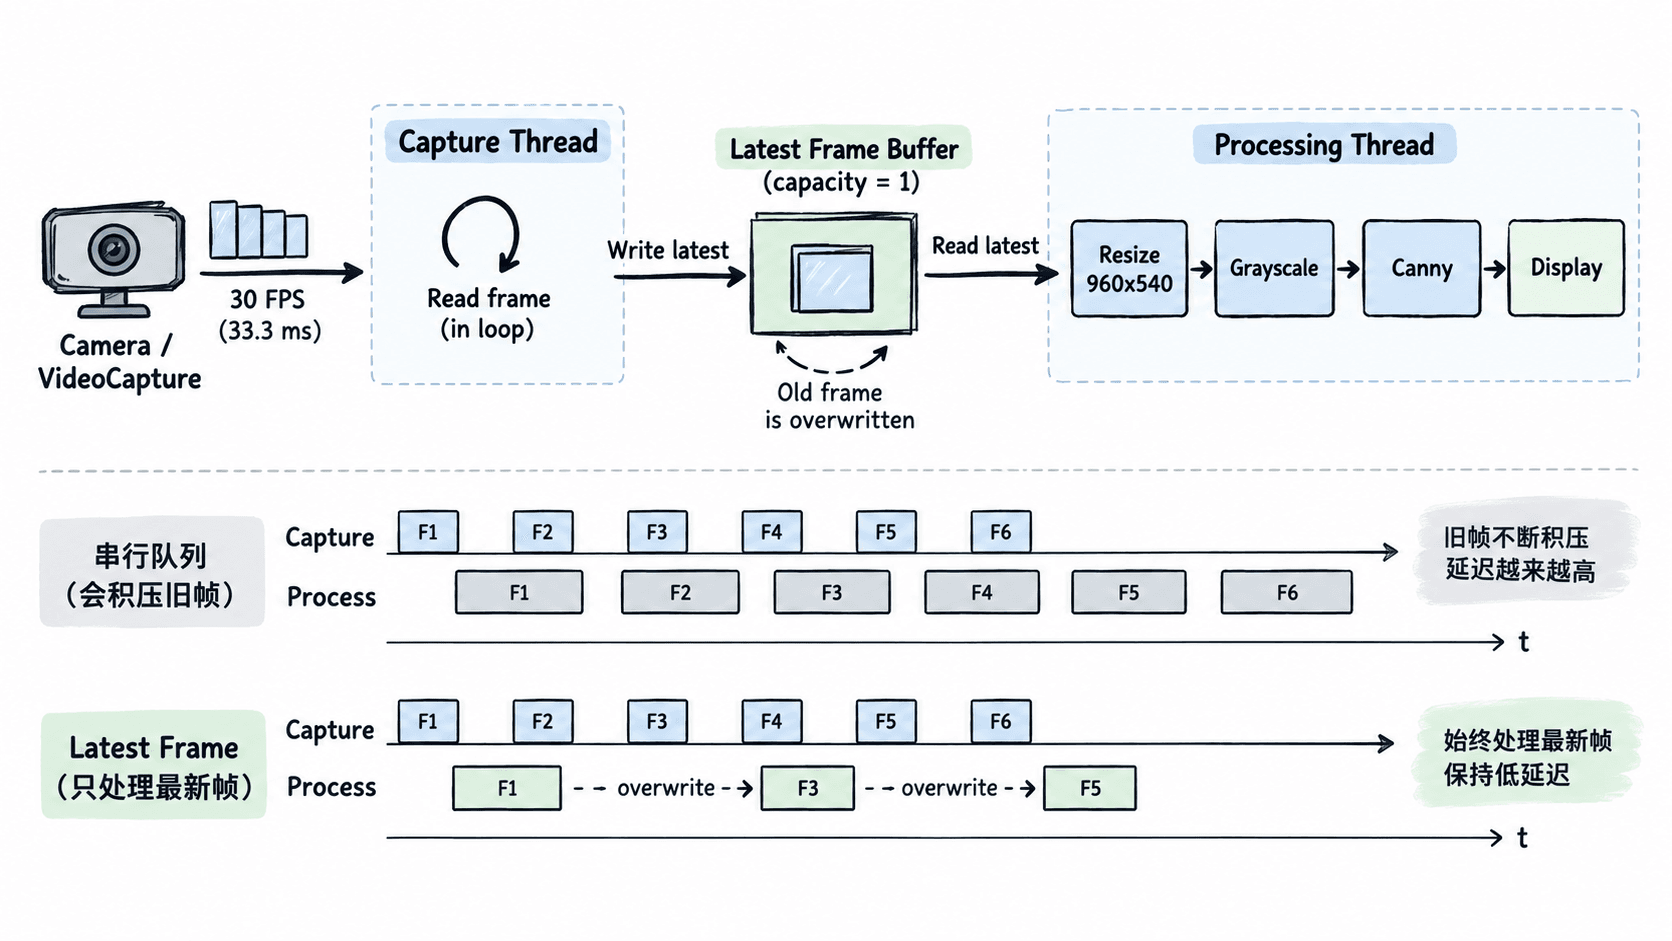
下面示例适用于 OpenCV 4.x 与常见 USB 摄像头。读取线程只保存最新一帧;主线程把帧缩到 960×540,再执行灰度化和 Canny。若处理暂时跟不上,旧帧会被覆盖,不会无限排队。
import threading
import time
import cv2

class LatestFrameCapture:
    def __init__(self, source=0):
        self.cap = cv2.VideoCapture(source)
        if not self.cap.isOpened():
            raise RuntimeError("无法打开视频源")
        self.lock = threading.Lock()
        self.frame = None
        self.seq = 0
        self.running = True
        self.thread = threading.Thread(target=self._reader, daemon=True)
        self.thread.start()

    def _reader(self):
        while self.running:
            ok, frame = self.cap.read()
            if not ok:
                self.running = False
                break
            # 只保留最新帧;seq 用来防止主线程重复处理同一帧。
            with self.lock:
                self.frame = frame
                self.seq += 1

    def read_latest(self, last_seq):
        with self.lock:
            if self.frame is None or self.seq == last_seq:
                return last_seq, None
            return self.seq, self.frame.copy()

    def close(self):
        self.running = False
        self.cap.release()
        self.thread.join(timeout=1.0)

capture = LatestFrameCapture(0)
last_seq = -1
frames = 0
start = time.perf_counter()

try:
    while True:
        last_seq, frame = capture.read_latest(last_seq)
        if frame is None:
            time.sleep(0.001)
            continue

        # 先缩小再执行逐像素算法,避免在 1080p 等大画面上浪费计算。
        small = cv2.resize(frame, (960, 540), interpolation=cv2.INTER_AREA)
        gray = cv2.cvtColor(small, cv2.COLOR_BGR2GRAY)
        edges = cv2.Canny(gray, 100, 200)

        # 每约 2 秒打印一次处理吞吐,避免逐帧输出拖慢主循环。
        frames += 1
        elapsed = time.perf_counter() - start
        if elapsed >= 2.0:
            print(f"Processing FPS: {frames / elapsed:.1f}")
            frames = 0
            start = time.perf_counter()

        cv2.imshow("optimized", edges)
        if cv2.waitKey(1) & 0xFF == 27:
            break
finally:
    capture.close()
    cv2.destroyAllWindows()
预期输出
Processing FPS: <FPS>
Processing FPS: <FPS>
实际 <FPS> 取决于摄像头、CPU 和驱动。验收时同时观察窗口延迟:快速左右移动摄像头时,画面应尽量跟手;如果 FPS 看起来很高但画面明显落后几秒,说明后端仍在缓存旧帧,需要检查采集后端或设备驱动行为。
用丢帧策略守住实时性
离线转码的目标是“每帧都处理”;实时预览的目标通常是“尽量处理最新帧”。这两个目标不能混用。容量为 1 的最新帧缓冲会主动丢弃处理不过来的旧帧,牺牲完整性换取低延迟,适合摄像头预览、机器人视觉和交互检测,不适合必须逐帧保存证据的视频分析。
如果业务要求绝不丢帧,应改用有界队列并监控队列长度,同时接受延迟可能增长。以 30 FPS 输入、算法只能处理 20 FPS 为例,每秒净积压约 10 帧;10 秒后就会落后约 100 帧,也就是约 3.3 秒。这个数学关系比“再加一个线程试试”更能判断方案是否可行。
验收优化是否有效
优化前后必须在同一视频源、同一分辨率、同一算法输出要求下对比。至少记录处理 FPS、端到端延迟和 CPU 占用;若把分辨率降低了,也要确认目标仍有足够像素用于后续检测。性能提升如果以识别准确率明显下降为代价,就不能算有效优化。
一个实用验收线是:30 FPS 目标下,连续运行 2~5 分钟,平均处理时间稳定低于 33.3 ms,且没有持续增长的帧队列;交互场景再补一项“画面延迟不随运行时间累积”。满足这些条件后,再考虑更重的方向,例如调整 OpenCV 构建、启用硬件编解码或把模型推理迁移到 GPU。