
计算机视觉 / 系统课时
使用 KNN 匹配
使用 KNN 匹配
KNN 匹配不会只给每个描述子一个答案,而是保留前几个最近候选。最常用的做法是令 k=2,比较第一名与第二名的距离,再用比例测试删除“两个候选几乎一样好”的模糊匹配,从而比单纯取最近邻更适合后续配准。
学习目标
- 使用
BFMatcher.knnMatch(..., k=2)为每个查询描述子取得两个候选。 - 用 的比例测试筛掉区分度不足的匹配。
- 根据描述子类型、重复纹理和后续几何验证调整比例阈值。
KNN 为什么要保留两个候选
设最近候选距离为 ,第二近候选为 。如果第一名明显优于第二名,例如 ,这条匹配具有较强区分度;如果两者接近,例如 ,说明查询描述子在训练图中有多个相似位置,容易出现在窗格、砖墙和重复文字中。
比例测试常从 0.75 开始:满足 才保留。阈值越小越严格,0.65 会丢掉更多边界匹配;阈值越大越宽松,0.80 会留下更多候选,也会增加误匹配。它衡量的是“最近邻相对第二近邻是否足够突出”,不是绝对距离是否足够小。
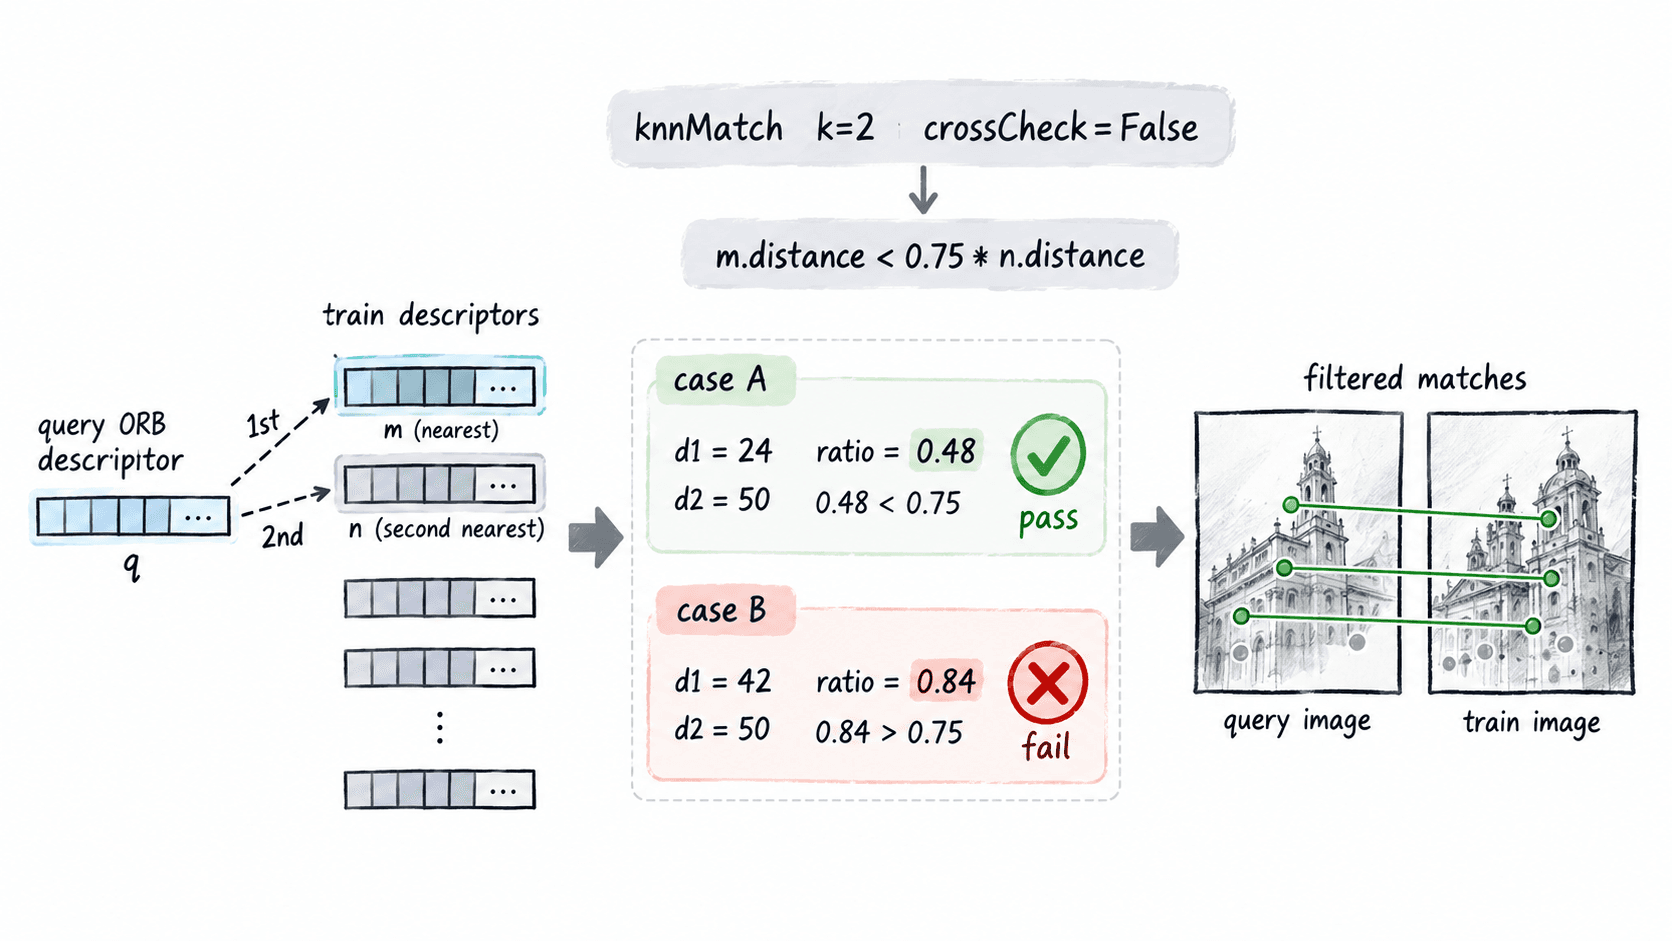
完整执行 KNN 与比例测试
以下示例适用于 OpenCV 4.x Python API,并继续使用 ORB,因此匹配距离必须是 cv.NORM_HAMMING。crossCheck 保持默认 False,否则就失去了为同一查询描述子保留多个候选再做比例判断的意义。
import cv2 as cv
import numpy as np

def make_pair():
    img1 = np.zeros((360, 520), dtype=np.uint8)
    for y in range(60, 301, 80):
        for x in range(60, 461, 100):
            cv.circle(img1, (x, y), 18, 255, 2)
            cv.rectangle(img1, (x - 12, y - 12), (x + 12, y + 12), 180, 1)
    cv.putText(img1, "KNN", (160, 190), cv.FONT_HERSHEY_SIMPLEX, 1.4, 255, 3, cv.LINE_AA)
    matrix = cv.getRotationMatrix2D((260, 180), -6.0, 1.0)
    matrix[:, 2] += (22, 10)
    img2 = cv.warpAffine(img1, matrix, (520, 360))
    return img1, img2

img1, img2 = make_pair()
orb = cv.ORB_create(nfeatures=800)
kp1, des1 = orb.detectAndCompute(img1, None)
kp2, des2 = orb.detectAndCompute(img2, None)

if des1 is None or des2 is None or len(des2) < 2:
    raise RuntimeError("描述子数量不足,无法执行 k=2 匹配")

matcher = cv.BFMatcher(cv.NORM_HAMMING)
knn_matches = matcher.knnMatch(des1, des2, k=2)

ratio = 0.75
good = []
for pair in knn_matches:
    if len(pair) < 2:
        continue
    m, n = pair
    if m.distance < ratio * n.distance:
        good.append(m)

visual = cv.drawMatches(
    img1, kp1, img2, kp2, good[:30], None,
    flags=cv.DrawMatchesFlags_NOT_DRAW_SINGLE_POINTS
)
saved = cv.imwrite("knn_ratio_matches.png", visual)

print("k:", 2)
print("ratio_threshold:", ratio)
print("candidate_pairs_complete:", all(len(pair) == 2 for pair in knn_matches))
print("good_not_more_than_queries:", len(good) <= len(knn_matches))
print("visual_saved:", saved)
预期输出
k: 2
ratio_threshold: 0.75
candidate_pairs_complete: True
good_not_more_than_queries: True
visual_saved: True
关键点数量与最终通过比例测试的匹配数量可能随 OpenCV 4.x 小版本略有变化,所以示例只验证稳定条件。打开 knn_ratio_matches.png 时,应看到保留连线明显少于未经筛选的 KNN 候选,并且多数连到相同图案位置。
比例阈值怎样调
比例阈值没有统一最优值,但可以按误匹配风险建立可检查的起点。一般自然场景可先用 0.75;纹理高度重复时先收紧到 0.65~0.70;如果图像有较大的尺度、模糊或光照差异,0.80 可以保留更多候选,但必须把更多工作交给后续 RANSAC。
| 场景 | 起始比例阈值 | 观察重点 |
|---|---|---|
| 普通物体、纹理较丰富 | 0.75 | 连线是否分散覆盖目标 |
| 栅栏、窗格、重复图案 | 0.65~0.70 | 是否仍出现成束的平行误连线 |
| 模糊、尺度变化较大 | 0.80 | 候选变多后几何内点率是否下降 |
不要把比例测试与“绝对距离足够小”等价。d1=10,d2=12 的最近邻虽然绝对距离低,但比例约为 0.83,仍说明两个候选难以区分;而 d1=40,d2=80 的比例为 0.50,区分度反而更强。
进入几何验证前的边界检查
KNN 结果中的每个元素理论上最多有 k 个候选,因此实际代码应像示例一样检查 len(pair) < 2,不要直接假设所有查询描述子都有两个结果。若改用 SIFT,匹配器应改为 cv.NORM_L2;若仍用 ORB 默认参数,则保持 cv.NORM_HAMMING。
比例测试只是描述子层面的过滤。若下一步要用 cv.findHomography 做平面配准,至少需要 4 对非共线对应点,工程上通常应保留更多分散匹配,并用 cv.RANSAC 与约 3 像素的重投影阈值检查几何内点。这样可以把“描述子看起来相似”进一步收敛为“空间位置也一致”。