
计算机视觉 / 系统课时
使用 RANSAC 过滤匹配
使用 RANSAC 过滤匹配
特征匹配里常会混入错误对应点,直接用全部匹配估计单应性矩阵会让模型被离群点拉偏。本课用 cv2.findHomography 的 RANSAC 模式估计模型,并利用返回的掩膜只保留几何一致的内点。
学习目标
- 理解 RANSAC 如何从含错配的对应点中寻找一致模型。
- 会设置重投影阈值、最大迭代次数与置信度。
- 会根据内点数量、内点率和空间分布判断模型是否可信。
RANSAC 如何剔除错配
估计平面单应性至少需要 4 组不共线点。RANSAC 每轮随机取最小样本拟合候选矩阵,再把所有匹配投影到目标图,重投影误差不超过阈值的记为内点,最终保留支持点最多且误差较小的模型。
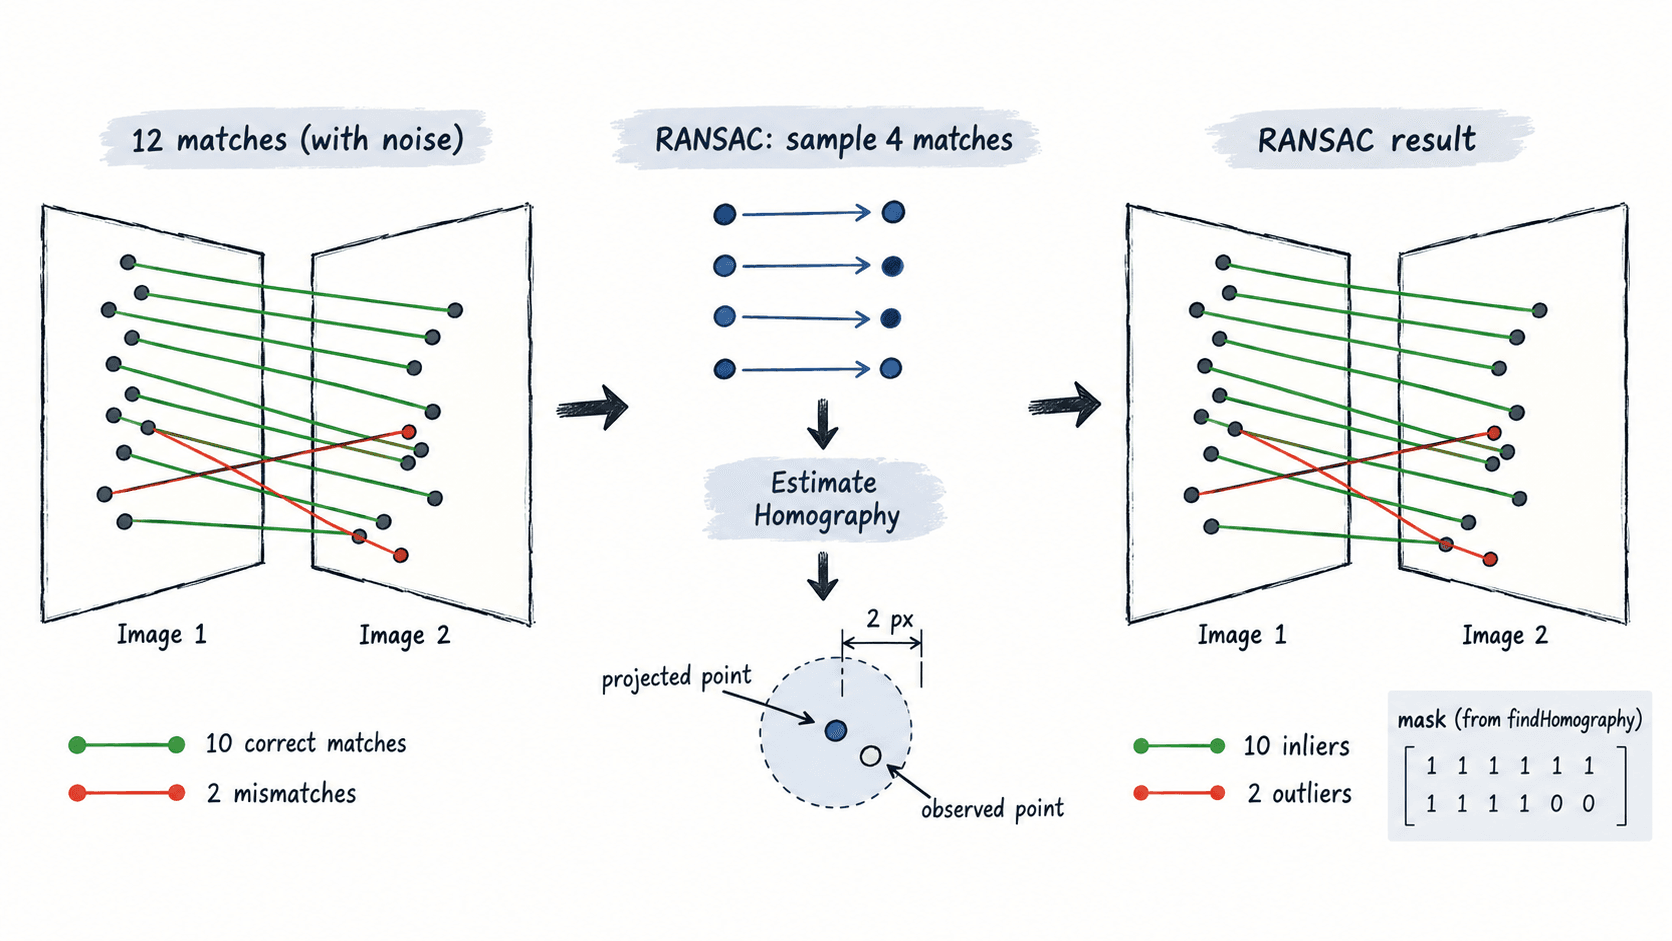
例如 12 组匹配中有 10 组满足同一变换、2 组完全错误,RANSAC 可以在阈值足够小的情况下稳定找回那 10 组。对单应性而言,4 个点若几乎共线,即使数量够也会使模型退化,因此还要关注点是否覆盖目标区域。
参数怎么设
ransacReprojThreshold 的单位是目标图像像素。对 1 倍分辨率、定位较准的 ORB 或 SIFT 匹配,可先从 2~4 px 试起;设成 10 px 往往会把明显错配也收进来,设成 0.5 px 又可能误杀正常定位误差。
| 参数 | 常用起点 | 调整依据 |
|---|---|---|
ransacReprojThreshold |
3.0 px | 关键点噪声大时增大,精确定位时减小 |
maxIters |
2000 | 离群点很多时提高,运行时间受限时降低 |
confidence |
0.995 | 通常保留默认高置信度,不要设为 1.0 |
若真实内点率约为 70%,单应性每次抽 4 点,在 99.5% 置信度下理论上约需 20 次成功覆盖一个全内点样本;内点率降到 30% 时则会上升到约 652 次,所以先做描述子距离筛选能显著减轻 RANSAC 压力。
可运行示例
下面示例适用于 OpenCV 4.x。前 10 组点由同一个透视矩阵生成,最后 2 组故意改成错误位置;RANSAC 应识别 10 个内点,并把错误匹配标成 0。
import cv2
import numpy as np

src = np.float32([
    [0, 0], [100, 0], [200, 0], [0, 100], [100, 100], [200, 100],
    [0, 200], [100, 200], [200, 200], [50, 150], [250, 50], [250, 200]
])

h_true = np.float64([
    [1.10, 0.05, 30.0],
    [0.02, 1.05, 20.0],
    [0.0003, 0.0002, 1.0]
])

# 先用真实模型生成一致点,再人为制造两个离群点。
homogeneous = np.hstack([src.astype(np.float64), np.ones((len(src), 1))])
projected = (h_true @ homogeneous.T).T
dst = (projected[:, :2] / projected[:, 2:]).astype(np.float32)
dst[-2] = [20, 260]
dst[-1] = [300, 10]

h, mask = cv2.findHomography(
    src, dst, cv2.RANSAC, 2.0, maxIters=2000, confidence=0.995
)

pred = cv2.perspectiveTransform(src.reshape(-1, 1, 2), h).reshape(-1, 2)
errors = np.linalg.norm(pred - dst, axis=1)
inlier_mask = mask.ravel().astype(bool)

print(f"inliers: {int(inlier_mask.sum())} / {len(src)}")
print(f"max_inlier_error < 0.01: {errors[inlier_mask].max() < 0.01}")
预期输出:
inliers: 10 / 12
max_inlier_error < 0.01: True
这里不要用 h 去解释被标为离群点的匹配,因为模型本来就不会拟合它们。真正要传给后续定位或姿态估计的是 mask.ravel() == 1 对应的那批匹配。
怎样判断结果能不能继续用
仅看“找到了矩阵”不够。实际项目可先设三条门槛:内点至少 10~15 个、内点率至少 50%、内点在目标上的包围区域覆盖面积至少达到目标面积的 20%。例如 40 个内点全挤在一个 Logo 角落,仍可能得到数值可用但外推很差的单应性。
常见错误是把描述子距离筛选和 RANSAC 当成二选一。正确顺序是先用 KNN 比值测试或距离阈值去掉明显错误匹配,再用 RANSAC 检查几何一致性;若最终内点率低于 30%,优先检查重复纹理、尺度变化和匹配策略,而不是继续把重投影阈值放宽到十几像素。