
计算机视觉 / 系统课时
优化实时处理性能
优化实时处理性能
实时视觉卡顿时,先量化每帧耗时,再减少输入像素和重复计算,最后才比较 OpenCV 的 CPU、OpenCL 或 CUDA 路径。本篇给出可直接运行的基准脚本,并用 30 FPS 的 33.3 ms 帧预算判断优化是否真的有效。
学习目标
- 用统一输入、预热和多次循环测量单帧处理耗时。
- 通过缩放、缓存与减少重复转换降低每帧计算量。
- 用同一模型和同一输入比较 CPU 与可用加速后端,避免只看理论规格。
先建立可比较的基线
实时性能必须以“单帧端到端耗时”衡量。30 FPS 的帧预算约为 33.3 ms,60 FPS 约为 16.7 ms。测量时固定输入内容、分辨率和参数,并先预热 10~20 次,避免首次调用的缓存、线程初始化影响结果。
下面脚本用同一张 1920×1080 随机图像,分别处理 1920×1080、960×540 和 640×360,流程包含缩放、灰度化、5×5 高斯模糊与 Canny。cv2.setUseOptimized(True) 会启用 OpenCV 构建中可用的优化代码路径。
import time
import cv2
import numpy as np

def process(frame, size):
    resized = cv2.resize(frame, size, interpolation=cv2.INTER_AREA)
    gray = cv2.cvtColor(resized, cv2.COLOR_BGR2GRAY)
    blurred = cv2.GaussianBlur(gray, (5, 5), 0)
    return cv2.Canny(blurred, 100, 200)

def benchmark(frame, size, runs=200):
    for _ in range(20):
        process(frame, size)

    start = time.perf_counter()
    for _ in range(runs):
        process(frame, size)
    elapsed = time.perf_counter() - start
    return elapsed * 1000 / runs

def main():
    cv2.setUseOptimized(True)
    rng = np.random.default_rng(42)
    frame = rng.integers(0, 256, (1080, 1920, 3), dtype=np.uint8)

    print(f"useOptimized={cv2.useOptimized()}")
    for size in [(1920, 1080), (960, 540), (640, 360)]:
        avg_ms = benchmark(frame, size)
        print(f"{size[0]}x{size[1]} avg={avg_ms:.2f} ms")

if __name__ == "__main__":
    main()
预期输出
useOptimized=True
1920x1080 avg=<TIME> ms
960x540 avg=<TIME> ms
640x360 avg=<TIME> ms
<TIME> 会随 CPU、OpenCV 构建和线程状态变化。重点不是某个固定数字,而是三组数据必须来自同一机器与同一脚本;若 640×360 仍比 1920×1080 慢,应先检查后台负载和是否误把其他工作放进循环。
先减少像素和重复计算
像素数通常比“换一个算法名字”更直接。1920×1080 有约 207 万像素,960×540 约 52 万,640×360 约 23 万;若算法近似逐像素执行,缩到 640×360 后理论工作量只有原图约 11%。
实时项目可采用“低分辨率分析、高分辨率显示”:相机保留 1280×720,算法输入缩为 640×360。若检测框在小图上是 (100, 50, 300, 200),映射回原图时横纵坐标各乘 2,得到 (200, 100, 600, 400)。
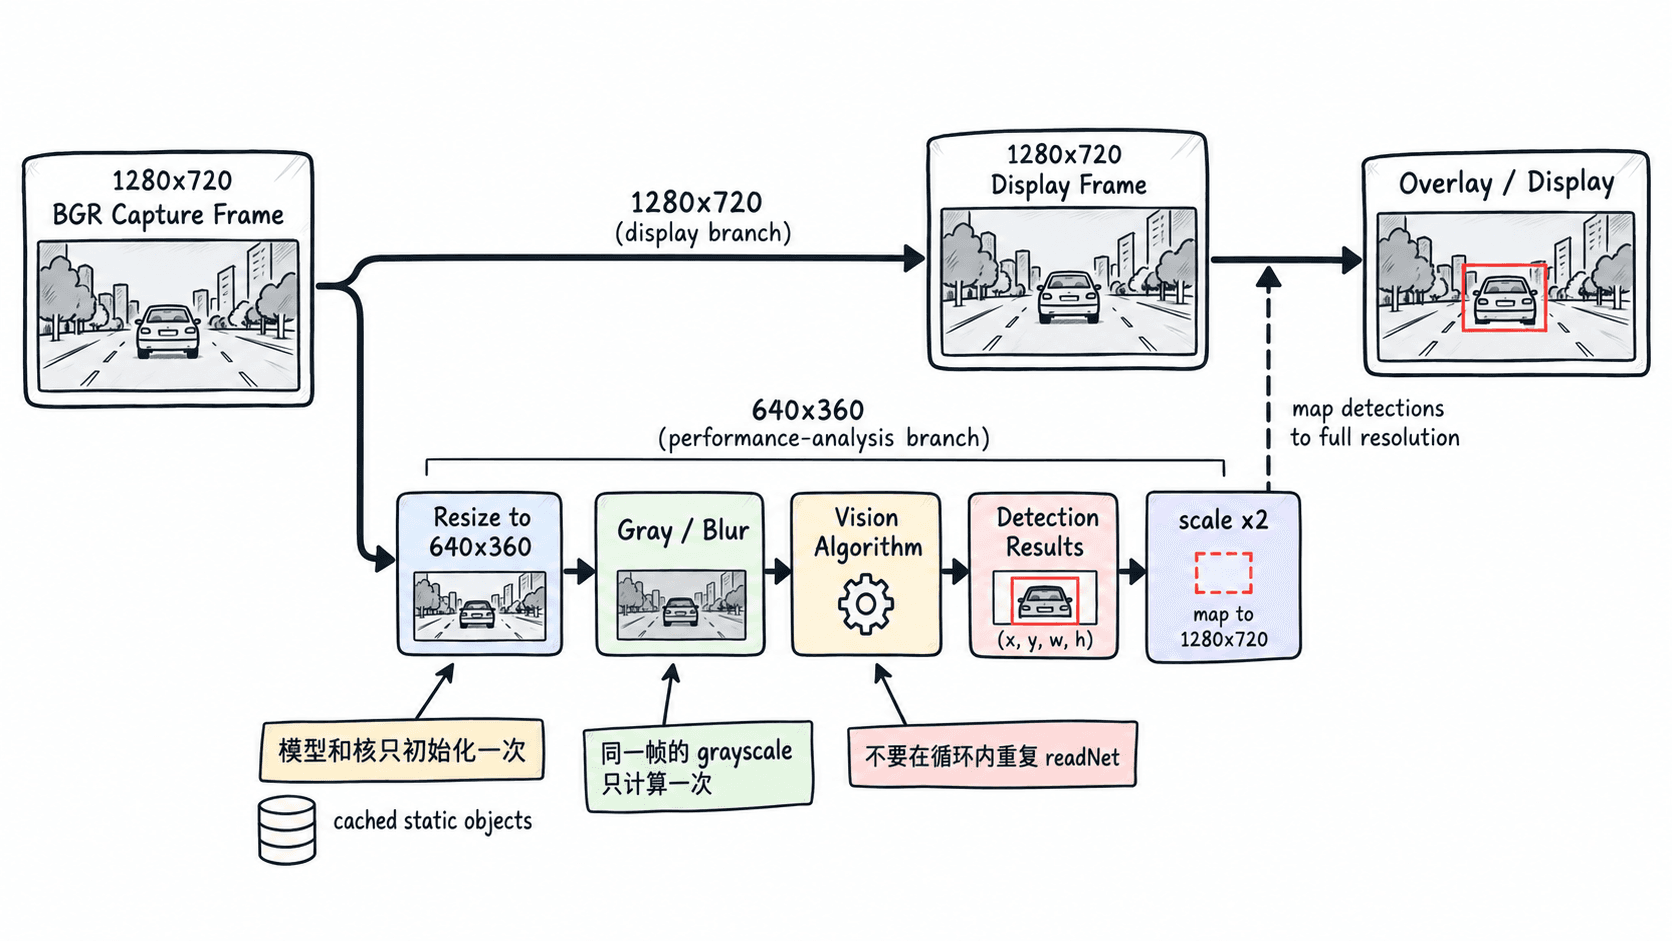
还要把只需初始化一次的对象移出帧循环,例如 DNN 模型、形态学核、固定查找表和静态掩膜。错误做法是在每帧执行 cv2.dnn.readNet(...);正确做法是启动时创建 Net,循环里只做 setInput() 和 forward()。
比较 CPU 与加速后端
DNN 性能比较必须保持模型、blob、输入尺寸和后处理完全一致。基线可用 cv2.dnn.DNN_BACKEND_OPENCV 配 cv2.dnn.DNN_TARGET_CPU;若 cv2.ocl.haveOpenCL() 为真,可再测试 DNN_TARGET_OPENCL。CUDA 只在安装了带 CUDA DNN 支持的 OpenCV 构建时测试 DNN_BACKEND_CUDA 与 DNN_TARGET_CUDA。
每种配置先执行 10 次 forward() 预热,再记录至少 100 次推理耗时,并单独统计预处理和后处理。若 CPU 推理 18 ms、预处理 4 ms、后处理 3 ms,总计 25 ms;换后端后推理降到 10 ms,但数据搬运让预处理变成 8 ms,总计只降到 21 ms,真实收益是 4 ms 而不是 8 ms。
用帧预算验收优化
把每帧拆成 Capture、Preprocess、Algorithm、Postprocess、Display 五段分别计时,并同时看平均值与较慢帧。30 FPS 下若五段平均耗时分别为 4、5、15、3、4 ms,总计 31 ms,平均值可达标;若偶发帧达到 45 ms,画面仍会明显顿一下。
验收时至少连续跑 500~1000 帧,并记录处理 FPS、平均耗时和最大或 P95 耗时。若算法本身已低于预算但画面仍延迟,检查是否在队列中积压旧帧;实时预览更适合只保留“最新一帧”,而不是把每一帧都排队等待处理。