
计算机视觉 / 系统课时
认识计算机视觉
认识计算机视觉
计算机视觉要解决的不是“把图片变漂亮”,而是让程序从图像或视频中得到可判断、可定位、可测量的信息。理解输入、任务和输出之间的对应关系后,你就能判断一个需求究竟属于图像处理、目标检测、分割还是跟踪。
学习目标
- 能用输入与输出形式区分分类、检测、分割、关键点和跟踪任务。
- 能说明图像处理与计算机视觉的关系,并把二者放进同一条处理链。
- 能把业务描述改写成可验收的视觉任务指标。
从像素到可行动的信息
一张 1920×1080 的彩色图像对程序来说首先是像素矩阵。视觉系统真正需要交付的是更高层结果,例如“这是什么”“在哪里”“每个像素属于什么”“同一目标在下一帧去了哪里”。任务类型应由输出决定,而不是由输入图片的内容决定。
| 任务 | 典型输入 | 典型输出 | 可直接检查的结果 |
|---|---|---|---|
| 图像分类 | 一张图片 | 类别与置信度 | cat, 0.94 |
| 目标检测 | 一张图片 | 类别、置信度、矩形框 | 3 个 person 框 |
| 语义分割 | 一张图片 | 与原图同尺寸的类别掩码 | 每个像素都有类别 |
| 实例分割 | 一张图片 | 每个实例独立掩码 | 两辆车分别编号 |
| 关键点检测 | 人脸或人体图像 | 一组坐标点 | 17 个人体关键点 |
| 多目标跟踪 | 连续视频帧 | 目标位置与持续 ID | person-12 连续出现 |
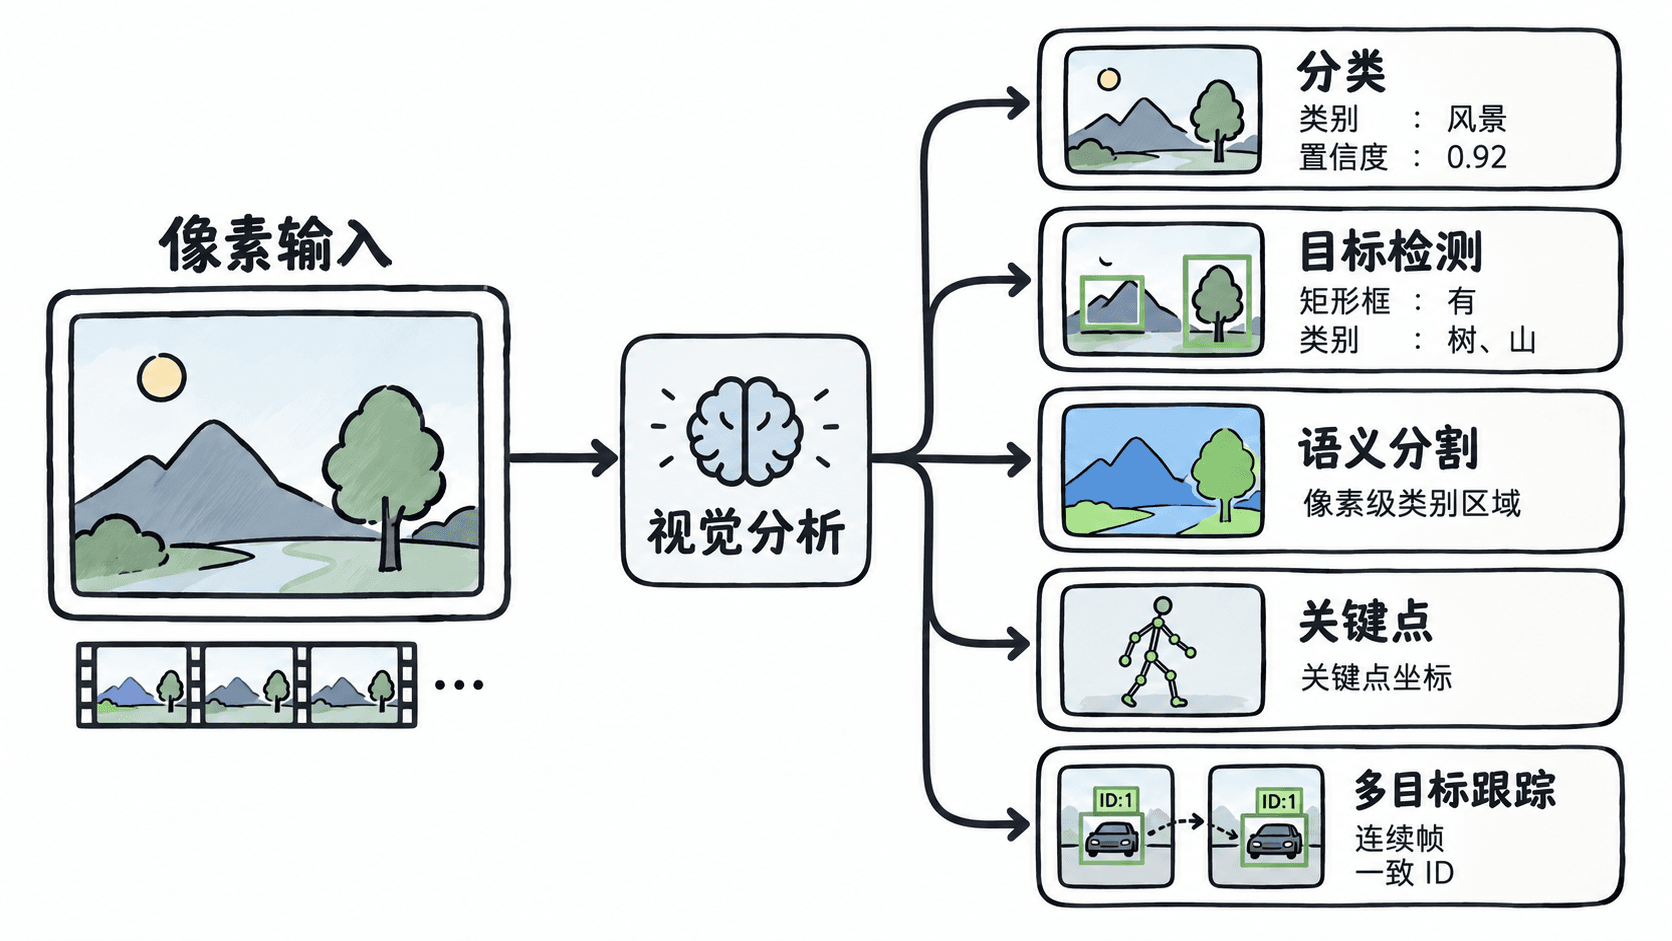
图像处理和视觉任务怎样衔接
图像处理通常改变像素本身,计算机视觉则从像素中推断结构或语义。以票据识别为例,可以先做灰度化、去噪、二值化和透视校正,再定位文字区域并识别字符。前四步主要改善或规范图像,后两步才回答“文字在哪里、内容是什么”。
一个可检查的处理链可以写成:输入 3000×2000 像素照片,校正后裁成票据区域,再缩放到宽 1600 像素;二值化后检查文字笔画是否连续,最后把 OCR 的字符框映射回票据坐标。若只提高了清晰度却没有产生结构或语义结果,就还停留在图像处理阶段。
用输出形式区分常见任务
假设仓库画面中同时出现 3 名工作人员和 2 辆叉车。如果需求只是判断“画面里是否有叉车”,可以做分类;如果要知道叉车位置,就需要检测;如果要计算叉车实际占用的地面区域,通常需要分割;如果还要统计每辆叉车的停留时间,则要在视频中继续做跟踪。
判断时先问三个问题:最终结果是一个标签、若干坐标,还是整幅像素掩码;结果是否需要区分多个同类实例;结果是否要跨帧保持身份。比如“人数统计”若只需单帧人数,可由检测框计数;若要计算每个人的停留时长,就必须引入跨帧 ID。
把业务需求写成可验收指标
“识别流水线上的缺盖瓶”还不是工程规格。一个可执行的示例可以定义为:相机输出 1280×720、30 FPS;每个瓶盖区域至少覆盖 40×40 像素;系统输出 normal 或 missing_cap;测试集 10,000 个瓶子中漏检不超过 10 个,误剔除不超过 50 个,单帧端到端处理时间低于 33 ms。
这些数字只是示例,不是行业统一标准,但它们能把需求变成可验证条件。数据集必须覆盖正常、缺盖、反光、轻微遮挡和位置偏移等情况;如果只在同一光照下拍 100 张样本,即使准确率很高,也不能说明系统能稳定应对生产现场。
计算机视觉项目最终交付的是可被业务使用的结构化结果。先明确输出,再决定是否需要预处理、检测、分割、关键点、跟踪或多种任务组合,能避免一开始就被某个算法名称带偏。