
机器学习与深度学习 / 系统课时
用 ALS 学出用户与物品因子
用 ALS 学出用户与物品因子
这一节把点击、收藏或购买次数视为隐式反馈,用 ALS 将稀疏的用户—物品矩阵拆成两组低维因子。你会从置信度加权目标函数出发,完成一次可运行训练,并用留出验证集选择潜在维度与正则化强度,而不是只看训练拟合。
学习目标
- 理解隐式反馈 ALS 中偏好、置信度、用户因子和物品因子的关系
- 能解释潜在维度、置信度系数与正则化如何影响拟合和泛化
- 能用验证集比较参数组合,并按统一指标选择模型
隐式反馈不是评分矩阵
隐式场景里,r_ui > 0 通常表示用户对物品发生过行为,但 r_ui = 0 只代表“没有观察到行为”,不能直接解释为“不喜欢”。因此 ALS 会把行为转换为二值偏好 ,再用置信度 表示我们对这个偏好的确信程度。
常见定义是 当且仅当 ,同时令 。行为越强,正样本的损失权重越高;没有行为的位置仍保留基础权重 1,让模型学习“不要把所有未知物品都预测成强偏好”。
模型用用户因子 与物品因子 的点积近似偏好:
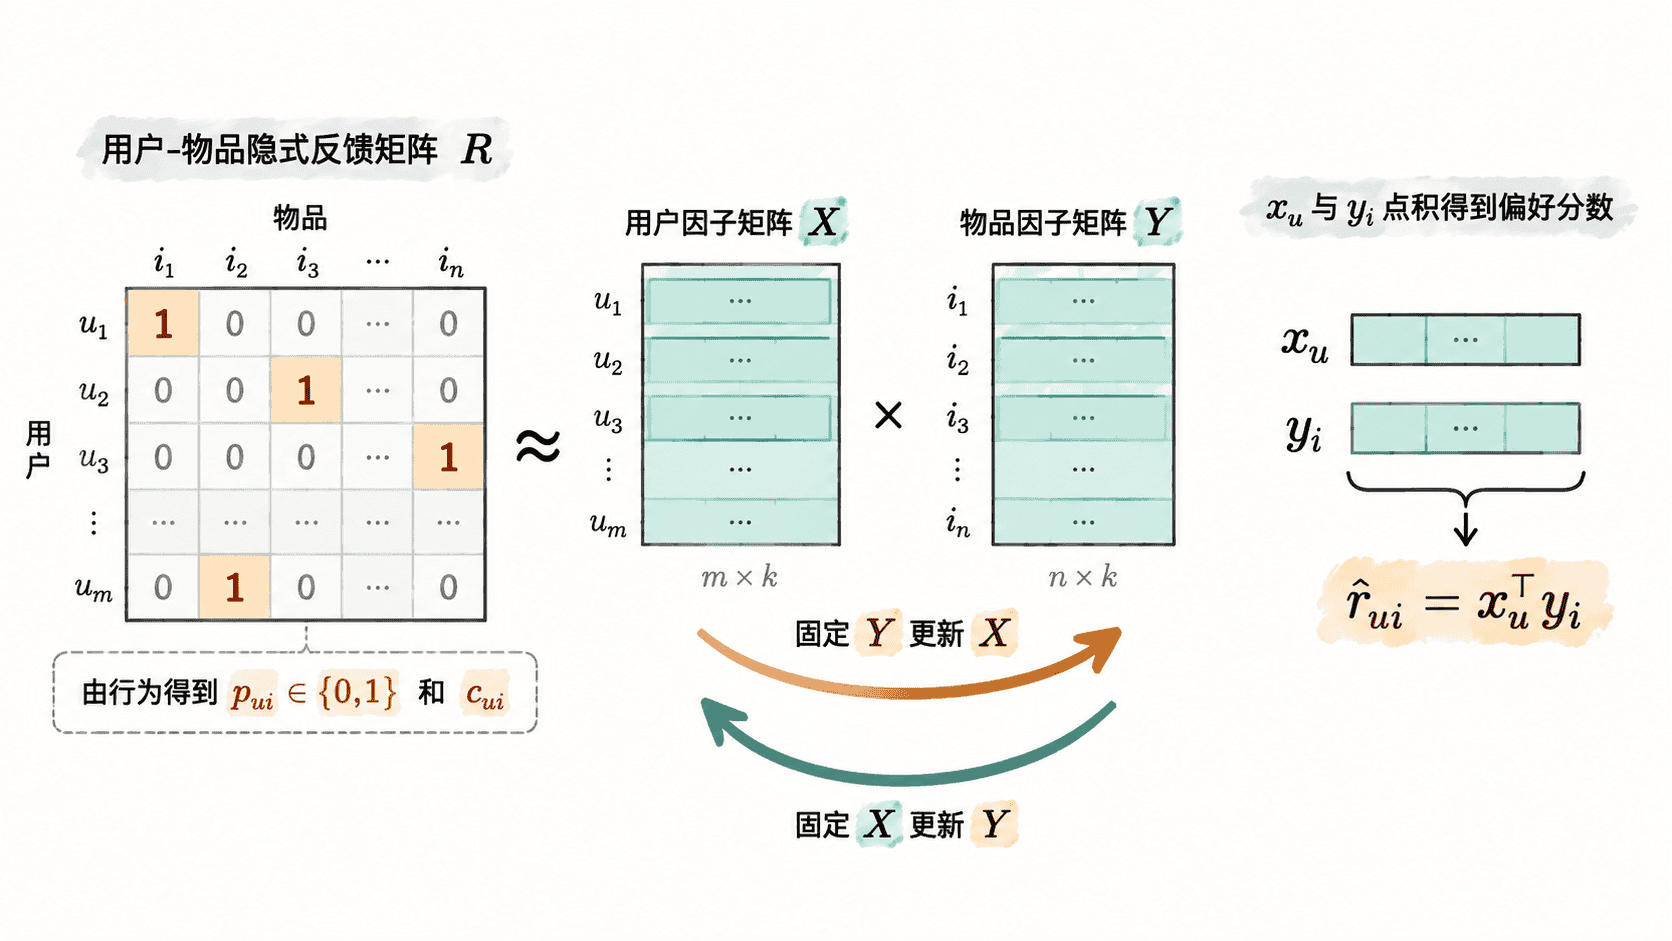
ALS 为什么能交替求解
同时优化 和 不是一个简单的线性问题,但固定其中一组后,另一组就变成带 L2 正则的加权最小二乘。固定物品因子时,每个用户向量可以独立求解;固定用户因子时,每个物品向量也可以独立求解,因此很适合并行训练。
对单个用户,更新式可写成:
潜在维度 factors 越大,模型表达能力越强,同时参数量、计算量和过拟合风险也会上升。正则化 reg 越大,因子会被压得更保守;alpha 则控制“发生过行为”的置信度与未观察位置之间拉开多大差距。
用留出验证集选择参数
下面构造一个小型隐式反馈矩阵,每个用户留出一个已交互物品作为验证目标。训练时看不到这些目标,评估时又会过滤训练集中已经看过的物品,因此 Recall@3 能直接反映候选召回是否命中留出正样本。
import itertools
import numpy as np

R = np.array([
    [3, 2, 0, 0, 1, 0, 0, 0],
    [2, 0, 2, 0, 0, 1, 0, 0],
    [0, 3, 0, 2, 0, 0, 1, 0],
    [0, 0, 3, 2, 0, 0, 0, 1],
    [1, 0, 0, 0, 3, 2, 0, 0],
    [0, 1, 0, 0, 2, 0, 3, 0],
], dtype=float)

heldout = {0: 1, 1: 2, 2: 1, 3: 2, 4: 5, 5: 6}
train = R.copy()
for user_id, item_id in heldout.items():
    train[user_id, item_id] = 0.0

def als_implicit(matrix, factors, reg, alpha=20.0, iterations=12, seed=7):
    rng = np.random.default_rng(seed)
    users, items = matrix.shape
    x = 0.1 * rng.normal(size=(users, factors))
    y = 0.1 * rng.normal(size=(items, factors))
    preference = (matrix > 0).astype(float)
    confidence = 1.0 + alpha * matrix
    eye = np.eye(factors)

    for _ in range(iterations):
        yty = y.T @ y
        for u in range(users):
            c = confidence[u]
            # C_u - I 只在发生过交互的位置增加权重。
            a = yty + (y.T * (c - 1.0)) @ y + reg * eye
            b = y.T @ (c * preference[u])
            x[u] = np.linalg.solve(a, b)

        xtx = x.T @ x
        for i in range(items):
            c = confidence[:, i]
            a = xtx + (x.T * (c - 1.0)) @ x + reg * eye
            b = x.T @ (c * preference[:, i])
            y[i] = np.linalg.solve(a, b)

    return x, y

def recall_at_k(matrix, x, y, targets, k=3):
    hits = 0
    for u, target in targets.items():
        scores = x[u] @ y.T
        # 已在训练集中交互过的物品不能再次进入候选集。
        scores[matrix[u] > 0] = -np.inf
        topk = np.argsort(-scores)[:k]
        hits += int(target in topk)
    return hits / len(targets)

results = []
for factors, reg in itertools.product([2, 3, 4], [0.05, 0.20]):
    x, y = als_implicit(train, factors=factors, reg=reg)
    recall = recall_at_k(train, x, y, heldout)
    results.append((factors, reg, recall))
    print(f"factors={factors}, reg={reg:.2f}, Recall@3={recall:.3f}")

# Recall 相同时优先更强的正则化,降低小样本过拟合风险。
best = max(results, key=lambda row: (row[2], row[1]))
print(f"best=factors={best[0]}, reg={best[1]:.2f}")
预期输出
factors=2, reg=0.05, Recall@3=0.333
factors=2, reg=0.20, Recall@3=0.333
factors=3, reg=0.05, Recall@3=0.500
factors=3, reg=0.20, Recall@3=0.500
factors=4, reg=0.05, Recall@3=0.667
factors=4, reg=0.20, Recall@3=0.667
best=factors=4, reg=0.20
这里两个 factors=4 组合的验证召回相同,所以示例用更强的 reg=0.20 作为保守的并列决胜规则。真实项目不要只试两个正则化值,也不要用测试集调参;应固定验证切分或时间窗,先选参数,最后再用独立测试集报告结果。
三个参数分别在控制什么
factors 决定用户与物品被压缩到多少个潜在方向。太小会欠拟合,很多兴趣被挤在一起;太大则让模型更容易记住稀疏交互,同时增加存储和在线点积成本。
reg 直接抑制因子幅度,是控制泛化的重要旋钮。数据越稀疏、潜在维度越高,通常越需要关注正则化。alpha 不改变“有没有行为”的偏好标签,而是改变行为强度在损失中的话语权;若计数跨度很大,生产中还常先对行为次数做截断或对数缩放。
最终要保存的是训练好的用户因子和物品因子,而不是完整评分矩阵。在线召回时只需计算用户向量与候选物品向量的相似度或点积,再取 Top-K;参数选择则必须以验证集排序指标为准,避免把更高维、更低训练误差误判成更好的推荐模型。