
机器学习与深度学习 / 系统课时
拆开一次推荐请求的完整链路
拆开一次推荐请求的完整链路
一次推荐并不是“输入用户,模型直接给出商品列表”,而是一条从请求进入、生成候选、逐级排序到曝光反馈的处理链。本节把在线请求链路和离线训练链路拆开,并明确每个阶段接收什么数据、产出什么结果。
学习目标
- 说清召回、排序、重排和曝光在一次推荐请求中的职责
- 识别各阶段常见的输入输出数据形态
- 区分在线请求链路与离线训练链路,理解反馈如何连接两者
一次请求如何变成推荐列表
假设首页需要返回 20 条内容。在线系统通常不会让一个复杂模型直接从百万级内容中选择 20 条,而是先快速缩小范围,再逐步使用成本更高、判断更精细的模型。
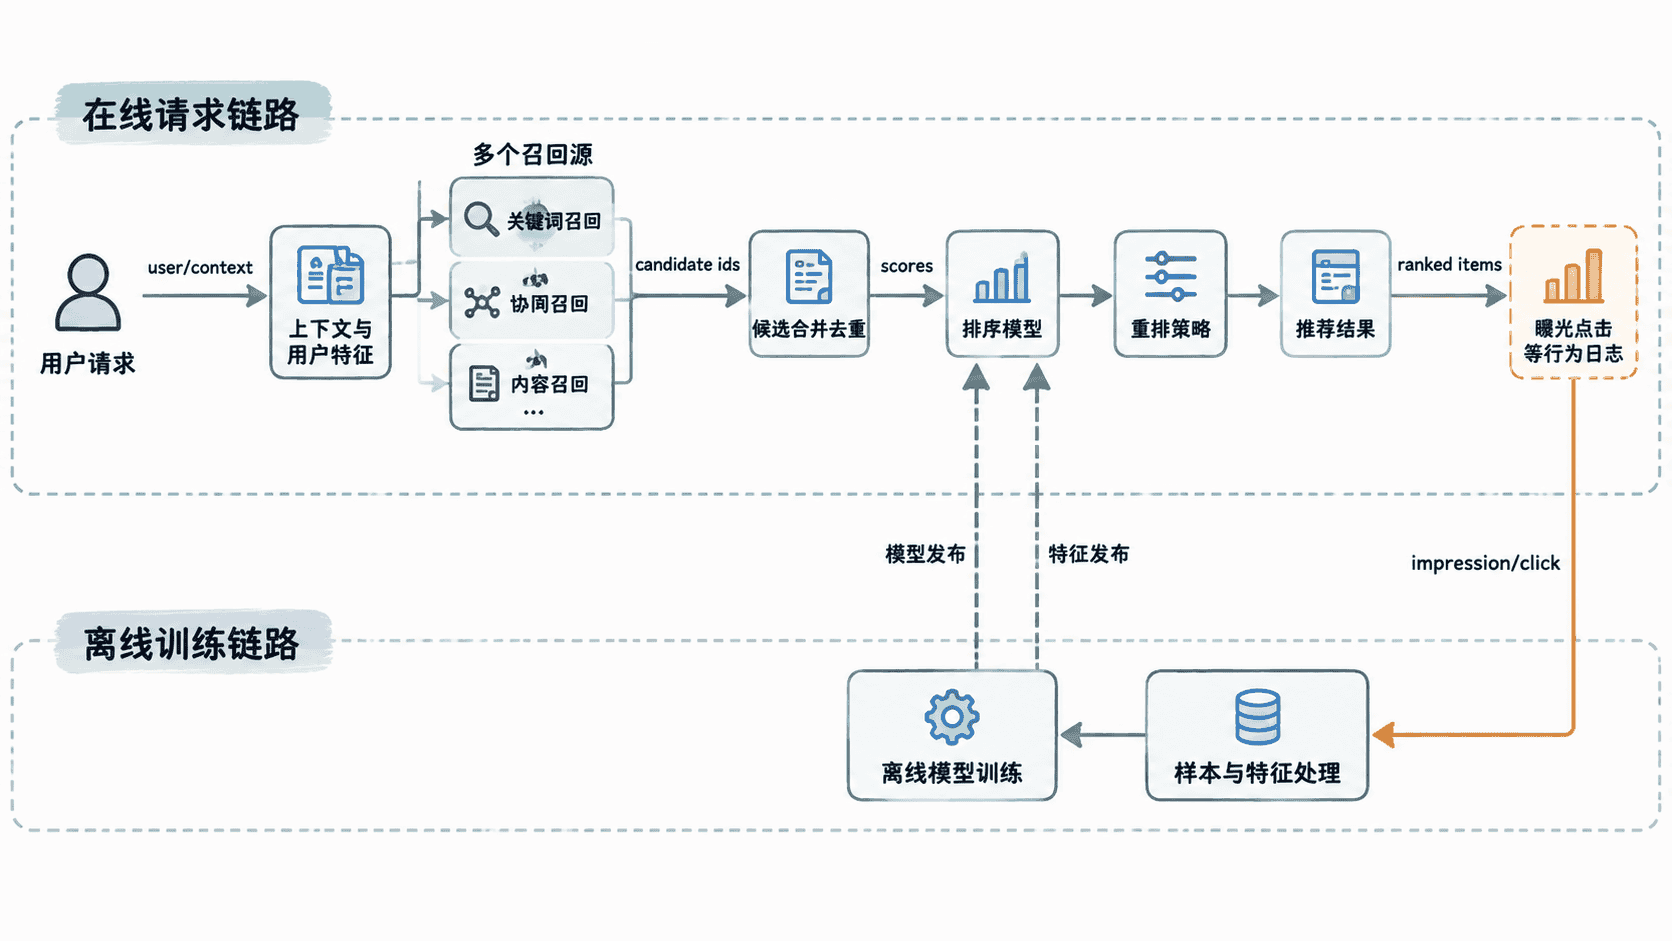
请求刚进入时,系统首先得到用户与场景上下文,例如 user_id、设备、入口、当前时间和已经浏览过的内容。这些信息用于读取用户画像和实时特征,并决定本次应该启用哪些召回策略。
召回阶段解决的是“从海量内容里尽快找出可能相关的一小批”。协同过滤、向量近邻、热门内容或规则召回可以并行工作,各自返回几十到几百个内容 ID。合并、过滤和去重后,系统可能从百万级内容缩小到几百个候选。
排序阶段再为这些候选计算更精细的相关性分数。模型输入通常已经不只是 ID,而是用户特征、内容特征、用户与内容的交叉特征以及请求上下文。输出则是每个候选的预测分数,例如点击概率或综合价值分。
重排并不是再训练一个“更大的排序模型”的同义词。它通常针对最终列表整体施加约束,例如避免连续出现同作者内容、控制类别比例、插入探索内容,或者过滤已经曝光过多次的项目。最终才截取前 20 条返回客户端。
各阶段到底传递什么
同一条推荐链路中,数据会不断从“规模大、信息少”变成“规模小、信息丰富”。理解这种变化,比死记模型名称更重要。
| 阶段 | 典型输入 | 典型输出 | 主要目标 |
|---|---|---|---|
| 请求解析 | 用户 ID、场景、设备、时间 | 请求上下文 | 确定本次推荐条件 |
| 召回 | 用户画像、实时行为、内容索引 | 候选 ID 集合 | 高覆盖、低延迟找候选 |
| 排序 | 候选及用户、内容、上下文特征 | 候选与预测分数 | 判断候选之间的优先级 |
| 重排 | 已排序候选、业务约束 | 最终有序列表 | 兼顾多样性、规则和体验 |
| 曝光反馈 | 推荐列表与用户行为 | 曝光、点击、停留等日志 | 为分析和后续训练提供事实 |
这里最容易混淆的是“候选”和“曝光”。候选进入过排序系统,并不意味着用户真正看见了它;只有客户端实际展示后记录的曝光,才能作为后续点击率计算和训练样本构造的重要依据。
在线链路和训练链路如何配合
在线链路追求的是毫秒到百毫秒级响应,它消费已经准备好的模型、特征和索引,并产生推荐结果。一次请求完成后,它不会现场重新训练模型。
离线训练链路处理的是历史曝光、点击、收藏、停留等行为。日志经过清洗和样本构造后形成训练数据,训练任务再生成新模型。模型通过验证后发布,下一批在线请求才会使用新版本。
两条链路由反馈数据闭环连接:在线系统决定展示什么,用户行为形成日志,日志又影响未来模型。如果曝光策略发生明显变化,采集到的训练数据分布也会随之变化,因此推荐系统不是一个静态模型,而是持续受到自身决策影响的闭环系统。
用一个请求检查自己的理解
设某用户进入首页,三个召回源一共返回 900 条记录,去重后剩 520 条;排序模型为 520 条内容打分;重排过滤已读内容并限制同类连续出现,最后返回 20 条。客户端真正展示了其中前 8 条,用户点击第 3 条。
此时 520 条是进入排序的候选,不是 520 次曝光;返回的 20 条也不一定都已经曝光。若客户端只渲染前 8 条,那么至少应把这 8 条的实际曝光事实与第 3 条的点击事件回传。之后构造训练样本时,才能根据真实展示机会解释用户行为。
设计或排查推荐系统时,可以始终沿着“请求上下文 → 候选 → 分数 → 最终列表 → 实际曝光 → 用户反馈 → 新训练数据”逐段检查。只要每一段的输入、输出和责任边界清楚,后续替换召回算法、排序模型或重排策略时就不会把整条链路混在一起。