
机器学习与深度学习 / 系统课时
抑制热门偏置与反馈回路
抑制热门偏置与反馈回路
推荐系统一旦只按历史点击继续训练,就会把“曾经获得更多曝光”误当成“用户更喜欢”,热门内容因此不断获得更多样本。本节把曝光、点击、再训练拆开,并用逆倾向权重、热门惩罚和长尾配额组成一套可验证的治理方案。
学习目标
- 识别曝光偏置如何通过训练数据形成自增强反馈回路
- 理解逆倾向权重、热门惩罚和长尾配额分别解决什么问题
- 用离线指标和线上护栏判断治理是否过度牺牲短期点击
反馈回路为什么会越滚越大
线上日志并不是“用户对全量内容的真实偏好”,而是“当前推荐策略先展示了一部分内容后,用户对这部分内容产生的反馈”。如果训练时直接把点击率高的内容当作正样本,模型会继续给它们更高排序分,下一轮又获得更多曝光和点击。
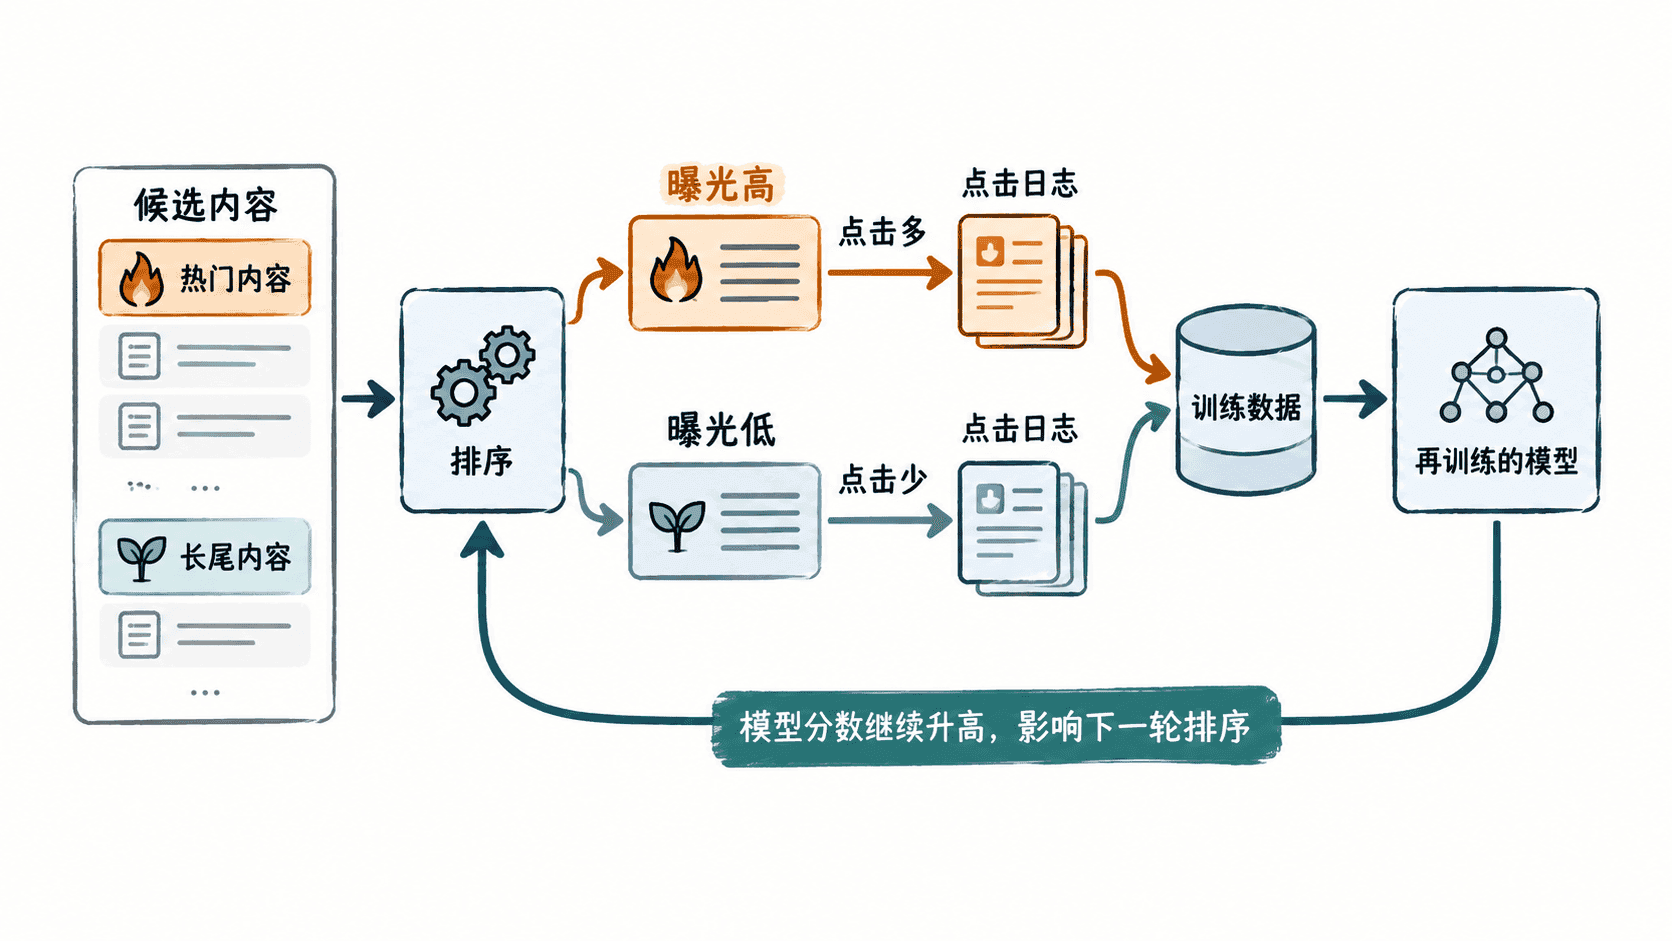
因此,治理对象不是“热门内容本身”,而是数据生成机制。一个内容很热门可能确实因为质量高,也可能只是因为过去被频繁展示。真正要减弱的是“曝光机会不均等”对训练标签和排序结果造成的额外放大。
用倾向概率修正训练样本
设样本被当前策略展示的概率为 。逆倾向权重的基本思想是给低曝光概率样本更高权重,即 ,从而降低“高曝光样本天然占多数”带来的偏差。
实际工程中不能无限放大权重。极小的 会产生巨大方差,所以通常需要裁剪,例如把权重限制在 3 或 5 以内。倾向概率也必须来自可解释的曝光策略、随机桶或可靠估计,不能把排序分数直接当成展示概率。
在重排阶段增加热门惩罚与长尾配额
训练侧修正样本后,线上仍可以在重排阶段加入轻量治理。热门惩罚降低超高曝光内容的边际优势,长尾配额则保证最终列表至少保留一定数量的低曝光候选。两者要作用在相关性排序之后,而不是绕过相关性直接随机塞内容。
下面的可运行示例同时演示三件事:计算裁剪后的逆倾向权重、根据流行度对预测点击率做轻量惩罚,并在 Top 3 中至少保留两个长尾候选。
import math

items = [
    {"id": "A", "propensity": 0.80, "pred_ctr": 0.22, "popularity": 1000, "long_tail": False},
    {"id": "B", "propensity": 0.70, "pred_ctr": 0.20, "popularity": 700, "long_tail": False},
    {"id": "C", "propensity": 0.35, "pred_ctr": 0.18, "popularity": 120, "long_tail": True},
    {"id": "D", "propensity": 0.25, "pred_ctr": 0.17, "popularity": 80, "long_tail": True},
    {"id": "E", "propensity": 0.15, "pred_ctr": 0.16, "popularity": 30, "long_tail": True},
]

for item in items:
    # 训练侧:限制 IPS 权重,避免极小 propensity 放大噪声。
    item["ips_weight"] = min(1.0 / item["propensity"], 3.0)
    # 排序侧:对过高流行度施加平滑惩罚,而不是直接屏蔽热门内容。
    item["adjusted"] = item["pred_ctr"] - 0.05 * math.log1p(item["popularity"]) / 10

TOP_K = 3
MIN_TAIL = 2

tail_candidates = sorted(
    [x for x in items if x["long_tail"]],
    key=lambda x: x["adjusted"],
    reverse=True,
)
selected = tail_candidates[:MIN_TAIL]

selected_ids = {x["id"] for x in selected}
remaining = sorted(
    [x for x in items if x["id"] not in selected_ids],
    key=lambda x: x["adjusted"],
    reverse=True,
)
selected.extend(remaining[: TOP_K - len(selected)])
selected.sort(key=lambda x: x["adjusted"], reverse=True)

for item in items:
    print(f'{item["id"]} ips={item["ips_weight"]:.2f} adjusted={item["adjusted"]:.4f}')
print("final_top3:", ",".join(x["id"] for x in selected))
预期输出:
A ips=1.25 adjusted=0.1855
B ips=1.43 adjusted=0.1672
C ips=2.86 adjusted=0.1560
D ips=3.00 adjusted=0.1480
E ips=3.00 adjusted=0.1428
final_top3: A,C,D
这个例子故意没有把热门候选 A 全部排除,因为治理目标是减弱不公平放大,而不是反向制造“热门歧视”。真实系统中,惩罚系数和长尾配额都应按场景、用户意图和页面容量分桶配置。
用双目标指标验证治理强度
只看 CTR 很容易把治理策略判成“效果变差”,因为探索长尾通常会牺牲一部分短期点击。至少要同时观察短期收益和分布改善:CTR、转化率或停留时长代表业务收益;曝光集中度、长尾曝光占比、不同内容组覆盖率代表治理效果。
上线时可设置护栏,例如“CTR 相对下降不超过 1%,长尾曝光占比提升至少 10%”。若长尾曝光明显增加但有效行为没有提升,说明配额可能过强;若 CTR 几乎不变但曝光集中度也没有变化,治理可能弱到不足以打破反馈回路。最终应以持续实验确认长期留存、内容生态和短期收益之间的平衡。