
机器学习与深度学习 / 系统课时
用重排同时控制相关性与多样性
用重排同时控制相关性与多样性
排序模型通常只负责回答“用户更可能喜欢哪个物品”,但最终列表还要满足类别不过度集中、来源配额合理、长尾不过早消失等业务要求。本节实现一个可运行的约束重排器,并用指标比较重排前后的收益与代价。
学习目标
- 在模型分数之后加入类别、来源和多样性约束
- 比较重排前后的相关性、覆盖率与列表重复度
- 检查业务规则是否意外挤压长尾物品曝光
重排要解决的冲突
如果直接按照模型分数取 Top K,高分物品可能集中在同一类别或同一来源。列表虽然“相关”,但用户看到的内容高度相似,业务流量也容易被头部来源占满。
重排的目标不是推翻排序模型,而是在保留模型分数价值的同时,对最终 Top K 施加约束。一个常见做法是每轮从尚未选择的候选中重新计算分数:原始相关性越高越有利,已经出现较多的类别则受到多样性惩罚,同时不允许突破类别和来源的硬配额。
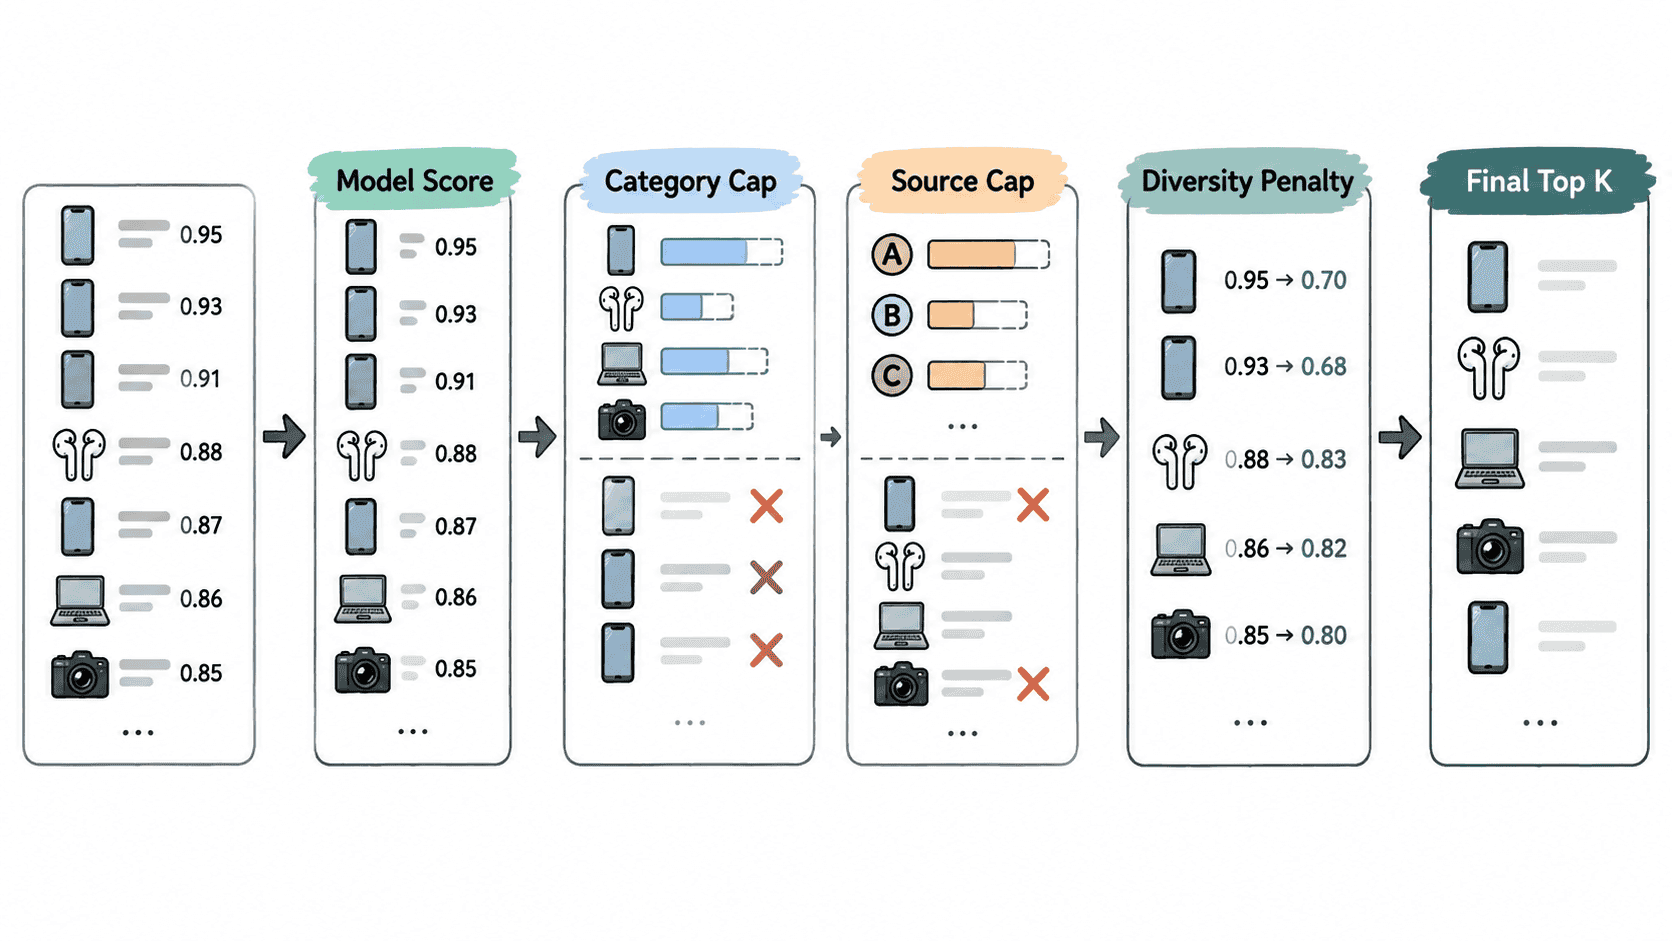
类别去重不一定意味着“每个类别只能出现一次”。真实列表中更常见的是给类别设置上限,例如 Top 5 中同类最多出现 2 个,否则可能为了形式上的多样性牺牲太多相关性。来源配额也应使用相同思路,把硬规则控制在真正不可突破的边界上。
把约束写进重排器
下面使用一个贪心重排器。每轮先排除已经超过类别或来源配额的候选,再用“模型分数减去类别重复惩罚”选择当前最优项。示例中的来源分为热门、广告和长尾,便于同时观察流量分配变化。
from collections import Counter
from dataclasses import dataclass


@dataclass(frozen=True)
class Item:
    item_id: str
    score: float
    category: str
    source: str


def rerank(candidates, k, category_limit=2, source_limit=3, diversity_weight=0.05):
    selected = []
    category_count = Counter()
    source_count = Counter()

    while len(selected) < k:
        # 硬约束先过滤,避免最终结果突破类别或来源配额。
        feasible = [
            item for item in candidates
            if item not in selected
            and category_count[item.category] < category_limit
            and source_count[item.source] < source_limit
        ]
        if not feasible:
            break

        # 已出现过的类别获得惩罚,让新类别在分数接近时更容易进入列表。
        best = max(
            feasible,
            key=lambda item: item.score - diversity_weight * category_count[item.category],
        )
        selected.append(best)
        category_count[best.category] += 1
        source_count[best.source] += 1

    return selected


def metrics(items):
    categories = {item.category for item in items}
    relevance = sum(item.score for item in items) / len(items)
    repeat_rate = 1 - len(categories) / len(items)
    long_tail_share = sum(item.source == '长尾' for item in items) / len(items)
    return relevance, len(categories), repeat_rate, long_tail_share


def show(label, items):
    relevance, coverage, repeat_rate, long_tail_share = metrics(items)
    ids = ','.join(item.item_id for item in items)
    print(
        f'{label} items={ids} relevance={relevance:.3f} '
        f'coverage={coverage} repeat={repeat_rate:.3f} '
        f'long_tail={long_tail_share:.3f}'
    )


def main():
    candidates = [
        Item('A', 0.98, '手机', '热门'),
        Item('B', 0.95, '手机', '热门'),
        Item('C', 0.92, '手机', '广告'),
        Item('D', 0.90, '耳机', '热门'),
        Item('E', 0.88, '电脑', '长尾'),
        Item('F', 0.86, '耳机', '长尾'),
        Item('G', 0.84, '相机', '长尾'),
        Item('H', 0.82, '电脑', '热门'),
    ]

    before = candidates[:5]
    after = rerank(candidates, k=5)
    show('before', before)
    show('after ', after)


if __name__ == '__main__':
    main()
预期输出
before items=A,B,C,D,E relevance=0.926 coverage=3 repeat=0.400 long_tail=0.200
after  items=A,D,B,E,G relevance=0.910 coverage=4 repeat=0.200 long_tail=0.400
这个结果体现了典型的重排取舍:平均模型分数从 0.926 降到 0.910,但类别覆盖从 3 提升到 4,重复度从 0.400 降到 0.200,长尾来源占比从 20% 提升到 40%。重排是否值得,不能只看某一个指标,而要确认相关性损失处于业务可以接受的范围。
避免业务规则误伤长尾
业务规则最危险的地方,是它可能在没有显式报错的情况下改变曝光结构。例如规定“某来源最多 1 个”,如果长尾物品恰好都由同一召回源产生,就会把本来可以竞争的长尾候选批量挡掉;反过来,头部来源配额过宽又可能让多样性规则失效。
因此上线重排时至少要同时记录模型分数均值、类别覆盖、列表重复度以及不同来源的曝光占比。更稳妥的做法是进一步按头部与长尾、用户活跃度和内容类别分桶观察,而不是只看全站平均值。
重排层应当承担“有限约束下优化最终列表”的职责:模型分数仍是主信号,类别与来源规则负责守住边界,多样性惩罚只在候选质量接近时推动列表展开。这样才能在相关性、多样性和曝光公平之间形成可监控、可调节的平衡。