
机器学习与深度学习 / 系统课时
设计负采样避免样本失衡
设计负采样避免样本失衡
排序训练里,正样本通常远少于负样本,直接把所有未点击都当负例会让模型学会“几乎都判负”。本节用一个可运行实验比较随机负采样、曝光未点和难负例,并说明如何保存采样概率与权重,避免离线指标被采样方式误导。
学习目标
- 区分随机负例、曝光未点负例和难负例各自代表的信号
- 设计可控的正负比例,并为被采样样本保留采样概率与训练权重
- 同时用 AUC 与 NDCG@K 判断采样策略是否真的改善排序
为什么负例不能随便抽
推荐日志里的“未点击”并不天然等于“不喜欢”。用户根本没看到的物品,只能说明系统没有展示;曝光后未点击,才包含更直接的负反馈。如果把大量未曝光物品全部塞进训练集,模型会遇到数量巨大、区分又很容易的负例,训练损失很快下降,但前排候选之间的细粒度差异学得不够。
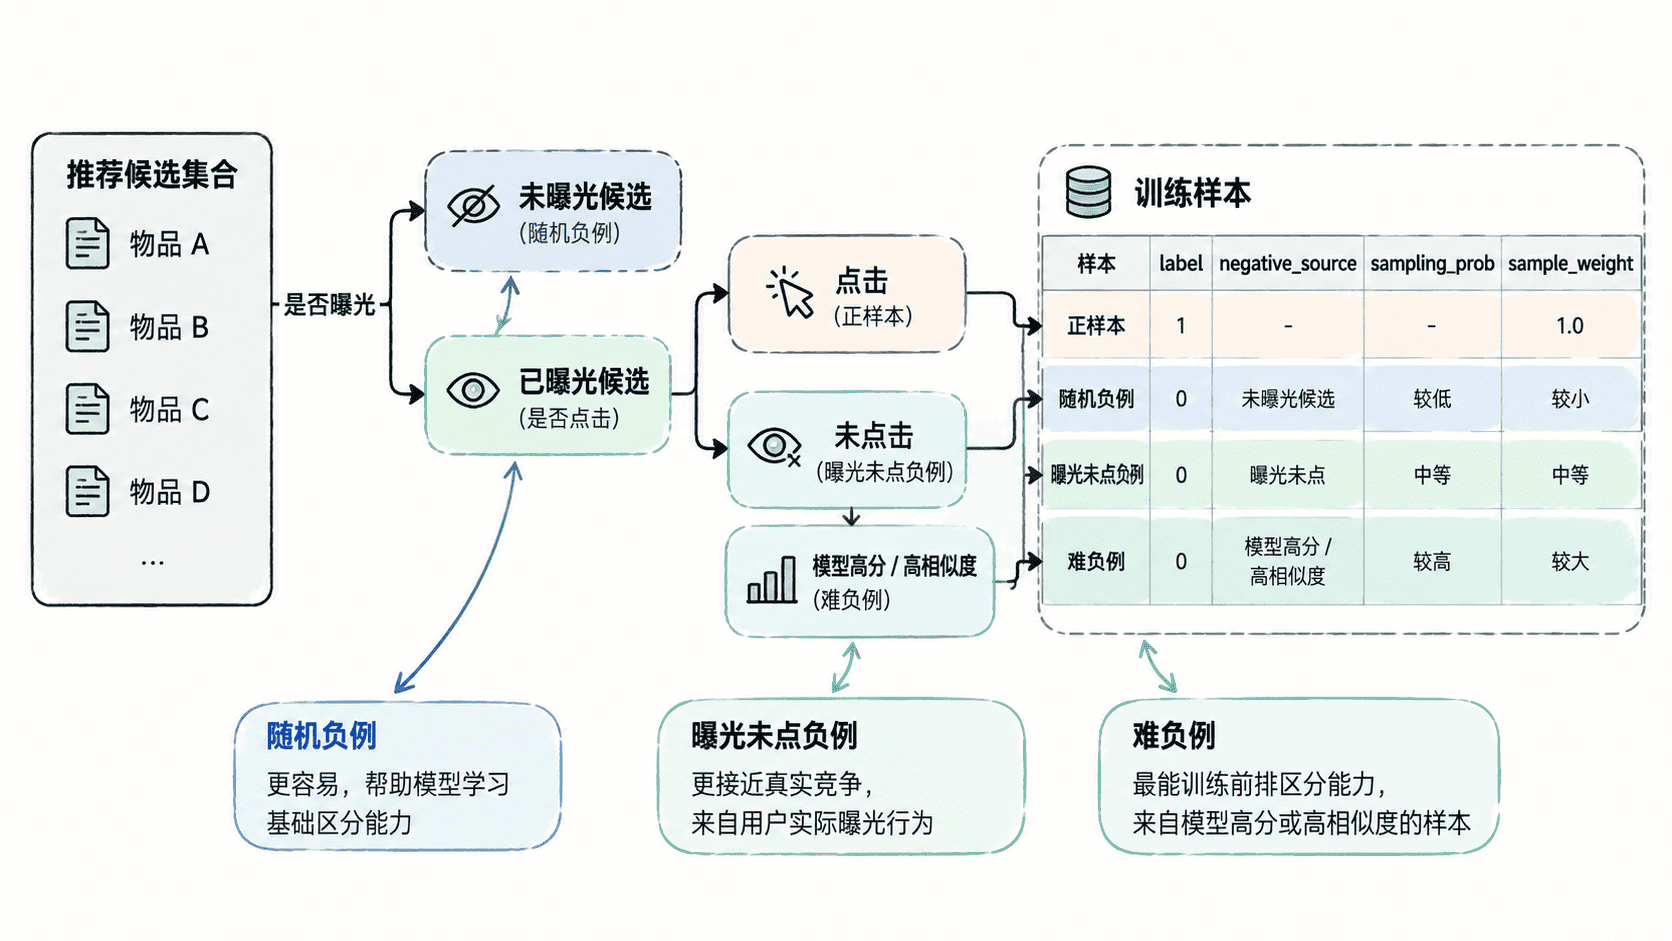
三种常见策略关注点不同:
| 策略 | 负例来源 | 优点 | 主要风险 |
|---|---|---|---|
| 随机负采样 | 未点击或未曝光池随机抽取 | 成本低、覆盖广 | 大量“太容易”的负例,和线上竞争分布差异大 |
| 曝光未点 | 用户真实看过但没点 | 反馈更可信 | 会受曝光策略本身影响,存在位置偏差 |
| 难负例 | 高召回分、高相似度却未点 | 强化前排区分能力 | 过多会放大噪声,甚至把潜在正例当负例 |
工程上通常不会三选一,而是混合。先保留曝光未点作为主体,再补少量随机负例扩大覆盖,最后控制难负例占比。正负比例没有固定答案,可以从 1:3 到 1:10 做小规模搜索,但验证集必须保持更接近真实线上分布,不能跟训练集一起被同样采样。
采样权重为什么要保存
假设某类负例被抽中的概率是 。如果训练时想近似恢复它在原始样本空间中的贡献,可以记录逆采样概率权重 。实际训练前常会再做归一化或裁剪,避免极少数低采样概率样本产生过大的梯度。
至少应把 negative_source、sampling_prob 和最终 sample_weight 一起落到训练样本中。这样后续才能回答“这个样本为什么进来了”“某类负例是否被过度放大”,也方便重新计算权重,而不是只能重新跑整套采样任务。
用最小实验比较 AUC 与 TopK
下面构造一批正样本、曝光未点样本和未曝光随机样本,再分别训练逻辑回归。示例数据很小,目的是观察采样策略如何改变模型,不代表真实业务应该得到同样的数值。为了可复现,所谓“随机负例”在代码里固定选择了四条样本。
import numpy as np
import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import ndcg_score, roc_auc_score

train_pool = pd.DataFrame([
    (1, 1, 0.95, 0.70, 0), (1, 1, 0.90, 0.60, 0),
    (1, 1, 0.85, 0.80, 0), (1, 1, 0.80, 0.55, 0),
    (0, 1, 0.78, 0.75, 1), (0, 1, 0.74, 0.68, 1),
    (0, 1, 0.70, 0.50, 1), (0, 1, 0.65, 0.72, 1),
    (0, 1, 0.55, 0.60, 0), (0, 1, 0.45, 0.40, 0),
    (0, 1, 0.35, 0.30, 0), (0, 1, 0.25, 0.20, 0),
    (0, 0, 0.10, 0.10, 0), (0, 0, 0.15, 0.15, 0),
    (0, 0, 0.20, 0.25, 0), (0, 0, 0.12, 0.35, 0),
    (0, 0, 0.18, 0.45, 0), (0, 0, 0.22, 0.50, 0),
    (0, 0, 0.08, 0.55, 0), (0, 0, 0.05, 0.65, 0),
], columns=["label", "exposed", "affinity", "popularity", "hard"])

validation = pd.DataFrame([
    (1, 0.92, 0.65), (0, 0.80, 0.75), (1, 0.78, 0.55),
    (0, 0.72, 0.70), (0, 0.60, 0.50), (1, 0.58, 0.40),
    (0, 0.50, 0.60), (0, 0.35, 0.30), (0, 0.20, 0.55),
    (0, 0.10, 0.20),
], columns=["label", "affinity", "popularity"])

def evaluate(name, negative_rows, sampling_probs=None):
    positives = train_pool[train_pool["label"] == 1]
    negatives = train_pool.loc[negative_rows]
    train = pd.concat([positives, negatives], ignore_index=True)

    sample_weight = None
    if sampling_probs is not None:
        negative_weight = 1.0 / np.asarray(sampling_probs, dtype=float)
        # 归一化后仍保留相对权重,避免整体损失尺度被放大。
        negative_weight /= negative_weight.mean()
        sample_weight = np.r_[np.ones(len(positives)), negative_weight]

    model = LogisticRegression(
        C=10,
        solver="liblinear",
        random_state=0,
    )
    model.fit(
        train[["affinity", "popularity"]],
        train["label"],
        sample_weight=sample_weight,
    )

    scores = model.predict_proba(
        validation[["affinity", "popularity"]]
    )[:, 1]
    auc = roc_auc_score(validation["label"], scores)
    ndcg5 = ndcg_score(
        [validation["label"].to_numpy()],
        [scores],
        k=5,
    )
    print(f"{name:14s} AUC={auc:.3f} NDCG@5={ndcg5:.3f}")

def main():
    evaluate("random", [12, 13, 14, 15])
    evaluate("exposed", [8, 9, 10, 11])
    evaluate("hard", [4, 5, 6, 7])
    evaluate(
        "mixed-weighted",
        [4, 5, 8, 12],
        sampling_probs=[0.5, 0.5, 1.0, 0.25],
    )

if __name__ == "__main__":
    main()
预期输出
random         AUC=0.714 NDCG@5=0.671
exposed        AUC=0.810 NDCG@5=0.704
hard           AUC=0.905 NDCG@5=0.947
mixed-weighted AUC=0.810 NDCG@5=0.704
这个结果说明两件事:第一,容易的随机负例可能让分类看起来简单,却未必帮助前排排序;第二,难负例在这组数据里明显提高了 TopK 指标,但混合加权并没有继续变好,因此“更复杂的采样”不能凭直觉判优,必须用验证集比较。
训练集落地时的边界
训练集和验证集要按时间切分,避免同一次曝光或同一用户行为泄漏到两边。训练集可以采样,验证集尽量保留自然分布;否则 AUC、NDCG@K、Recall@K 都会被采样器共同扭曲,看不出真实线上收益。
负例比例也不要只看 AUC。随机负例过多时,AUC 可能上涨,但模型对 TopK 候选的顺序没有改善;难负例过多时,TopK 可能短期变好,却可能牺牲长尾覆盖并放大错误标签。稳定做法是固定验证集,逐档比较负例来源、正负比例和权重策略,再把最优候选带到线上 A/B 验证。